Kappale 8 - Teoria
5. Tekoäly merenkulun kyberturvallisuudessa ja ennakoivassa analytiikassa
CKyberturvallisuudesta on tullut keskeinen tekijä merenkulun kriittisten toimintojen, kuten navigoinnin, lastinhallinnan ja viestintäverkkojen, suojaamisessa. Tekoäly (Artificial Intelligence, AI) on noussut merkittäväksi työkaluksi näihin haasteisiin vastaamisessa. Analysoimalla suuria tietomääriä tekoälypohjaiset järjestelmät kykenevät tunnistamaan uhkia aiempaa tarkemmin, nopeuttamaan reagointia ja vähentämään toiminnallisia häiriöitä (Kaur et al., 2023). Tässä luvussa esitellään tekoälyn, koneoppimisen (Machine Learning, ML) ja syväoppimisen (Deep Learning, DL) perusteet, kuvataan koneoppimismallien elinkaari sekä tarkastellaan, miten näitä teknologioita voidaan hyödyntää merenkulun kyberturvallisuuden ja operatiivisen tehokkuuden parantamisessa.
Hyökkäysten havaitsemisen lisäksi tekoäly parantaa alusten suorituskykyä ja energiatehokkuutta analysoimalla aluksen anturidataa ja ennakoimalla mahdollisia mekaanisia vikoja ennen niiden toteutumista (Tu et al., 2018). Tämä mahdollistaa huoltotoimenpiteiden ajoittamisen kustannustehokkaasti ja vähentää odottamattomien laiterikkojen riskiä. Lisäksi tekoäly voi säätää aluksen nopeutta ja reittiä dynaamisesti sääolosuhteiden, lastin määrän tai polttoaineenkulutuksen perusteella, mikä alentaa käyttökustannuksia ja pienentää ympäristövaikutuksia.
Toinen merkittävä sovellusalue on tekoälyyn perustuva visuaalinen valvonta, joka parantaa merenkulun turvallisuutta seuraamalla aluksen sisäisiä toimintoja ja tunnistamalla luvattoman liikkumisen tai poikkeavan käyttäytymisen (Şengönül et al., 2023). Syväoppimismallit, kuten konvoluutioneuroverkot, pystyvät havaitsemaan poikkeamia lastinkäsittelyssä tai tunnistamaan tilanteita, joissa henkilöstö liikkuu rajoitetuilla alueilla. Esimerkiksi robottijärjestelmät voivat purkaa kontteja turvallisesti ja tehokkaasti satunnaisessa järjestyksessä saapuvasta lastista, mikä vähentää manuaaliseen työhön liittyviä riskejä ja parantaa toiminnan tarkkuutta (Mojtahedzadeh et al., 2015).
Tekoälyn, koneoppimisen ja syväoppimisen perusteet
Tekoäly on laaja tietojenkäsittelytieteen osa-alue, jonka tavoitteena on kehittää järjestelmiä, jotka pystyvät suorittamaan tehtäviä, jotka normaalisti vaativat inhimillistä älykkyyttä, kuten kielen ymmärtämistä, hahmontunnistusta tai päätöksentekoa. Varhainen tekoälytutkimus perustui pitkälti niin sanottuihin sääntöpohjaisiin järjestelmiin, joissa asiantuntijat määrittelivät yksityiskohtaisia JOS–NIIN-sääntöjä, kuten kuvassa 23 on esitetty. Kyberturvallisuudessa tällainen sääntö voisi olla esimerkiksi: ”Jos järjestelmä havaitsee useita epäonnistuneita kirjautumisyrityksiä, estä käyttäjän pääsy tilapäisesti.” Sääntöpohjaiset järjestelmät toimivat hyvin tilanteissa, joissa säännöt voidaan määritellä selkeästi, mutta ne ovat heikkoja uusien tai odottamattomien tilanteiden käsittelyssä.
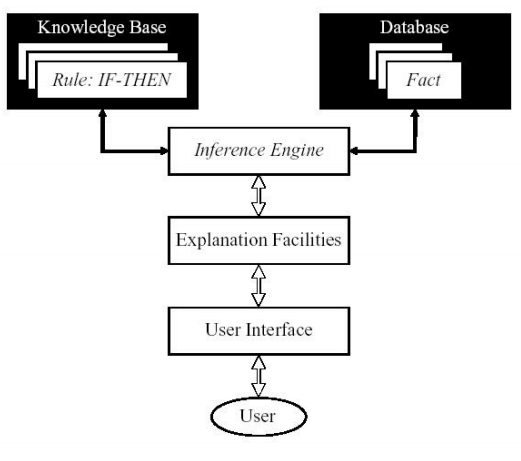
Kuva 23: Tekoälyn sääntöpohjaisen järjestelmän rakenne
(Mojtahedzadeh et al., 2015)
Nykyaikainen tekoäly ei enää perustu pelkästään ennalta kirjoitettuihin sääntöihin, vaan hyödyntää koneoppimista, jonka avulla tietokoneet oppivat datasta ilman, että ne ohjelmoidaan erikseen jokaista mahdollista tilannetta varten. Sen sijaan järjestelmälle annetaan suuria tietomääriä, joita se analysoi tunnistaakseen malleja ja tehdäkseen päätöksiä itsenäisesti. Tämä oppimisprosessi muistuttaa ihmisen oppimista kokemuksen kautta: havainnoidaan esimerkkejä, tunnistetaan yhteyksiä ja kehitetään ymmärrystä ajan myötä. Merenkulussa koneoppimista voidaan hyödyntää esimerkiksi GPS-paikannusdatassa epätavallisten alusten liikkeiden tunnistamiseen, mikä voi viitata luvattomaan toimintaan tai merirosvouksen uhkaan. Analysoimalla reaaliaikaista sijaintidataa ja aiempia poikkeamatapauksia tekoäly pystyy tunnistamaan poikkeamia normaalista käyttäytymisestä ja käynnistämään hälytyksiä ennen kuin turvallisuusriski eskaloituu. Ajan myötä koneoppimismallit tarkentavat ennusteitaan ja mukautuvat uusiin tilanteisiin, mikä tekee niistä entistä tehokkaampia monimutkaisten ja muuttuvien ongelmien käsittelyssä ilman jatkuvaa ihmisen ohjausta.
Koneoppimisessa on useita eri oppimistapoja. Valvotussa oppimisessa järjestelmälle annetaan esimerkkiaineistoa, jossa oikeat vastaukset tai luokat ovat tiedossa. Malli oppii yhdistämään syötteet ja vastaukset siten, että se pystyy tekemään ennusteita uudesta, aiemmin näkemättömästä datasta. Tätä voidaan käyttää luokittelutehtävissä, kuten sen arvioimisessa, onko aluksen viestintä normaalia vai mahdollinen kyberuhka. Sitä voidaan käyttää myös regressiossa, jossa ennustetaan jatkuvia arvoja, kuten polttoaineenkulutusta nopeuden, lastin ja sääolosuhteiden perusteella.
Valvomattomassa oppimisessa järjestelmälle annetaan dataa ilman valmiita luokituksia, ja sen tehtävänä on löytää piileviä rakenteita ja ryhmiä itsenäisesti. Tämä on erityisen hyödyllistä merenkulun kyberturvallisuudessa, kun analysoidaan verkkoliikennettä ja pyritään havaitsemaan poikkeamia, jotka voivat viitata kyberhyökkäykseen. Järjestelmä pystyy erottamaan normaalin ja epänormaalin toiminnan ilman ennakkotietoa siitä, miltä hyökkäys tarkalleen näyttää.
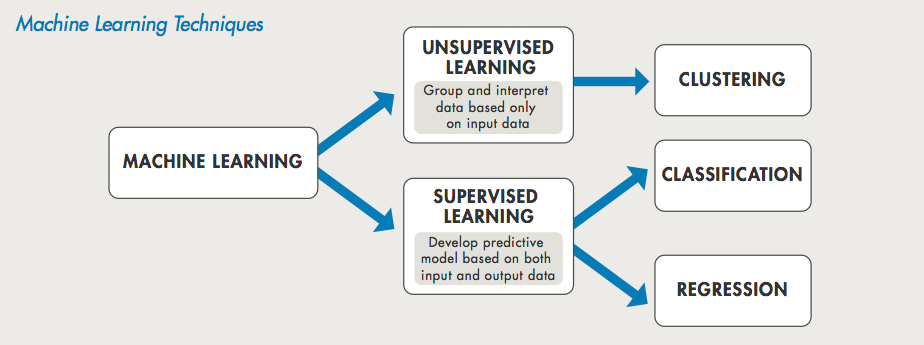
Kuva 24: Koneoppimisen menetelmät
Kolmas lähestymistapa, jota kutsutaan vahvistusoppimiseksi (reinforcement learning, RL), perustuu oppimiseen yrityksen ja erehdyksen kautta. Toisin kuin ohjatussa oppimisessa, jossa järjestelmälle annetaan valmiiksi merkittyjä esimerkkejä oikeista vastauksista, vahvistusoppiminen toimii ympäristössä, jossa järjestelmän on itse löydettävä optimaalinen toimintatapa vuorovaikutuksen avulla. Järjestelmää kutsutaan usein ”agentiksi”, ja se kokeilee erilaisia toimintoja ympäristössä sekä saa palautetta palkkioiden tai rangaistusten muodossa. Palkkio kertoo, että toiminta oli toivottua, kun taas rangaistus osoittaa ei-toivotun toiminnan. Agentin tavoitteena on oppia niin sanottu toimintapolitiikka, eli sääntö, joka yhdistää tilat (agentin kulloisenkin tilanteen) toimenpiteisiin siten, että ajan myötä kertyvä kokonaispalkkio maksimoituu. Esimerkiksi robotiikassa vahvistusoppimista voidaan käyttää opettamaan robottia kävelemään. Robotti aloittaa ottamalla satunnaisia askelia ja saa palautetta vakaudesta, energiatehokkuudesta ja etenemisestä. Useiden toistojen jälkeen se oppii säätämään nivelten liikkeitä tehokkaammin, parantaen tasapainoa ja minimoiden energiankulutuksen (Song et al., 2021).
Syväoppiminen vie tekoälyn vielä pidemmälle pyrkimällä jäljittelemään tapaa, jolla ihmisaivot käsittelevät tietoa. Sen ytimessä ovat keinotekoiset neuroverkot, jotka on rakennettu biologisten neuronien toimintaa muistuttavalla tavalla, ja jotka kykenevät automaattisesti oppimaan ja tunnistamaan rakenteita suurista tietomassoista. Toisin kuin perinteisessä koneoppimisessa, jossa ihmisten täytyy usein käsin valita ja määritellä mallin kannalta olennaisimmat piirteet, syväoppimismallit pystyvät poimimaan nämä piirteet itse. Ne tulkitsevat raakadataa ilman erillistä ohjelmointia ja määrittävät, mitkä tiedon osatekijät ovat tärkeimpiä. Tämä mahdollistaa kuvioiden tunnistamisen ja päätöksenteon vähäisellä ihmisen suoralla ohjauksella.
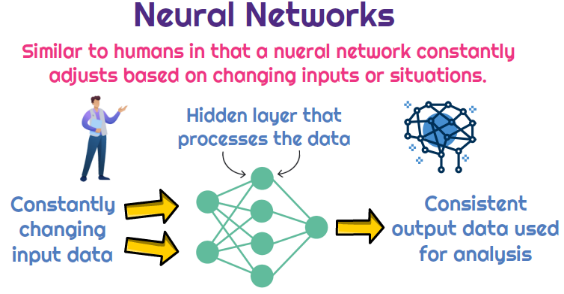
Kuva 25: Mukautuvat oppimisjärjestelmät, jotka käsittelevät muuttuvaa syötetedataa ja tuottavat analyysiä varten johdonmukaisen ulostulon .
Aivan kuten ihmisaivoissa on eri tehtäviin erikoistuneita alueita, myös syväoppimismallit on suunniteltu arkkitehtuureilla, jotka keskittyvät tietynlaisten datatyyppien käsittelyyn. Esimerkiksi visuaalista informaatiota käsitellessään aivojen näköaivokuori tunnistaa kohteita havaitsemalla ensin reunoja, muotoja ja tekstuureja, minkä jälkeen näistä muodostetaan kokonainen kuva. Tätä toimintaperiaatetta mukaillen konvoluutioneuroverkot (Convolutional Neural Networks, CNN) (Jorgecardete, 2025) on kehitetty erityisesti näköhavaintoihin liittyviä tehtäviä varten, ja ne oppivat automaattisesti kuvista olennaiset piirteet ilman manuaalista määrittelyä. CNN-malleja voidaan käyttää esimerkiksi kasvonilmeiden tunnistamiseen analysoimalla kasvokuvia ja tunnistamalla tunteita, kuten vihaa, iloa tai hämmästystä. Sen sijaan, että ihmisten tarvitsisi erikseen määritellä, miltä kukin tunne näyttää, malli oppii tunnistamaan kuvioita tutkimalla tuhansia kasvokuvia. Konvoluutio- ja pooling-kerrosten avulla malli poimii merkityksellisiä piirteitä, kuten kasvolihasten liikkeitä ja ilmeitä, jotka käsitellään edelleen täysin kytketyissä kerroksissa ja luokitellaan SoftMax-funktion avulla todennäköisimmän tunteen määrittämiseksi.
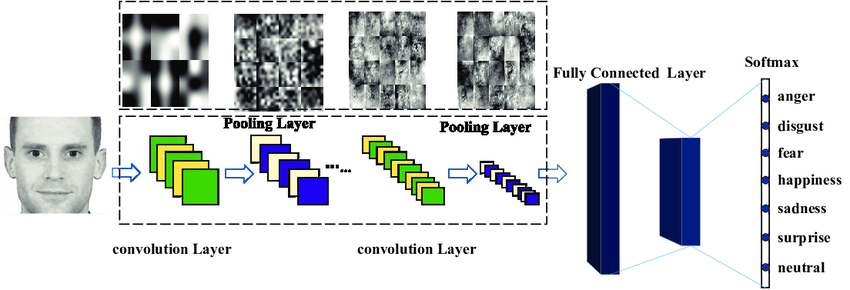
Kuva 26: Deep Learning-Based Facial Emotion Recognition Pipeline.
Muisti ja ajallisten tapahtumaketjujen käsittely ovat myös keskeisiä ihmisaivojen toimintoja päätöksenteossa ja hahmontunnistuksessa, ja juuri näitä toimintoja syväoppimismallit, kuten toistuvat neuroverkot (Recurrent Neural Networks, RNN) ja pitkän lyhytaikaisen muistin verkot (Long Short-Term Memory, LSTM), pyrkivät jäljittelemään. Tapa, jolla ihmiset muistavat aiempia kokemuksia ja hyödyntävät niitä nykyisissä päätöksissä, on näiden mallien toiminnan perusta. Ne soveltuvat erityisen hyvin peräkkäisen datan käsittelyyn, kuten kieleen, aikasarjaennusteisiin tai verkkoliikenteen analysointiin.
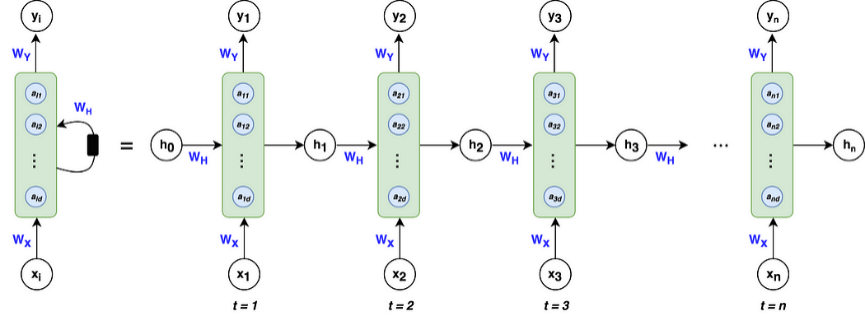
Kuva 27: Yksinkertaisen toistuvan neuroverkon arkkitehtuuri
(Khuong, 2025)
Kielen käsittely on toinen alue, jolla syväoppiminen on erityisen tehokasta, jäljitellen tapaa, jolla ihmisaivot tulkitsevat ja tuottavat puhetta. Transformereihin perustuvat mallit, kuten BERT ja GPT, analysoivat valtavia määriä tekstiä ja oppivat ymmärtämään kielen rakenteita ilman ennalta määriteltyjä kielioppisääntöjä. Merikyberturvallisuudessa tällaisia malleja voidaan käyttää sähköpostien, radioviestinnän ja järjestelmälokien analysointiin esimerkiksi tietojenkalasteluyritysten, vilpillisten viestien tai luvattomien käskyjen havaitsemiseksi, vaikka ne olisi naamioitu normaaliksi viestinnäksi. Pelkkään avainsanojen tunnistamiseen perustuvien menetelmien sijaan nämä mallit ymmärtävät asiayhteyden ja tarkoituksen, minkä ansiosta ne kykenevät tunnistamaan hienovaraisia uhkia, jotka perinteiset sääntöpohjaiset järjestelmät jättäisivät huomaamatta.
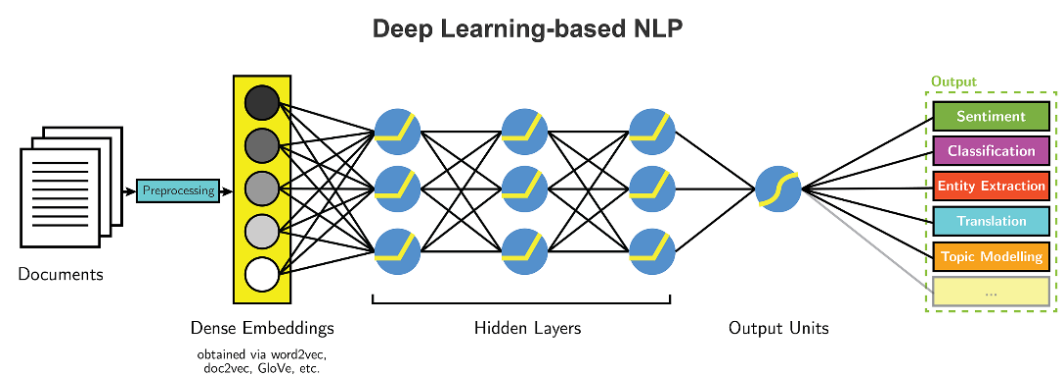
Kuva 28: Syväoppimiseen perustuva luonnollisen kielen käsittely (NLP)..
Syväoppimisen keskeinen vahvuus perustuu sen kykyyn oppia automaattisesti olennaiset piirteet suurista määristä jäsentymätöntä dataa. Toisin kuin perinteisissä koneoppimismenetelmissä, joissa ihmisten on erikseen suunniteltava ja määriteltävä piirteet eli päätettävä, mitkä datan ominaisuudet ovat merkityksellisiä, syväoppimismallit pystyvät tunnistamaan nämä piirteet itsenäisesti, kuten kuvassa 29 esitetään. Riippumatta siitä, koostuuko data kuvista, verkkolokeista, anturimittauksista tai tekstistä, järjestelmä analysoi lukuisia esimerkkejä, tarkentaa ymmärrystään vähitellen ja tunnistaa itsenäisesti informatiivisimmat rakenteet ja mallit. Tämä poistaa tarpeen manuaaliselle piirrevalinnalle, joka on usein aikaa vievää, vaatii syvällistä asiantuntemusta ja saattaa silti jättää datassa piileviä hienovaraisia ilmiöitä huomaamatta.
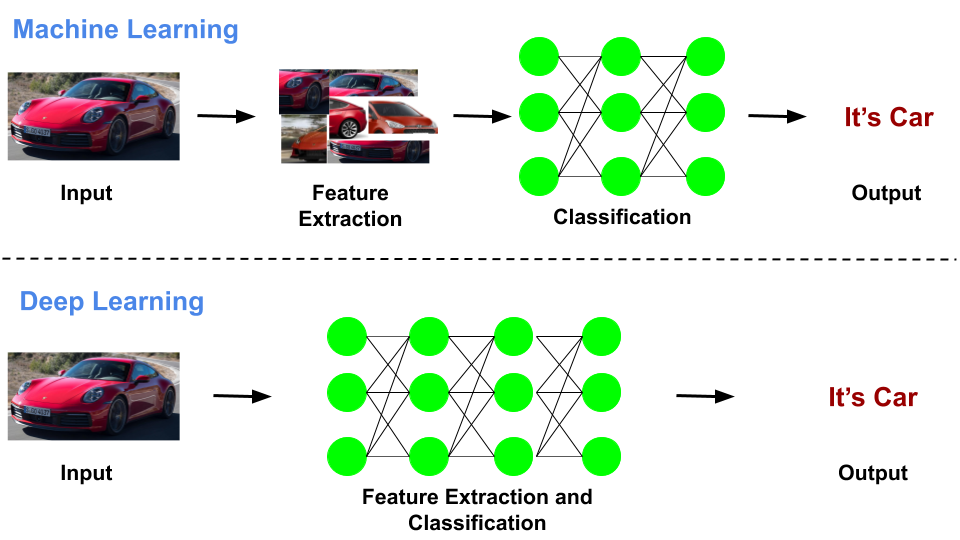
Kuva 29: Erot koneoppimisen ja syväoppimisen kehittymisessä.
Merenkulkualalla tekoäly voidaan integroida kyberturvallisuusjärjestelmiin käsittelemään valtavia tietomääriä, joita alukset, satamat ja satelliittiyhteydet tuottavat jatkuvasti. Uhkamallien kehittyessä koneoppimis- ja syväoppimismallit voivat päivittää itseään uuden datan perusteella ja tunnistaa riskejä tai hyökkäyksiä, joita ei ole koskaan erikseen kuvattu ihmisten laatimissa säännöissä. Tämä kyky mukautua ja kehittyä ajan myötä tekee tekoälystä erityisen arvokkaan nykyaikaisten kyberturvallisuushaasteiden ratkaisemisessa. Kuvassa 30 esitetään yleiskuva tekoälyn sovelluksista kyberturvallisuudessa.
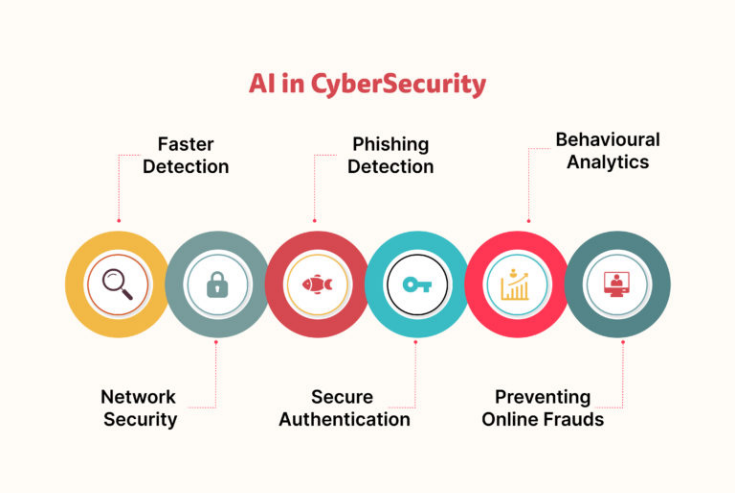
Kuva 30: Tekoälyn sovellukset kyberturvallisuudessa.
Koneoppimis- ja syväoppimismallien kehitys
Koneoppimis- tai syväoppimismallin kehittäminen etenee rakenteellisena prosessina, joka alkaa datan hankinnasta ja päättyy mallin käyttöönottoon ja ylläpitoon. Jokainen vaihe on keskeinen sen varmistamiseksi, että malli tuottaa tarkkoja ja luotettavia ennusteita todellisissa käyttöympäristöissä. Alla kuvataan koko kehitysputki vaihe vaiheelta siten, että se on ymmärrettävä myös niille, joilla ei ole syvällistä taustaa aiheesta.
Datan hankinta: olennaisen tiedon kerääminen
Ensimmäinen vaihe kaikissa koneoppimis- ja syväoppimisprojekteissa on datan hankinta. Ilman laadukasta ja tarkoituksenmukaista dataa edes kehittyneimmät algoritmit eivät pysty tuottamaan hyödyllisiä tuloksia. Dataa voidaan kerätä useista eri lähteistä riippuen ratkaistavasta ongelmasta. Merellisen kyberturvallisuuden kontekstissa relevanttia dataa voivat olla esimerkiksi verkkoliikennelokit, tietoturvatapahtumien kirjaustiedot sekä järjestelmien suorituskykymittarit. Verkkolokit kuvaavat laitteiden välistä viestintää ja auttavat tunnistamaan poikkeavia toimintamalleja, jotka voivat viitata kyberuhkiin. Tietoturvatapahtumalokit sisältävät hälytyksiä, joita järjestelmät tuottavat epäilyttävän toiminnan havaitessaan. Järjestelmien suorituskykyyn liittyvä data, kuten suorittimen tai muistin käyttö, voi puolestaan paljastaa tietoturvaloukkauksia tai teknisiä vikatilanteita. Kerättävän datan tyyppi määräytyy täysin sen mukaan, mihin tarkoitukseen malli on suunniteltu. Tunkeutumisen havaitsemiseen saatetaan tarvita pakettitason verkkodataa, kun taas alusten valvontaan liittyvissä sovelluksissa reaaliaikainen videokuva on keskeisemmässä roolissa.
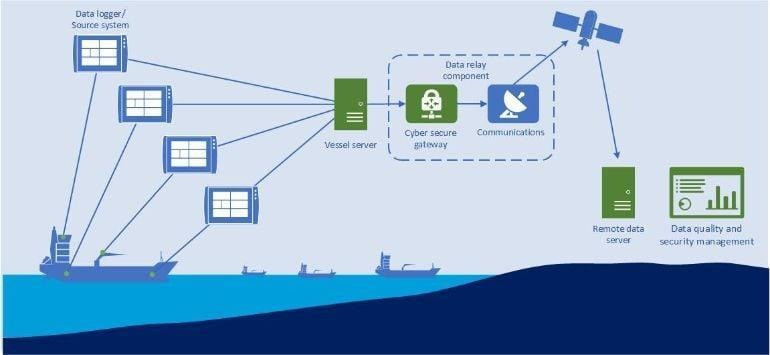
Kuva 31: Esimerkki tiedonkeruusta merenkulussa.
Datan esikäsittely: datan puhdistaminen ja muotoilu analyysiä varten
Raakadata on usein jäsentymätöntä, epäyhtenäistä tai virheellistä, mikä voi heikentää mallin suorituskykyä. Jotta dataa voidaan hyödyntää, se on käytävä läpi esikäsittelyvaiheessa. Tämä sisältää useita keskeisiä toimenpiteitä, kuten puuttuvien arvojen käsittelyn, kohinan poistamisen ja syötteiden standardoinnin. Puuttuvia arvoja voi syntyä viallisten antureiden tai puutteellisten lokitietojen vuoksi, ja ne on käsiteltävä joko arvioimalla puuttuvat arvot tai poistamalla vajaat havainnot. Kohina, kuten vioittuneet datapisteet tai epäolennainen informaatio, on poistettava, jotta malli ei opi virheellisiä malleja. Standardointi on tärkeää, koska data voi olla eri muodoissa tai yksiköissä. Esimerkiksi verkkolokien aikaleimat voidaan joutua muuntamaan samaan aikavyöhykkeeseen, tai numeeriset arvot voidaan normalisoida vertailukelpoisiksi. Rakenteisessa datassa, kuten verkkoliikennetaulukoissa, tähän vaiheeseen voi kuulua myös päällekkäisten rivien poistaminen. Jäsentymättömän datan, kuten kuvien tai tekstin, kohdalla esikäsittely voi tarkoittaa kuvien koon muuttamista, taustakohinan vähentämistä tai sanojen muuntamista numeeriseen muotoon, jota malli pystyy käsittelemään.
Piirrevalinta ja piirteiden muodostaminen: merkityksellisten mallien tunnistaminen tai luominen
Perinteisessä koneoppimisessa mallit eivät itsessään ymmärrä, mitkä datan ominaisuudet ovat olennaisia. Asiantuntijoiden on määriteltävä käsin ne piirteet, jotka parhaiten tukevat ongelman ratkaisua. Tätä prosessia kutsutaan piirrevalinnaksi ja piirteiden muodostamiseksi, ja se sisältää muuttujien valinnan, muuntamisen tai uusien muuttujien luomisen raakadatasta mallin suorituskyvyn parantamiseksi. Hyvin toteutettu piirrevalinta voi merkittävästi parantaa mallin tarkkuutta. Esimerkiksi tunkeutumisen havaitsemisjärjestelmässä verkkoliikennelokit voivat sisältää IP-osoitteita, aikaleimoja, pakettikokoja ja yhteyksien tilatietoja. Nämä sellaisenaan eivät välttämättä ole riittävän informatiivisia. Mallin suorituskykyä voidaan parantaa muodostamalla uusia piirteitä tilastollisten tai käyttäytymismallien pohjalta. Tällainen piirre voi olla esimerkiksi yhteyspyyntöjen määrä tietystä IP-osoitteesta tietyssä aikajaksossa, kuten kymmenessä sekunnissa. Äkillinen kasvu yhteyspyyntöjen määrässä voi viitata brute force -hyökkäykseen.
Syväoppiminen vähentää merkittävästi piirrevalinnan tarvetta. Syvät neuroverkot oppivat tunnistamaan olennaiset piirteet suoraan raakadatasta ilman ihmisen määrittelemiä sääntöjä. Tämä on yksi syväoppimisen keskeisistä eduista perinteiseen koneoppimiseen verrattuna. Se kykenee käsittelemään jäsentymätöntä dataa, kuten kuvia, ääntä ja tekstiä, ilman erillistä piirteiden määrittelyä. Esimerkiksi kuvantunnistuksessa konvoluutioneuroverkko voi oppia havaitsemaan reunoja, tekstuureja ja monimutkaisia objekteja ilman ihmisen ohjausta, mikä tekee siitä erittäin tehokkaan ratkaisun esimerkiksi alusten reaaliaikaisen valvontakuvamateriaalin analysointiin..
Mallin valinta: sopivan algoritmin valitseminen
Kun data on esikäsitelty, seuraava vaihe on sopivan mallin valinta. Algoritmin valintaan vaikuttavat datan tyyppi, tehtävän monimutkaisuus ja käytettävissä olevat laskentaresurssit. Perinteisessä koneoppimisessa käytetään usein päätöspuita, tukivektorikoneita tai satunnaismetsiä erityisesti rakenteisen datan yhteydessä. Nämä mallit edellyttävät käsin määriteltyjä piirteitä, mutta ne toimivat hyvin myös suhteellisen pienillä aineistoilla.
Syväoppimismallit ovat tehokkaampia, mutta vaativat suuria datamääriä ja merkittäviä laskentaresursseja. Konvoluutioneuroverkot soveltuvat erityisesti kuvapohjaisiin tehtäviin, kuten kohteiden tunnistamiseen meriliikenteen valvontakuvissa. Toistuvat neuroverkot ja transformer-mallit ovat puolestaan tehokkaita aikasarjojen ja sekventiaalisen datan käsittelyssä, kuten viestintälokien analysoinnissa kyberuhkien tunnistamiseksi. Oikean mallin valinta on kriittistä, sillä väärä valinta voi johtaa heikkoon suorituskykyyn tai tehottomaan laskentaan.
Mallin opetus: oppiminen datasta
Mallin valinnan jälkeen se opetetaan tekemään ennusteita. Opetus tarkoittaa datan syöttämistä mallille, mallin sisäisten parametrien säätämistä ja ennusteiden parantamista. Malli tuottaa aluksi ennusteita, ja häviöfunktio mittaa, kuinka kaukana ennusteet ovat oikeista arvoista. Suuri häviö tarkoittaa huonoa suorituskykyä. Optimointimenetelmät, kuten gradienttilaskenta, päivittävät mallin painokertoimia iteratiivisesti häviön pienentämiseksi. Tätä jatketaan, kunnes saavutetaan hyväksyttävä tarkkuus.
Ohjatussa oppimisessa malli opetetaan merkityllä datalla, jossa jokaisella syötteellä on tunnettu oikea tulos. Tavoitteena on minimoida ennusteiden ja todellisten arvojen välinen ero esimerkiksi ristientropian tai keskineliövirheen avulla.
Syväoppimisessa tämä prosessi on laskennallisesti raskas ja vaatii suuria datamääriä. Toisin kuin perinteisessä koneoppimisessa, jossa mallin koulutus voi valmistua minuuteissa tai tunneissa, syvien neuroverkkojen koulutus voi kestää päiviä tai jopa viikkoja arkkitehtuurin monimutkaisuudesta ja datan määrästä riippuen. Tämän monimutkaisuuden hallitsemiseksi syväoppimiskehykset, kuten TensorFlow ja PyTorch, tarjoavat tehokkaita työkaluja mallien rakentamiseen, automaattiseen derivointiin ja laitteistokiihdytykseen. Nämä kirjastot tukevat dynaamisia laskentakaavioita ja tarjoavat laajan valikoiman valmiita funktioita mallin optimointiin. Hyperparametrien säätäminen, kuten oppimisnopeus, eräkoko ja koulutusjaksojen määrä, on oleellista, jotta malli konvergoituu tehokkaasti.
Ohjaamattomassa oppimisessa malli koulutetaan merkitsemättömällä datalla, eli sillä ei ole ennalta määriteltyjä kategorioita tai oikeita vastauksia. Ennusteiden sijaan malli tunnistaa datasta rakenteita, säännönmukaisuuksia tai klustereita.
Klusterointialgoritmit ryhmittelevät samankaltaiset datapisteet yhteen etäisyysmittareiden perusteella.
Ulottuvuuden vähennysmenetelmät voivat tiivistää korkeaulotteisen datan matalampaan ulottuvuuteen säilyttäen olennaisen informaation.
Generatiiviset mallit oppivat luomaan uusia datanäytteitä, jotka muistuttavat opetusdataa.
Koska eksplisiittistä häviöfunktiota, joka vertaisi ennusteita todellisiin arvoihin, ei ole, ohjaamattoman oppimisen tavoitteet perustuvat usein esimerkiksi rekonstruointivirheen minimointiin tai klustereiden välisen varianssin maksimointiin.
Mallin validointi ja testaus: suorituskyvyn arviointi
Kun koulutus on valmis, on tärkeää testata, kuinka hyvin malli yleistyy uuteen, aiemmin näkemättömään dataan. Tämä tehdään validointi- ja testidatalla, joita ei käytetty koulutuksessa. Jos malli suoriutuu hyvin koulutusvaiheessa mutta huonosti uudella datalla, se on todennäköisesti ylisovittunut (overfitting). Yleistymiskyvyn arvioinnissa käytetään mittareita, kuten tarkkuus, täsmällisyys, recall ja F1-luku. Tarkkuus kertoo oikeiden ennusteiden osuuden, kun taas täsmällisyys ja recall antavat tietoa mallin luotettavuudesta esimerkiksi kyberuhkien tunnistamisessa. F1-luku yhdistää nämä mittarit kokonaisarvioksi. Jos suorituskyky on riittämätön, mallia voidaan parantaa keräämällä lisää dataa, tarkentamalla piirteitä (ML) tai hienosäätämällä hyperparametreja.
Käyttöönotto ja jatkuva seuranta: mallin hyödyntäminen käytännössä
Kun malli saavuttaa riittävän tarkkuuden ja luotettavuuden, se otetaan käyttöön todellisessa ympäristössä, jossa se tekee ennusteita reaaliaikaisesta datasta. Käyttöönotto ei kuitenkaan ole viimeinen vaihe: jatkuva seuranta ja ylläpito ovat välttämättömiä, jotta suorituskyky säilyy. Merenkulun kyberturvallisuudessa uudet uhat kehittyvät jatkuvasti, ja aiempien hyökkäystapojen perusteella koulutettu malli voi vanhentua. Suorituskyvyn heikkenemisen estämiseksi malleja on koulutettava uudelleen ajantasaisella datalla, seurattava virheitä ja parannettava niitä muuttuvien olosuhteiden mukaan. Ilman tätä mallit voivat tuottaa vanhentuneita ennusteita, aiheuttaa turvallisuusriskejä tai menettää tarkkuutta.
Ohjatun koneoppimismallin koulutusputken yleiskuva on esitetty kuvassa 32.
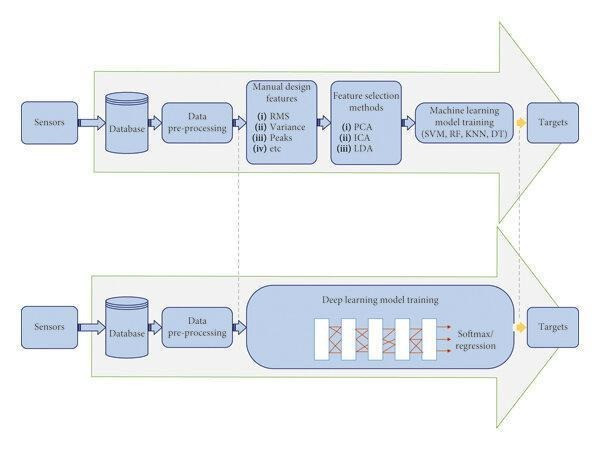
Kuva 32: Yleiskuva koneoppimis- ja syväoppimismallien koulutusputkista.
Tekoälyn sovellukset merenkulun kyberturvallisuudessa
Tunkeutumisen havaitsemisjärjestelmät (Intrusion Detection Systems, IDS)
Tunkeutumisen havaitsemisjärjestelmä (IDS) on tietoturvaratkaisu, jonka tarkoituksena on havaita luvaton pääsy, haitallinen toiminta ja mahdolliset uhat seuraamalla jatkuvasti verkkoliikennettä, käyttäytymismalleja ja järjestelmälokeja. IDS-järjestelmän sijoittelu riippuu sen tyypistä. Verkkopohjainen IDS (Network-Based IDS, NIDS) sijoitetaan tyypillisesti palomuurin ja sisäverkon väliin, kuten kuvassa 33 on esitetty, jolloin se tarkastaa kaiken saapuvan ja lähtevän liikenteen epäilyttävien piirteiden varalta ennen kuin liikenne saavuttaa kriittiset järjestelmät. Mikäli hyökkääjä onnistuu ohittamaan palomuurin, IDS havaitsee poikkeavuudet ja tuottaa hälytyksen jatkotutkimuksia varten. Isäntäpohjainen IDS (Host-Based IDS, HIDS) puolestaan asennetaan suoraan yksittäisiin laitteisiin, kuten aluksen navigointijärjestelmiin, palvelimiin tai työasemiin, joissa se valvoo järjestelmälokeja, tiedostojen eheyttä ja käyttäjätoimintaa haitallisten muutosten havaitsemiseksi. Merenkulussa IDS-järjestelmillä on keskeinen rooli kriittisten toimintojen, kuten lastinhallinnan, navigoinnin ja viestintäverkkojen, suojaamisessa (MarPoint, 2025).
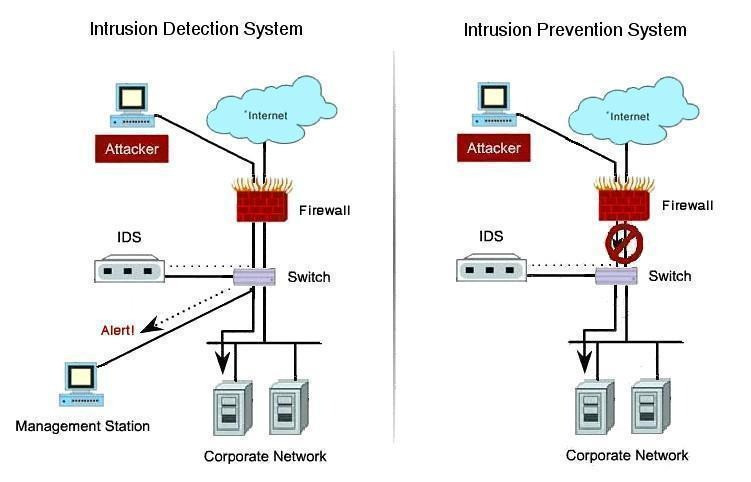
Kuva 33: Tunkeutumisen havaitsemisjärjestelmä
IDS hyödyntää kahta pääasiallista lähestymistapaa haitallisen toiminnan tunnistamiseen:
Allekirjoituspohjainen tunnistus: Vertaa havaittua toimintaa tunnettujen hyökkäysten allekirjoitustietokantaan merkkijonojen vertailumenetelmien avulla. Tämä menetelmä on tehokas tunnettujen uhkien tunnistamisessa, mutta ei kykene havaitsemaan uusia tai kehittyviä hyökkäyksiä.
Käyttäytymispohjainen tunnistus: Seuraa poikkeamia normaalista toiminnasta, mikä mahdollistaa uusien ja ennalta tuntemattomien uhkien havaitsemisen. Menetelmä on mukautuvampi, mutta saattaa tuottaa enemmän virheellisiä hälytyksiä.
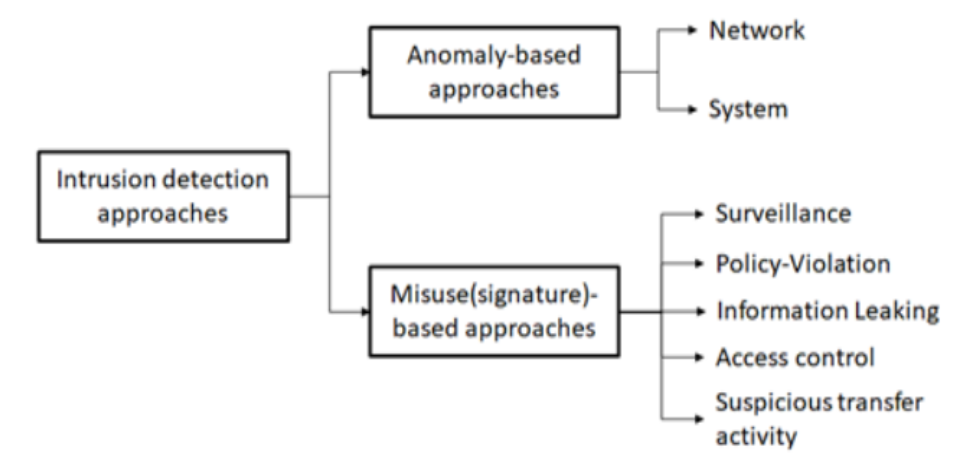
Kuva 34: Tunkeutumisen havaitsemismenetelmien luokittelu.
Tekoälypohjaiset IDS-järjestelmät parantavat turvallisuutta analysoimalla dataa reaaliajassa, tunnistamalla poikkeavuuksia ja erottamalla normaalit verkkokäyttäytymismallit haitallisista tunkeutumisista. Yhdistämällä ohjatut menetelmät, jotka perustuvat tunnettuihin hyökkäysallekirjoituksiin, ja ohjaamattomat menetelmät, jotka tunnistavat poikkeamat normaalista toiminnasta, tekoälypohjaiset IDS-järjestelmät vähentävät virheellisten hälytysten määrää ja parantavat havaitsemistarkkuutta.
Tekoälyä hyödyntävät IDS-järjestelmät käyttävät koneoppimisalgoritmeja uhkien entistä tarkempaan tunnistamiseen. Näiden algoritmien avulla IDS pystyy havaitsemaan sekä tunnetut että tuntemattomat kyberhyökkäykset.
Ohjattu oppiminen: Tässä lähestymistavassa tekoälymalli koulutetaan aiemmalla hyökkäysdatalla, joka on merkitty esimerkiksi ”turvalliseksi” tai ”vaaralliseksi”. Malli oppii datasta ja soveltaa oppimaansa uusien uhkien tunnistamiseen.
Ohjaamaton oppiminen: Tässä menetelmässä ei tarvita merkittyä dataa, vaan tekoäly tunnistaa epänormaalia toimintaa havaitsemalla käyttäytymismalleja, jotka poikkeavat normaalista toiminnasta.
Perinteisten IDS-järjestelmien yleinen ongelma on virheelliset positiiviset hälytykset, joissa harmiton verkkoliikenne tulkitaan uhaksi. Tekoäly vähentää virheellisiä hälytyksiä oppimalla aiemmista virheistä ja parantamalla tarkkuuttaan ajan myötä. Lisäksi tekoäly voi yhdistää useita tunnistusmenetelmiä parempien tulosten saavuttamiseksi. Yhdistämällä allekirjoituspohjaisen ja käyttäytymispohjaisen tunnistuksen tekoälypohjaiset IDS-järjestelmät minimoivat virheet säilyttäen samalla korkean turvallisuustason. Osa tekoälymalleista hyödyntää myös vahvistusoppimista, jossa järjestelmä mukauttaa tunnistussääntöjään jatkuvasti saadun palautteen perusteella.
Koska IDS on luonteeltaan passiivinen järjestelmä, se ei ryhdy suoriin vastatoimiin havaittuja uhkia vastaan. Sen sijaan se tuottaa hälytyksiä ihmisoperaattoreille tai integroituu tietoturvatapahtumien hallintajärjestelmiin (SIEM) jatkoanalyysiä ja reagointia varten. Tunkeutumiset voivat olla peräisin sekä ulkoisista että sisäisistä lähteistä, minkä vuoksi IDS on olennainen osa kyberturvallisuusstrategioita eri toimialoilla.
Tunkeutumisen estojärjestelmät (Intrusion Prevention Systems, IPS)
Tunkeutumisen estojärjestelmä (IPS) on tietoturvateknologia, joka on suunniteltu havaitsemaan ja ennakoivasti estämään haitallista toimintaa verkossa tai järjestelmässä. Toisin kuin IDS, joka toimii passiivisesti tarkkaillen ja hälyttäen epäilyttävästä toiminnasta, IPS ryhtyy suoriin toimenpiteisiin hyökkäysten estämiseksi, lieventämiseksi tai pysäyttämiseksi reaaliajassa. Käytännössä IDS toimii valvontatyökaluna, kun taas IPS on ohjaava järjestelmä, joka aktiivisesti estää uhat ennen kuin ne aiheuttavat haittaa esimerkiksi navigoinnissa, lastinkäsittelyssä tai viestintäyhteyksissä (Sowmya ja Anita, 2023).
IPS sijoitetaan tyypillisesti palomuurin taakse mutta ennen sisäisiä järjestelmiä, jolloin se pystyy tarkastamaan sekä saapuvan että lähtevän liikenteen, kuten kuvassa 35 on esitetty. Toisin kuin palomuuri, joka suodattaa liikennettä pääasiassa ennalta määriteltyjen sääntöjen perusteella, IPS hyödyntää kehittynyttä analytiikkaa dynaamisten uhkien tunnistamiseen ja estämiseen reaaliajassa. Joissakin verkkoratkaisuissa IPS toimii yhdessä IDS-järjestelmän kanssa siten, että IDS havaitsee ja hälyttää ylläpitäjiä, kun taas IPS toteuttaa aktiiviset vastatoimet uhkien neutraloimiseksi.
Kuva 35: Tunkeutumisen estojärjestelmä
IPS-järjestelmän keskeiset toiminnot:
Hälytysten lähettäminen järjestelmänvalvojille.
Mahdollisesti haitallisten datapakettien hylkääminen.
Yhteyksien estäminen haitallisista lähteistä.
Epäilyttävien tai kaapattujen yhteyksien katkaiseminen ja uudelleenkäynnistäminen jatkohyökkäysten estämiseksi.
Tekoälypohjainen uhkien tunnistaminen ja torjunta reaaliajassa.
Nykyaikaiset IPS-ratkaisut hyödyntävät tekoälyyn perustuvaa analytiikkaa ja reaaliaikaisia datavirtoja uhkien entistä tehokkaampaan tunnistamiseen ja estämiseen. Oppimalla jatkuvasti historiallisista ja uusista hyökkäysmalleista järjestelmät parantavat tunnistustarkkuuttaan ja vähentävät virheellisten hälytysten määrää. Yhdistämällä tekoälypohjaisen analytiikan reaaliaikaiseen dataan modernit IPS-järjestelmät vahvistavat turvallisuutta eristämällä saastuneet päätelaitteet, estämällä haitalliset IP-osoitteet ja muokkaamalla palomuurisääntöjä dynaamisesti estääkseen uhkien leviämisen aluksen sisäisissä verkoissa ja satamaympäristöissä (Maritime Intelligence, 2025). Hyvä esimerkki tästä on Ciscon toteuttama verkkopohjainen IPS, joka havaitsi ja lievensi sisäverkon uhkia ennen kuin ne ehtivät aiheuttaa tietojen menetystä tai palvelukatkoksia. Analysoimalla sekä saapuvaa että lähtevää liikennettä Ciscon IPS tarjosi kriittisen lisäsuojakerroksen ja osoitti tekoälyä hyödyntävien IPS-ratkaisujen tehokkuuden kyberuhkien ennakoivassa torjunnassa ennen niiden eskaloitumista (Contentree, 2025).
Avoimen lähdekoodin tunkeutumisen havaitsemis- ja estojärjestelmät
Kyberuhkien kehittyessä avoimen lähdekoodin IDS- ja IPS-ratkaisuista on tullut keskeisiä työkaluja verkkojen valvontaan ja suojaamiseen. Kaksi laajimmin käytettyä avointa IDS/IPS-järjestelmää ovat Snort ja Suricata, jotka tarjoavat reaaliaikaista uhkien tunnistusta ja estoa sekä joustavuutta ja muokattavuutta.
Snort: sääntöpohjainen IDS/IPS
Snort, jonka Martin Roesch kehitti alun perin vuonna 1998, on allekirjoituspohjainen IDS/IPS, joka kykenee reaaliaikaiseen verkkoliikenteen analysointiin ja IP-pakettien lokitukseen. Se hyödyntää sääntöpohjaista kieltä, jonka avulla voidaan yhdistää allekirjoitus-, protokolla- ja poikkeamapohjaisia tunnistusmenetelmiä laajan kyberuhkakirjon, kuten palvelunestohyökkäysten (DoS), puskuriylivuotojen, piilotettujen porttiskannausten ja CGI-hyökkäysten, havaitsemiseksi.
Snort toimii kaappaamalla verkkopaketteja esimerkiksi libpcap- ja WinPcap-kirjastojen avulla ja voi toimia kolmessa päätilassa:
- Pakettien kaappaustila (Packet Sniffing Mode), jossa raakaa verkkoliikennettä seurataan.
- Pakettien lokitustila (Packet Logging Mode), jossa verkkopaketit tallennetaan analysointia ja vianmääritystä varten.
- Tunkeutumisen havaitsemistila (Intrusion Detection Mode), jossa verkkotoimintaa verrataan ennalta määriteltyihin sääntöihin ja uhista tuotetaan hälytyksiä.
Snortin keskeinen etu on sen joustava sääntökieli, jonka avulla käyttäjät voivat määritellä omia tietoturvakäytäntöjään. Se integroidaan helposti palomuureihin tarjoten lisäsuojakerroksen, minkä vuoksi se on arvokas työkalu erityisesti sisäverkkojen valvonnassa.
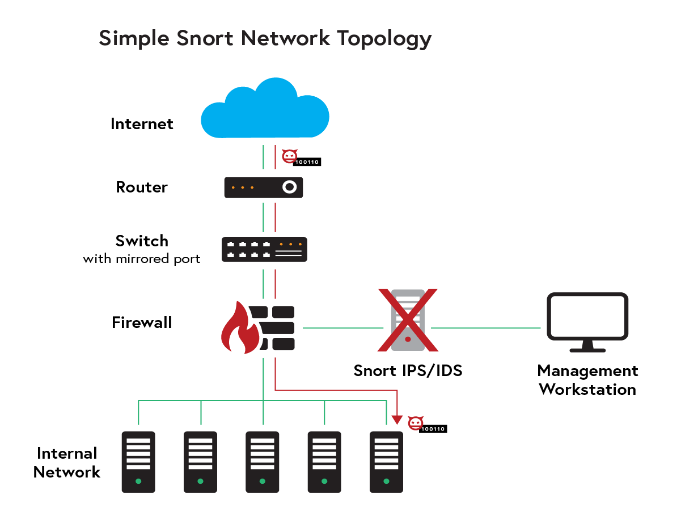
Kuva 36: Yksinkertainen Snort-verkkotopologia..
Suricata: suorituskykyinen IDS/IPS ja verkon tietoturvavalvonta (NSM)
Suricata on Open Information Security Foundationin (OISF) kehittämä uuden sukupolven IDS/IPS-ratkaisu, joka laajentaa perinteistä verkkoturvavalvontaa syvällisellä pakettitarkastuksella (Deep Packet Inspection, DPI) ja natiivilla monisäikeisyydellä. Toisin kuin Snort, joka keskittyy pääasiassa allekirjoituspohjaiseen tunnistukseen, Suricata pystyy analysoimaan useita protokollakerroksia, kuten HTTP-, TLS-, DNS- ja SMB-liikennettä, mahdollistaen kehittyneempien ja vaikeammin havaittavien uhkien tunnistamisen.
Yksi Suricatan keskeisistä eduista on sen kyky käsitellä suuria tietomääriä erittäin nopeasti monisäikeisen arkkitehtuurinsa ansiosta. Tämä tekee siitä erityisen soveltuvan yritystason ympäristöihin sekä pilvipohjaisiin tietoturvaratkaisuihin. Lisäksi Suricata integroituu saumattomasti erilaisiin tietoturvatapahtumien hallintajärjestelmiin (SIEM) ja data-analytiikka-alustoihin, mahdollistaen uhkien reaaliaikaisen visualisoinnin ja analysoinnin.
Suricatan toinen merkittävä ominaisuus on sen Network Security Monitoring (NSM) -toiminnallisuus, jonka avulla se pystyy poimimaan verkkoliikenteestä metatietoja varsinaisen tunkeutumisen havaitsemisen lisäksi. Tämä tukee kyberturvallisuustiimien tutkintatyötä tarjoamalla syvällisempää ymmärrystä verkon käyttäytymisestä ja tapahtumien taustalla olevista syistä.
Syvällinen pakettitarkastus kehittyneeseen uhkien havaitsemiseen
Syvällinen pakettitarkastus (Deep Packet Inspection, DPI) menee pelkkien pakettien otsakkeiden tarkastelua pidemmälle analysoimalla välitetyn datan sisältöä (payload) ja metatietoja. Tämä tarjoaa yksityiskohtaisen näkyvyyden protokolliin, sovelluskerroksen sisältöön ja käyttäjän määrittelemiin toimintoihin. Toisin kuin perinteinen pakettisuodatus, joka tarkastelee vain IP- ja TCP/UDP-otsakkeita, DPI analysoi koko paketin ja pystyy siten tunnistamaan haitallisia datasisältöjä, politiikkaloukkauksia tai salattuja uhkia, joita yksinkertaisemmat otsaketason suodatusmenetelmät usein jättävät huomaamatta (Leslie, 2020).
DPI-järjestelmä toimii tarkastelemalla pakettien sisältöä reaaliaikaisesti hyödyntäen allekirjoituspohjaista tunnistusta, heuristiikkaa ja poikkeavuuksien havainnointia. Se kykenee luokittelemaan liikennettä protokollan, sovellustyypin ja sisällön perusteella, mikä on olennaista laillisen näköiseen verkkoliikenteeseen piilotettujen uhkien tunnistamisessa. Esimerkiksi DPI voi erottaa normaalin HTTP-liikenteen HTTP-pohjaisesta hyökkäyksestä, kuten SQL-injektiosta tai komentokanavana toimivasta haittaohjelmaviestinnästä. DPI kykenee myös purkamaan SSL/TLS-salattua liikennettä tietoturva-analyysiä varten, mikä estää salattujen pakettien pääsyn suojausten ohi. Monet nykyaikaiset kyberhyökkäykset hyödyntävät salausta piilottaakseen haitallisen toimintansa, mutta tekoälyä hyödyntävä DPI voi tunnistaa poikkeavaa käyttäytymistä myös salatuissa yhteyksissä, kuten epätavallisia tiedonsiirtomalleja tai liikennettä tunnetuille haitallisille verkkotunnuksille.
Yhdistettynä tekoälyyn tai koneoppimiseen DPI tehostaa uhkien tunnistamista oppimalla aiemmista verkkoliikennemalleista ja havaitsemalla nollapäivähyökkäyksiä sekä kehittyneitä pitkäkestoisia uhkia, jotka voivat välttää perinteiset tietoturvamekanismit.
Kun poikkeama havaitaan, DPI-järjestelmät voivat käynnistää automaattisia vastatoimia, kuten eristää haitallisen toiminnan kohteena olevan päätelaitteen, katkaista epäilyttävät yhteydet tai muokata palomuurisääntöjä dynaamisesti haittaohjelmien leviämisen estämiseksi merenkulun IT- ja OT-verkkojen välillä (Ipoque, 2025).
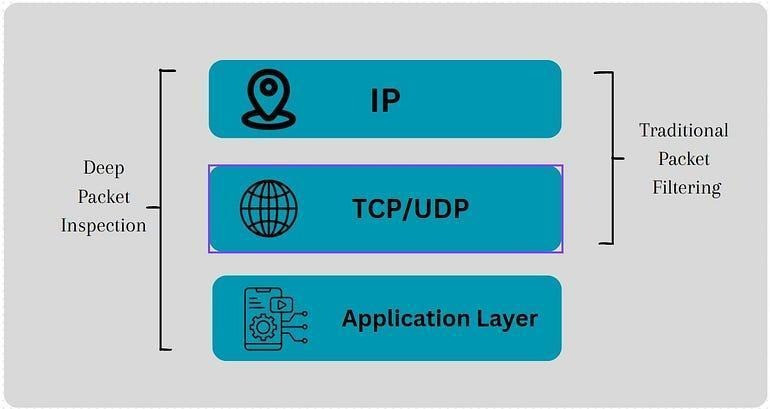
Kuva 37: Perinteisen pakettisuodatuksen ja syvällisen pakettitarkastuksen vertailu
(Nethmal, 2025).
Generatiiviset vastakkaisverkot (GAN) datan laajentamisessa ja puolustuksessa
Generatiiviset vastakkaisverkot (Generative Adversarial Networks, GAN) koostuvat kahdesta kilpailevasta neuroverkosta: generaattorista, joka tuottaa synteettistä dataa, ja diskriminaattorista, joka arvioi tuotetun datan aitoutta, kuten kuvassa 38 on esitetty. Alun perin GAN-mallit kehitettiin kuvien synteesiin ja deepfake-sisältöjen luomiseen, mutta ne ovat osoittautuneet erittäin hyödyllisiksi myös kyberturvallisuuden sovelluksissa, erityisesti tunkeutumisen havaitsemisessa, vastakkaisessa koulutuksessa ja haittaohjelmien analysoinnissa. Tuottamalla erittäin realistisia hyökkäysnäytteitä GAN-mallit parantavat koneoppimiseen perustuvien tietoturvajärjestelmien kykyä tunnistaa sekä tunnettuja että aiemmin havaitsemattomia uhkia (Zhao, 2024).
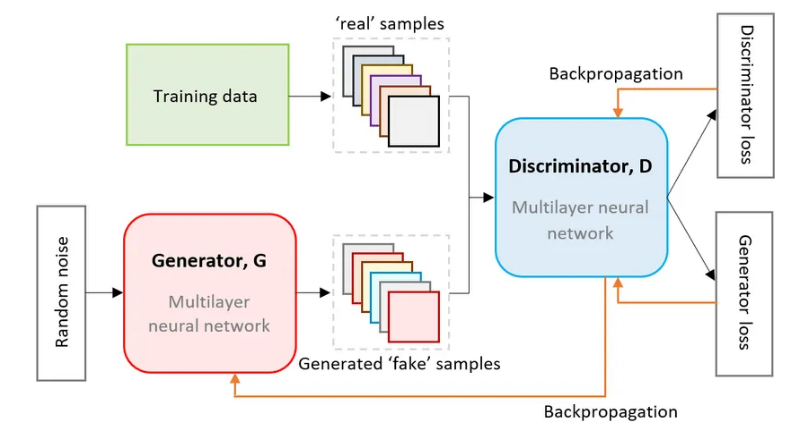
Kuva 38: GAN-verkon arkkitehtuuri
(TVS, 2025).
Yksi GAN-mallien keskeisistä käyttökohteista kyberturvallisuudessa on synteettisten haittaohjelmamallien tai hyökkäysyritysten tuottaminen, mikä mahdollistaa IDS- ja IPS-järjestelmien koulutusdatan laajentamisen. Perinteiset IDS/IPS-ratkaisut nojaavat usein allekirjoituspohjaiseen tunnistukseen, joka on heikko nollapäivähyökkäyksiä ja jatkuvasti muuntuvia polymorfisia haittaohjelmia vastaan. Kouluttamalla IDS/IPS-malleja GANien tuottamilla vastakkaisilla hyökkäysnäytteillä järjestelmien kyky tunnistaa aiemmin tuntemattomia hyökkäysmenetelmiä paranee merkittävästi. GAN-malleja hyödynnetään myös automatisoidussa penetraatiotestauksessa, jossa ne tuottavat esimerkiksi erilaisia tietojenkalasteluviestejä, brute force -hyökkäyspayloads tai hyökkäysskriptejä organisaation tietoturvatason arvioimiseksi. Reaaliaikaisia uhkia jäljittelevä GAN-pohjainen testaus mahdollistaa jatkuvan tietoturva-arvioinnin altistamatta järjestelmiä todellisille hyökkäyksille.
Tunkeutumisen havaitsemisen lisäksi GAN-malleja käytetään laajasti poikkeamien tunnistamisessa. GAN-pohjainen poikkeamien tunnistus oppii ensin normaalin verkkokäyttäytymisen tilastollisen jakauman ja tunnistaa sen jälkeen hienovaraiset poikkeamat, jotka voivat viitata huomaamattomiin kyberuhkiin, peiteltyihin haittaohjelmiin tai tiedon luvattomaan ulosvientiin. Toisin kuin perinteiset sääntöpohjaiset menetelmät, GAN-mallit mukautuvat jatkuvasti muuttuviin verkkoympäristöihin, mikä vähentää virheellisten hälytysten määrää ja parantaa tunnistuksen tarkkuutta. Tämä kyky havaita epänormaalia toimintaa on erityisen tärkeä kehittyneiden pitkäkestoisten uhkien tunnistamisessa, sillä ne pyrkivät sulautumaan normaaliin verkkoliikenteeseen.
Toinen merkittävä GAN-mallien käyttökohde on vastakkainen koulutus, jossa kyberturvallisuusjärjestelmiä vahvistetaan kiertäviä hyökkäystekniikoita vastaan. Hyökkääjät voivat hyödyntää vastakkaista koneoppimista muokatakseen hyökkäyksiä siten, että ne ohittavat IDS/IPS-järjestelmät. Kouluttamalla GAN-malleja simuloimaan tällaisia hyökkäyksiä voidaan testata ja vahvistaa puolustusjärjestelmiä, mikä parantaa niiden kestävyyttä kehittyneitä hyökkäyksiä vastaan.
Poikkeamien tunnistus
Siinä missä IDS-järjestelmät keskittyvät usein tietynlaisten tunkeutumisten tunnistamiseen, poikkeamien tunnistus on laajempi menetelmä, jonka tavoitteena on havaita kaikenlainen epätavallinen tai asiayhteyteen sopimaton toiminta, joka voi viitata järjestelmävikaan tai kyberuhkaan. Seuraamalla esimerkiksi järjestelmäresurssien käyttöä, verkkoviiveitä ja kirjautumisyrityksiä poikkeamien tunnistusalgoritmit muodostavat vertailutason normaalille toiminnalle. Merkittävät poikkeamat tästä tasosta voivat viitata tietoturvaongelmaan tai operatiiviseen häiriöön. Monissa merenkulun sovelluksissa tekoälyjärjestelmät voivat käynnistää automaattisia vastatoimia, kuten riskialttiiden verkkojen eristämisen tai palomuurisääntöjen säätämisen, jotta mahdolliset uhkat saadaan nopeasti hallintaan (Ribeiro et al., 2023). Tämä nopea ja autonominen reagointi on erityisen tärkeää merenkulussa, jossa pienetkin häiriöt voivat nopeasti kasvaa laajoiksi logistisiksi tai turvallisuuteen liittyviksi ongelmiksi, ellei niihin puututa välittömästi.
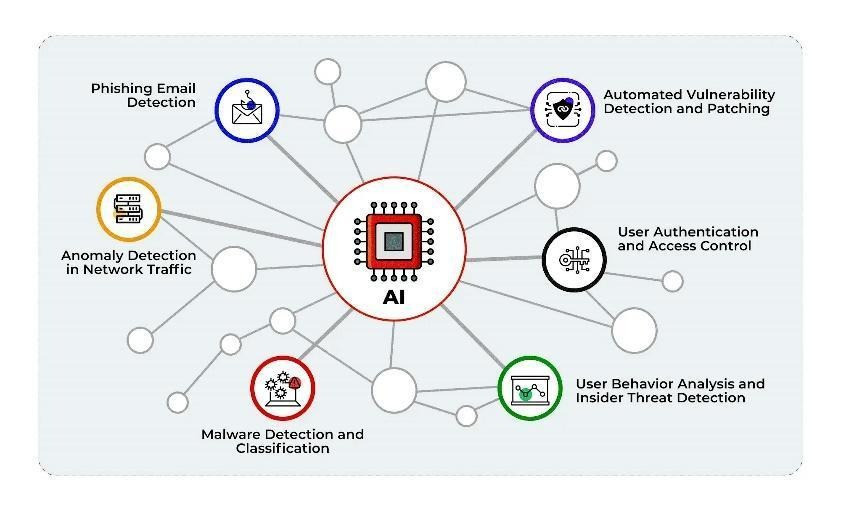
Kuva 39: Poikkeamien tunnistamisen sovellukset kyberturvallisuudessa.
Ennakoiva analytiikka kyberuhkien hallinnassa
Ennakoiva analytiikka hyödyntää historiallista dataa ja käyttäytymismalleja mahdollisten haavoittuvuuksien ja tulevien hyökkäysstrategioiden ennustamiseen, mahdollistaen ennakoivan kyberpuolustuksen. Analysoimalla suuria määriä aiempia kyberturvallisuuspoikkeamia tekoälymallit voivat tunnistaa tekijöitä, jotka usein edeltävät hyökkäyksiä (Merrick, 2022). Käytännössä algoritmit simuloivat erilaisia hyökkäysskenaarioita ja tunnistavat järjestelmien heikot kohdat, tarjoten tietoturvatiimeille selkeän kuvan siitä, mihin resursseja tulisi ensisijaisesti kohdentaa. Antamalla eri uhkille riskipisteytyksen merenkulun toimijat voivat priorisoida puolustustoimenpiteitä ja vahvistaa kriittisten järjestelmien suojaa. Tämä lähestymistapa ei ainoastaan vähennä välittömiä riskejä, vaan myös parantaa pitkän aikavälin kykyä vastata kehittyviin kyberuhkiin (Meijer ja Wessels, 2019). Ennakoiva analytiikka integroidaan usein tietoturvatapahtumien hallintajärjestelmiin, jolloin useista lähteistä saatavaa reaaliaikaista dataa voidaan yhdistellä uhkien ennustamisen tarkkuuden parantamiseksi. Yhdistettynä tunkeutumisen havaitsemis ja estojärjestelmiin nämä mallit voivat käynnistää automaattisia puolustustoimia ja estää uhkia jo ennen niiden toteutumista.
Mahdolliset haavoittuvuudet ja vastakkaiset hyökkäykset
Vaikka tekoäly vahvistaa merkittävästi merenkulun kyberturvallisuutta, se tuo mukanaan myös uusia haavoittuvuuksia, joita vastustajat voivat pyrkiä hyödyntämään. Vastakkaisissa hyökkäyksissä tekoälymalleille syötetään huolellisesti muokattua dataa, jonka tarkoituksena on johtaa mallit virheellisiin päätelmiin tai estää niitä tunnistamasta todellisia uhkia (Qiu et al., 2019). Esimerkiksi haittaohjelma voidaan naamioida siten, että tekoälypohjainen tunnistusjärjestelmä luokittelee sen harmittomaksi. Toinen merkittävä riski on mallin myrkyttäminen, jossa hyökkääjät lisäävät koulutusdataan virheellistä tai harhaanjohtavaa tietoa, heikentäen vähitellen mallin suorituskykyä.
Näitä uhkia vastaan merenkulun organisaatiot ottavat käyttöön useita suojaavia toimenpiteitä. Keskeinen keino on mallien säännöllinen uudelleenkoulutus eheäksi varmennetulla datalla, jotta järjestelmät pysyvät ajantasaisina ja luotettavina. Lisäksi vastakkainen koulutus, jossa malli altistetaan tarkoituksellisesti harhaanjohtaville syötteille kehitysvaiheessa, parantaa sen kykyä tunnistaa ja vastustaa manipulointiyrityksiä. Myös vahvat dataputket ja käyttöoikeuksien hallinta ovat olennaisia, sillä ne suojaavat sekä koulutusprosessia että tekoälyn operatiivista käyttöä, säilyttäen tekoälyn tarjoamat hyödyt merenkulun turvallisuudelle ja toiminnan tehokkuudelle.
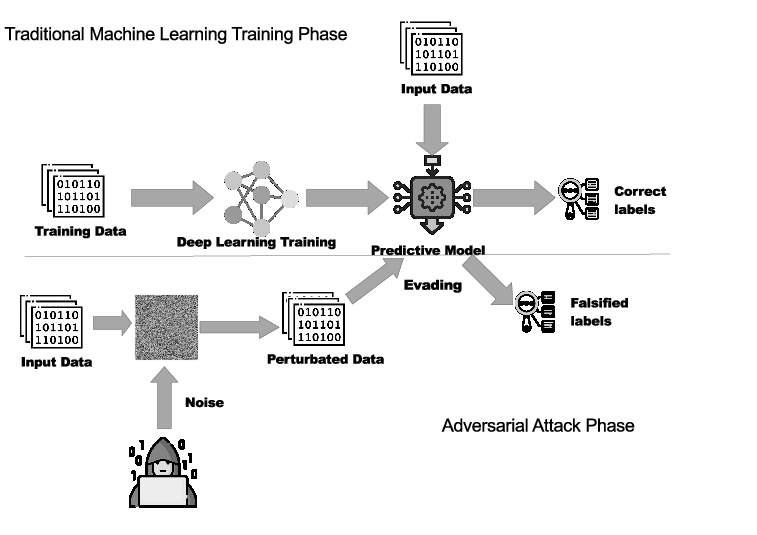
Kuva 40: Esimerkki vastakkaisesta hyökkäyksestä
(Catak & Sule, (2020).
Tekoälyn haasteet ja rajoitteet
Tekoälypohjaiset järjestelmät tarjoavat kehittyneitä valmiuksia kyberuhkien tunnistamiseen ja torjuntaan, mutta samalla ne tuovat mukanaan useita haasteita ja rajoitteita, jotka organisaatioiden on huomioitava järjestelmien tehokkaan hyödyntämisen varmistamiseksi.
Datan laatu ja saatavuus
Yksi keskeisimmistä haasteista liittyy datan laatuun ja saatavuuteen. Koska tekoälyjärjestelmät perustuvat suurten ja laadukkaiden datamäärien hyödyntämiseen mallien koulutuksessa ja kehittämisessä, datassa esiintyvät virheet, puutteet tai vinoumat voivat johtaa virheellisiin ennusteisiin tai uhkien jäämiseen havaitsematta. Organisaatioilla on usein vaikeuksia yhdistää dataa useista eri verkon osista ja erillisistä lähteistä (Palo Alto Networks, 2025). Tämä voi johtaa puutteelliseen kokonaiskuvaan käyttäjätoiminnoista ja järjestelmien käyttäytymisestä, mikä heikentää uhkien tunnistamista.
Virheelliset hälytykset ja hälytyskuormitus
Toinen merkittävä haaste liittyy virheellisten hälytysten suureen määrään. Vaikka tekoälyn tavoitteena on vähentää tällaisia hälytyksiä, järjestelmät voivat silti tuottaa runsaasti varoituksia, jotka kuormittavat tietoturvatiimejä. Tämä voi johtaa niin sanottuun hälytyskuormitukseen, jossa tietoturvahenkilöstö alkaa sivuuttaa myös mahdollisesti merkittäviä hälytyksiä jatkuvan vähäriskisten ilmoitusten tulvan vuoksi (Olateju et al., 2024). Näiden hälytysten hallinta ja tutkinta vaatii huomattavasti aikaa ja resursseja, mikä voi viedä huomiota pois todellisista uhkista.
Monimutkaisuus ja tulkittavuuden puute
Lisähaasteita aiheuttavat järjestelmien monimutkaisuus ja tulkittavuuden puute. Nykyaikaiset tekoälymenetelmät, erityisesti syväoppiminen, tuottavat tuloksia usein niin sanottujen mustien laatikoiden kautta, joissa päätöksenteon logiikka ei ole helposti ymmärrettävissä. Tietoturva-asiantuntijoiden voi olla vaikea luottaa hälytyksiin tai toimia niiden perusteella, jos he eivät ymmärrä, miten tai miksi tekoälymalli on päätynyt tiettyyn johtopäätökseen (Digital Leaders, 2025). Tämän vuoksi on olennaista, että tekoälypohjaiset tietoturvajärjestelmät pystyvät tarjoamaan selkeitä perusteluja ja selityksiä havainnoilleen, jotta luottamus niiden käyttöön voidaan rakentaa.
Integrointi olemassa oleviin järjestelmiin
Monissa organisaatioissa integrointi olemassa oleviin järjestelmiin ei ole ongelmatonta. Tekoälypohjaisten ratkaisujen on toimittava saumattomasti yhdessä organisaation nykyisen tietoturvainfrastruktuurin kanssa, mikä voi aiheuttaa yhteensopivuusongelmia ja edellyttää merkittävää teknistä osaamista. Vanhemmat järjestelmät vaativat usein päivityksiä ennen kuin ne kykenevät käsittelemään tekoälyn edellyttämää datamäärää ja kehittynyttä analytiikkaa. Nämä vaatimukset lisäävät käyttöönoton monimutkaisuutta sekä aiheuttavat lisäkustannuksia ja pidentävät toteutusaikatauluja.
Alttius vastakkaisille hyökkäyksille
Myös itse tekoälymallit voivat olla alttiita vastakkaisille hyökkäyksille, joissa haitalliset toimijat muokkaavat syötteitä tarkoituksellisesti järjestelmän harhauttamiseksi. Tämä voi tarkoittaa esimerkiksi harhaanjohtavien kuvioiden tai signaalien lisäämistä dataan siten, että tekoäly luokittelee uhat virheellisesti tai sallii luvattoman pääsyn. Näiden hyökkäysten torjuminen edellyttää jatkuvaa valvontaa sekä mallien säännöllistä päivittämistä, jotta ne säilyvät toimintakykyisinä kehittyviä hyökkäystekniikoita vastaan (MetaCompliance, 2025).
Ennakkoluulot tekoälymalleissa
Ennakkoluulot tekoälymalleissa on merkittävä huolenaihe. Mikäli koulutusdata on vinoutunutta tai heijastaa tiettyjä ennakkoluuloja, IDS-järjestelmä saattaa perusteettomasti tunnistaa tietyt ryhmät, toimintatyypit tai käyttäytymismallit uhkina. Tämä voi johtaa eettisten ongelmien lisäksi myös heikentyneisiin tietoturvatuloksiin, sillä vinoutunut tarkastelukulma voi aiheuttaa sen, että laajempia uhkia jää havaitsematta (ISC², 2024). Harhaisuuden tunnistaminen ja lieventäminen onkin keskeistä oikeudenmukaisuuden varmistamiseksi ja havaitsemisprosessin eheyden säilyttämiseksi.
Sääntely- ja vaatimustenmukaisuushaasteet
Sääntely- ja vaatimustenmukaisuusvaatimukset tuovat mukanaan vielä yhden lisäkerroksen monimutkaisuutta. Monet toimialat, mukaan lukien merenkulku, joutuvat noudattamaan tiukkoja tietosuoja- ja kyberturvallisuuslakeja varmistaakseen käyttäjä-, asiakas- ja operatiivisten tietojen turvallisen käsittelyn. Tekoälypohjaisten ratkaisujen on kyettävä tuottamaan selkeitä auditointijälkiä ja tarjottava riittävä läpinäkyvyys vaatimustenmukaisuuden osoittamiseksi tarkastuksissa, mikä lisää hallinnollista ja teknistä kuormitusta käyttöönotossa (Ethico, 2024). Vaatimustenmukaisuus esimerkiksi NIST Cybersecurity Frameworkin, ISO 27001 -standardin ja ENISA:n ohjeistusten kanssa on keskeistä tekoälyä hyödyntävien kyberturvallisuusjärjestelmien turvallisen ja laillisen käyttöönoton varmistamiseksi.
Korkeat käyttöönotto- ja ylläpitokustannukset
Myös kustannukset ovat merkittävä tekijä. Alkuvaiheen investoinnit erikoistuneeseen laitteistoon, ohjelmistolisensseihin ja asiantuntijapalveluihin voivat olla huomattavia, ja jatkuva ylläpito, päivitykset sekä mallien uudelleenkoulutus edellyttävät jatkuvaa rahoitusta. Tämän seurauksena pienemmillä organisaatioilla voi olla vaikeuksia perustella tai rahoittaa tekoälypohjaisten ratkaisujen pitkäaikaista ja laajamittaista käyttöönottoa (Modern Diplomacy, 2024).
Osaavien ammattilaisten puute
Lisäksi tekoälypohjaisten tietoturvajärjestelmien hallintaan liittyvässä osaamisessa esiintyy usein selkeä puute. Organisaatioiden voi olla haastavaa rekrytoida tai kouluttaa riittävästi ammattilaisia, joilla on sekä tekoälyosaamista että kyberturvallisuuskokemusta. Henkilöstön pitäminen ajan tasalla nopeasti kehittyvistä tekoälytekniikoista ja kyberuhkista edellyttää sitoutumista jatkuvaan koulutukseen ja osaamisen kehittämiseen (Technology Magazine, 2024).
Yksityisyydensuojaan liittyvät huolenaiheet
Lopuksi yksityisyyteen liittyvät kysymykset nousevat keskiöön, kun tekoälypohjaisia IDS-järjestelmiä käytetään käyttäjäkäyttäytymisen seurantaan. Tällaisen yksityiskohtaisen tiedon kerääminen ja analysointi voi olla ristiriidassa tietosuojalainsäädännön kanssa, ellei sitä toteuteta huolellisesti. Organisaatioiden on varmistettava, että käyttäjätietoja kerätään, säilytetään ja käsitellään yksilöiden yksityisyyden suojaa kunnioittaen sekä GDPR:n kaltaisten säädösten mukaisesti (Stewart, 2024). Tasapainon saavuttaminen edellyttää käyttäjien suostumuksen hankkimista, seurantakäytäntöjen selkeää viestintää sekä tiukkojen tiedonhallintakäytäntöjen ylläpitämistä.
Näihin haasteisiin, kuten datan laatuun, virheellisiin hälytyksiin, tulkittavuuteen, kustannuksiin, harhaisuuteen, osaamisvajeeseen ja yksityisyydensuojaan vastaamalla organisaatiot voivat hyödyntää tekoälypohjaisten ratkaisujen täyden potentiaalin samalla, kun ne säilyttävät vahvan tietoturvan ja sääntelyn noudattamisen..
Yhteenvetona tekoäly muuttaa meriliikenteen kyberturvallisuutta tehostamalla uhkien havaitsemista, ehkäisemällä kyberhyökkäyksiä ja optimoimalla alusten operatiivista toimintaa. Koneoppimisen ja syväoppimisen avulla tekoälypohjaiset järjestelmät, kuten IDS-, IPS- ja DPI-ratkaisut, mahdollistavat tietoturvariskien reaaliaikaisen seurannan, analysoinnin ja niihin reagoinnin. Ennakoiva analytiikka vahvistaa kyberpuolustusta entisestään tunnistamalla haavoittuvuuksia jo ennen hyökkäysten toteutumista. Tekoälyn käyttöönottoon liittyy kuitenkin haasteita, kuten vastahyökkäykset, harhaisuus ja integraation monimutkaisuus. Järjestelmien kestävyyden varmistamiseksi tarvitaan jatkuvaa kehitystä tekoälyn tietoturvastrategioissa, kuten vastahyökkäyskoulutuksessa, paremmassa sääntelyn noudattamisessa ja mukautuvissa oppimismalleissa. Kyberuhkien kehittyessä tekoälyllä on yhä keskeisempi rooli merenkulun toimintojen suojaamisessa sekä operatiivisen tehokkuuden ja turvallisuuden parantamisessa.