Κεφάλαιο 8 - Θεωρία
5. Τεχνητή Νοημοσύνη (AI) για κυβερνοασφάλεια στη ναυτιλία και προγνωστική ανάλυση
Η κυβερνοασφάλεια έχει καταστεί ένα κρίσιμο ζήτημα για την προστασία ζωτικών λειτουργιών όπως η ναυσιπλοΐα, η διαχείριση φορτίου και τα δίκτυα επικοινωνίας. Η Τεχνητή Νοημοσύνη (AI) έχει αναδειχθεί ένα ισχυρό εργαλείο για την αντιμετώπιση αυτών των προκλήσεων ασφάλειας. Αναλύοντας τεράστιους όγκους δεδομένων, τα συστήματα AI μπορούν να ανιχνεύουν απειλές με μεγαλύτερη ακρίβεια, να επιταχύνουν την απόκριση και να μετριάζουν λειτουργικές διαταραχές (Kaur et al., 2023). Το παρόν έγγραφο παρέχει μια επισκόπηση της Τεχνητής Νοημοσύνης (AI), της Μηχανικής Μάθησης (ML) και της Βαθιάς Μάθησης (DL), περιγράφει τον κύκλο ζωής ανάπτυξης των μοντέλων μηχανικής μάθησης και εξετάζει τον τρόπο που αυτές οι τεχνολογίες ενισχύουν την κυβερνοασφάλεια και τη λειτουργική απόδοση στη ναυτιλία.
Πέρα από την ανίχνευση επιθέσεων, η Τεχνητή Νοημοσύνη βελτιώνει επίσης την απόδοση των πλοίων και την ενεργειακή απόδοση, αναλύοντας δεδομένα από αισθητήρες πλοίων για την πρόβλεψη πιθανών μηχανικών βλαβών πριν αυτές εμφανιστούν (Tu et al., 2018). Η τεχνική αυτή βοηθά στον προγραμματισμό επισκευών στις πιο οικονομικά συμφέρουσες χρονικές περιόδους και αποτρέπει τις απρόβλεπτες βλάβες. Επιπλέον, η Τεχνητή Νοημοσύνη μπορεί να τροποποιεί δυναμικά την ταχύτητα και τη διαδρομή ενός πλοίου με βάση τις καιρικές συνθήκες, το φορτίο ή την κατανάλωση καυσίμων, μειώνοντας τελικά το λειτουργικό κόστος και τον περιβαλλοντικό αντίκτυπο.
Μια άλλη κρίσιμη εφαρμογή είναι η οπτική επιτήρηση με τη βοήθεια Τεχνητής Νοημοσύνης, η οποία ενισχύει την ασφάλεια στη ναυτιλία παρακολουθώντας δραστηριότητες επί του πλοίου για μη εξουσιοδοτημένη πρόσβαση ή ασυνήθιστη συμπεριφορά (Şengönül et al., 2023). Τα μοντέλα βαθιάς μάθησης, όπως τα συνελικτικά νευρωνικά δίκτυα, αναγνωρίζουν τις ανωμαλίες στη διαχείριση φορτίου ή εντοπίζουν πότε το προσωπικό εισέρχεται σε περιορισμένες ζώνες. Για παράδειγμα, τα ρομποτικά συστήματα μπορούν να αφαιρέσουν τα φορτία από εμπορευματοκιβώτια που φτάνουν σε τυχαία σειρά με ασφάλή και αποτελεσματικό τρόπο, μειώνοντας τους κινδύνους της χειρωνακτικής εργασίας και βελτιώνοντας την ακρίβεια των λειτουργιών (Mojtahedzadeh et al., 2015).
Βασικές αρχές της Τεχνητής Νοημοσύνης (AI), της Μηχανικής Μάθησης (ML) και της Βαθιάς Μάθησης (DL)
Η Τεχνητή Νοημοσύνη είναι ένας ευρύς τομέας της επιστήμης των υπολογιστών που επικεντρώνεται στη δημιουργία συστημάτων ικανών να εκτελούν εργασίες που συνήθως απαιτούν ανθρώπινη νοημοσύνη, όπως η κατανόηση της γλώσσας, η αναγνώριση προτύπων ή η λήψη αποφάσεων. Η πρώιμη έρευνα στον τομέα της Τεχνητής Νοημοσύνης βασιζόταν σε μεγάλο βαθμό στα επονομαζόμενα «συστήματα βάσει κανόνων», όπου οι ειδικοί καταγράφουν λεπτομερείς σειρές οδηγιών τύπου IF-THEN (ΑΝ-ΤΟΤΕ), όπως φαίνεται στο Σχήμα 23. Για παράδειγμα, ένας κανόνας κυβερνοασφάλειας μπορεί να ορίζει: «ΑΝ ένας υπολογιστής καταγράψει πολλαπλές αποτυχημένες προσπάθειες σύνδεσης, ΤΟΤΕ να αποκλείσει προσωρινά τον χρήστη». Τέτοια συστήματα λειτουργούν καλά σε περιπτώσεις όπου οι κανόνες ορίζονται σαφώς, αλλά ενδέχεται να αντιμετωπίσουν δυσκολίες όταν έρχονται αντιμέτωπα με νέα ή απρόβλεπτα προβλήματα.
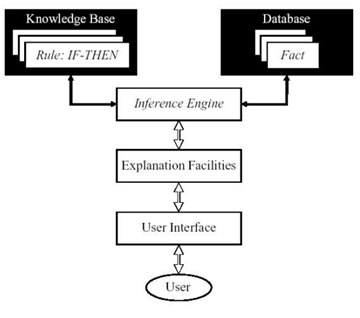
Σχήμα 23: Δομή συστημάτων Τεχνητής Νοημοσύνης βασισμένων σε κανόνες
(Mojtahedzadeh et al., 2015)
Η σύγχρονη τεχνητή νοημοσύνη δεν βασίζεται πλέον αποκλειστικά σε κανόνες που γράφονται χειροκίνητα. Αντίθετα, χρησιμοποιεί τεχνικές όπως η μηχανική μάθηση, οι οποίες επιτρέπουν στους υπολογιστές να μαθαίνουν από τα δεδομένα χωρίς να προγραμματίζονται ρητά για κάθε πιθανό σενάριο. Αντί να καθορίζουμε οδηγίες για κάθε περίπτωση, δίνουμε στο σύστημα τεράστιες ποσότητες πληροφοριών, επιτρέποντάς του να αναλύει μοτίβα και να λαμβάνει τις δικές του αποφάσεις. Αυτή η διαδικασία αντικατοπτρίζει τον τρόπο με τον οποίο οι άνθρωποι μαθαίνουν μέσω της εμπειρίας, παρατηρώντας πολυάριθμα παραδείγματα, αναγνωρίζοντας σχέσεις και βελτιώνοντας σταδιακά την κατανόησή τους. Στις ναυτιλιακές δραστηριότητες, για παράδειγμα, η μηχανική μάθηση (ML) αναλύει δεδομένα από συστήματα εντοπισμού GPS για να εντοπίζει ασυνήθιστης κίνησης πλοίων που ενδέχεται να υποδηλώνουν μη εξουσιοδοτημένη πρόσβαση ή απειλές πειρατείας. Μαθαίνοντας συνεχώς από δεδομένα θέσης σε πραγματικό χρόνο και προηγούμενα περιστατικά, η Τεχνητή Νοημοσύνη αναγνωρίζει αποκλίσεις από τις συνήθεις διαδρομές ή συμπεριφορές, ενεργοποιώντας ειδοποιήσεις προτού οι πιθανοί κίνδυνοι ασφαλείας κλιμακωθούν. Με την πάροδο του χρόνου, τα μοντέλα μηχανικής μάθησης βελτιώνουν τις προβλέψεις τους και προσαρμόζονται σε νέες περιπτώσεις, με αποτέλεσμα να καθίστανται αποτελεσματικότερα στην αντιμετώπιση σύνθετων και εξελισσόμενων προβλημάτων, χωρίς να απαιτείται άμεση ανθρώπινη παρέμβαση για κάθε απόφαση.
Στο πλαίσιο της Μηχανικής Μάθησης, υπάρχουν διάφοροι τρόποι μάθησης. Σε μια προσέγγιση, που συχνά ονομάζεται επιβλεπόμενη μάθηση, στο σύστημα παρουσιάζονται παραδείγματα που διαθέτουν ήδη απαντήσεις ή ετικέτες. Με την πάροδο του χρόνου, το σύστημα κατανοεί πώς αυτές οι απαντήσεις σχετίζονται με κάθε παράδειγμα, ώστε να μπορεί να προβλέψει αποτελέσματα για νέα, άγνωστα δεδομένα. Ανάλογα με τον τύπο του προβλήματος, η επιβλεπόμενη μάθηση χρησιμοποιηθεί για ταξινόμηση, όπου ο στόχος είναι η αντιστοίχιση σημείων δεδομένων σε συγκεκριμένες κατηγορίες, όπως η ανίχνευση για το αν η επικοινωνία ενός σκάφους είναι έγκυρη ή αποτελεί πιθανή απειλή στον κυβερνοχώρο. Μπορεί επίσης να χρησιμοποιηθεί για παλινδρόμηση, όπου το μοντέλο προβλέπει συνεχείς τιμές, όπως η εκτίμηση της κατανάλωσης καυσίμων με βάση την ταχύτητα, το βάρος του φορτίου και τις καιρικές συνθήκες.
Σε μια άλλη προσέγγιση, γνωστή ως μη επιβλεπόμενη μάθηση, το σύστημα λειτουργεί με πληροφορίες που δεν φέρουν ετικέτες, οπότε πρέπει να ανακαλύψει μόνο του κρυμμένα μοτίβα, όπως η ομαδοποίηση παρόμοιων στοιχείων. Αυτό είναι χρήσιμο στον τομέα της θαλάσσιας κυβερνοασφάλειας κατά την ανάλυση της δικτυακής κίνησης για τον εντοπισμό ανωμαλιών που ενδέχεται να υποδηλώνουν κυβερνοεπιθέσεις, καθώς το σύστημα μπορεί να ομαδοποιήσει τη φυσιολογική και ανώμαλη συμπεριφορά χωρίς να ξέρει πώς μοιάζει μια επίθεση.
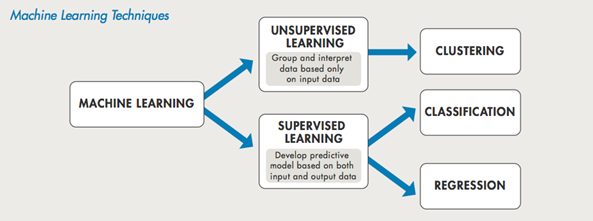
Σχήμα 24: Τεχνικές μηχανικής μάθησης
Μια τρίτη προσέγγιση, που ονομάζεται ενισχυτική μάθηση (RL), περιλαμβάνει τη μάθηση μέσω δοκιμών και σφαλμάτων. Σε αντίθεση με την επιβλεπόμενη μάθηση, όπου στο σύστημα παρέχονται επισημασμένα παραδείγματα σωστών απαντήσεων, η ενισχυτική μάθηση λειτουργεί σε ένα περιβάλλον όπου πρέπει να ανακαλύψει τη βέλτιστη συμπεριφορά μέσω της αλληλεπίδρασης. Το σύστημα, που συχνά αναφέρεται ως «πράκτορας», δοκιμάζει διαφορετικές ενέργειες μέσα σε αυτό το περιβάλλον και λαμβάνει ανατροφοδότηση με τη μορφή ανταμοιβών ή ποινών. Μια ανταμοιβή σηματοδοτεί ότι μια ενέργεια είναι επιθυμητή, ενώ μια ποινή υποδηλώνει μια ανεπιθύμητη ενέργεια. Ο στόχος του πράκτορα είναι να μάθει μια «πολιτική», η οποία είναι μια αντιστοίχιση από καταστάσεις (την τρέχουσα κατάσταση στην οποία βρίσκεται ο πράκτορας) σε ενέργειες, που μεγιστοποιεί τη συνολική του ανταμοιβή με την πάροδο του χρόνου. Για παράδειγμα, στον έλεγχο ρομπότ, η RL μπορεί να χρησιμοποιηθεί για να μάθει σε ένα ρομπότ να περπατάει. Το ρομπότ αρχίζει κάνοντας τυχαία βήματα, λαμβάνοντας ανατροφοδότηση με βάση τη σταθερότητα, την ενεργειακή απόδοση και την κίνηση προς τα εμπρός. Μέσα από πολλές επαναλήψεις, μαθαίνει να προσαρμόζει τις κινήσεις των αρθρώσεών του ώστε να περπατά πιο αποτελεσματικά, βελτιώνοντας την ισορροπία και ελαχιστοποιώντας την κατανάλωση ενέργειας (Song et al., 2021).
Η βαθιά μάθηση (DL) φέρνει την τεχνητή νοημοσύνη ένα βήμα παραπέρα, προσπαθώντας να μιμηθεί τον τρόπο με τον οποίο ο ανθρώπινος εγκέφαλος επεξεργάζεται τις πληροφορίες. Στην ουσία, χρησιμοποιεί τεχνητά νευρωνικά δίκτυα, τα οποία έχουν δομή παρόμοια με αυτή των βιολογικών νευρώνων, για να μαθαίνει και να αναγνωρίζει αυτόματα μοτίβα σε τεράστιες ποσότητες δεδομένων. Σε αντίθεση με την παραδοσιακή μηχανική μάθηση, όπου οι άνθρωποι συχνά πρέπει να επιλέγουν και να ορίζουν χειροκίνητα τα πιο σημαντικά χαρακτηριστικά για να λειτουργήσει ένα μοντέλο, τα μοντέλα βαθιάς μάθησης εξάγουν αυτά τα χαρακτηριστικά από μόνα τους, κατανοώντας τα ακατέργαστα δεδομένα χωρίς ρητή προγραμματιστική παρέμβαση.
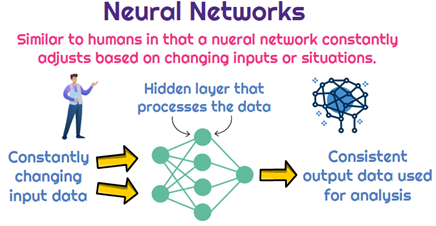
Σχήμα 25: Συστήματα Προσαρμοστικής Μάθησης Που Επεξεργάζονται Μεταβαλλόμενα Δεδομένα Εισόδου για τη Δημιουργία Συνεπών Αποτελεσμάτων προς Ανάλυση.
Όπως ο ανθρώπινος εγκέφαλος διαθέτει εξειδικευμένες περιοχές για διαφορετικές λειτουργίες, έτσι και τα μοντέλα βαθιάς μάθησης σχεδιάζονται με αρχιτεκτονικές που εστιάζουν σε συγκεκριμένους τύπους δεδομένων. Κατά την επεξεργασία οπτικών πληροφοριών, για παράδειγμα, ο οπτικός φλοιός του εγκεφάλου αναγνωρίζει αντικείμενα ανιχνεύοντας άκρα, σχήματα και υφές πριν σχηματίσει μια ολοκληρωμένη εικόνα. Με αφορμή αυτό, τα Συνελικτικά Νευρωνικά Δίκτυα (CNN) (Jorgecardete, 2025) σχεδιάστηκαν για να χειρίζονται εργασίες που σχετίζονται με την όραση, μαθαίνοντας αυτόματα τα σχετικά χαρακτηριστικά από τις εικόνες χωρίς να απαιτείται η χειροκίνητη εισαγωγή δεδομένων. Για παράδειγμα, τα CNN μπορούν να χρησιμοποιηθούν για την αναγνώριση εκφράσεων του προσώπου, αναλύοντας εικόνες προσώπων και αναγνωρίζοντας συναισθήματα όπως ο θυμός, η χαρά ή η έκπληξη. Αντί να απαιτεί από τους ανθρώπους να ορίσουν χειροκίνητα πώς μοιάζει κάθε συναίσθημα, το μοντέλο μαθαίνει μοτίβα εξετάζοντας χιλιάδες εικόνες προσώπων. Μέσω επιπέδων συνελικτικής εφαρμογής και υποδειγματοληψίας, εξάγει σημαντικά χαρακτηριστικά, όπως κινήσεις και εκφράσεις των μυών του προσώπου, τα οποία στη συνέχεια υποβάλλονται σε επεξεργασία από πλήρως συνδεδεμένα στρώματα και ταξινομούνται χρησιμοποιώντας μια συνάρτηση SoftMax για τον προσδιορισμό του πιο πιθανού συναισθήματος.
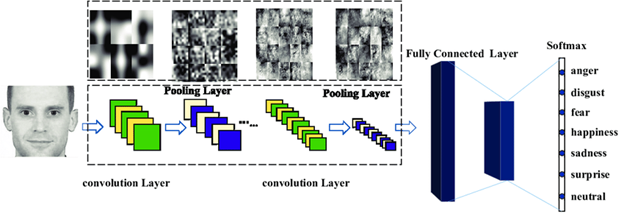
Σχήμα 26: Ροή Αναγνώρισης Συναισθημάτων Προσώπου βάσει Βαθιάς Μάθησης.
Η μνήμη και η επεξεργασία ακολουθιών στον ανθρώπινο εγκέφαλο διαδραματίζουν επίσης καθοριστικό ρόλο στη λήψη αποφάσεων και στην αναγνώριση προτύπων, και σε αυτό το σημείο μπαίνουν στο προσκήνιο τα μοντέλα βαθιάς μάθησης όπως τα Επαναληπτικά Νευρωνικά Δίκτυα (RNN) και τα Δίκτυα Μακράς Βραχυπρόθεσμης Μνήμης (LSTM). Αυτά τα μοντέλα προσπαθούν να αναπαράγουν τον τρόπο με τον οποίο οι άνθρωποι θυμούνται τις εμπειρίες του παρελθόντος και τις χρησιμοποιούν για να επηρεάσουν τις τρέχουσες αποφάσεις. Είναι ιδιαίτερα αποτελεσματικά στη διαχείριση διαδοχικών δεδομένων, όπως η γλώσσα, οι προβλέψεις χρονοσειρών ή η ανάλυση της κίνησης δικτύου.
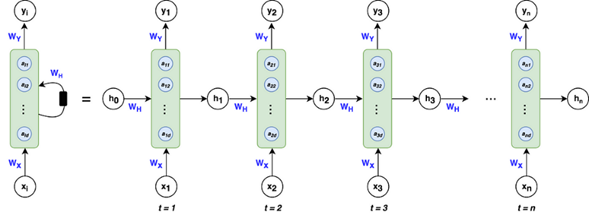
Σχήμα 27: Αρχιτεκτονική Απλού Επαναλαμβανόμενου Νευρωνικού Δικτύου
(Khuong, 2025)
Η επεξεργασία γλώσσας είναι ένας άλλος τομέας στον οποίο ξεχωρίζει η βαθιά μάθηση, μιμούμενη τον τρόπο με τον οποίο ο ανθρώπινος εγκέφαλος ερμηνεύει και παράγει την ομιλία. Τα μοντέλα που βασίζονται σε μετασχηματιστές, όπως τα BERT και GPT, αναλύουν τεράστιες ποσότητες κειμένου, μαθαίνοντας να κατανοούν γλωσσικά μοτίβα χωρίς την ανάγκη προκαθορισμένων γραμματικών κανόνων. Στον τομέα της κυβερνοασφάλειας στη ναυτιλία, τέτοια μοντέλα μπορούν να σαρώνουν μηνύματα email, ραδιοεπικοινωνίες και αρχεία καταγραφής συστημάτων για να εντοπίζουν απόπειρες phishing, δόλια μηνύματα ή μη εξουσιοδοτημένες οδηγίες με τη μορφή συνήθους επικοινωνίας. Αντί να βασίζονται στην απλή ανίχνευση λέξεων-κλειδιών, αυτά τα μοντέλα κατανοούν το πλαίσιο και την πρόθεση, γεγονός που τα καθιστά εξαιρετικά αποτελεσματικά στην επισήμανση μη ορατών απειλών που τα παραδοσιακά συστήματα βάσει κανόνων θα παράβλεπαν.
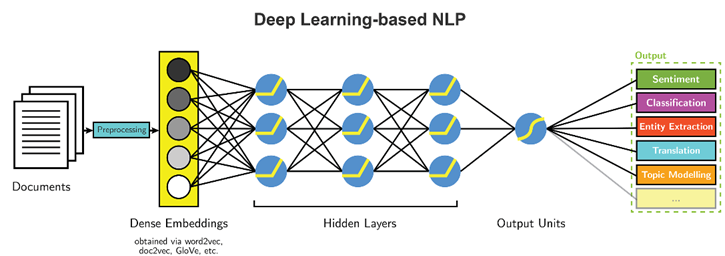
Σχήμα 28: Επεξεργασία φυσικής γλώσσας (NLP) βάσει Βαθιάς Μάθησης (DL).
Η βασική δύναμη της Βαθιάς Μάθησης είναι η ικανότητά της να αντλεί αυτόματα σχετικά χαρακτηριστικά από τεράστιο όγκο μη δομημένων δεδομένων. Σε αντίθεση με τις παραδοσιακές μεθόδους μηχανικής μάθησης, όπου οι ειδικοί πρέπει να σχεδιάσουν τα χαρακτηριστικά (δηλαδή να αποφασίσουν ποια στοιχεία των δεδομένων είναι σημαντικά), τα μοντέλα Βαθιάς Μάθησης διακρίνονται για την ικανότητά τους να εντοπίζουν αυτά τα χαρακτηριστικά αυτόνομα, όπως φαίνεται στο Σχήμα 29. Είτε τα δεδομένα αποτελούνται από εικόνες, αρχεία καταγραφής δικτύου, μετρήσεις αισθητήρων ή κείμενο, το σύστημα αναλύει πολυάριθμα παραδείγματα, βελτιώνοντας σταδιακά την κατανόησή του και εντοπίζοντας αυτόνομα τα μοτίβα με τη μεγαλύτερη πληροφοριακή αξία. Αυτό εξαλείφει την ανάγκη για χειροκίνητη διαμόρφωση χαρακτηριστικών, μια διαδικασία που μπορεί να είναι χρονοβόρα, απαιτεί εξειδικευμένη τεχνογνωσία στον συγκεκριμένο τομέα και ενδέχεται να μην καταγράφει όλες τις λεπτές αποχρώσεις που κρύβονται μέσα στα δεδομένα.
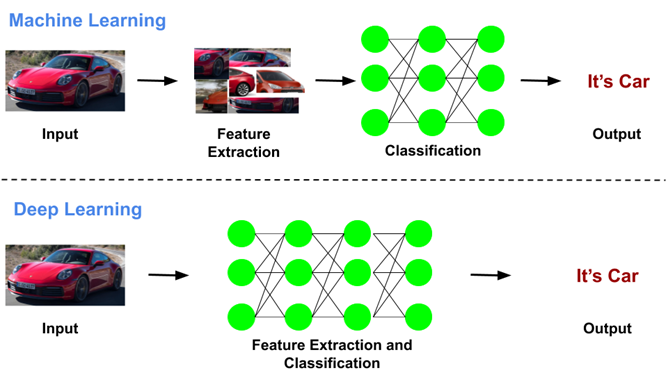
Σχήμα 29: Διαφορές μεταξύ της ροής εργασιών της μηχανικής μάθησης και της βαθιάς μάθησης.
Στη ναυτιλία, η Τεχνητή Νοημοσύνη μπορεί να ενσωματωθεί σε συστήματα κυβερνοασφάλειας για την επεξεργασία των τεράστιων ποσοτήτων δεδομένων που παράγονται από πλοία, λιμένες και δορυφορικές συνδέσεις. Καθώς οι απειλές εξελίσσονται, τα μοντέλα Μηχανικής Μάθησης και Βαθιάς Μάθησης ενημερώνονται συνεχώς χρησιμοποιώντας νέες πληροφορίες, εντοπίζοντας κινδύνους ή επιθέσεις που ενδέχεται να μην έχουν περιγραφεί ποτέ ρητά από κανόνες που γράφτηκαν από τον άνθρωπο. Αυτή η ικανότητα προσαρμογής και βελτίωσης με την πάροδο του χρόνου καθιστά την Τεχνητή Νοημοσύνη ιδιαίτερα πολύτιμη για την αντιμετώπιση των σύγχρονων προκλήσεων στον τομέα της κυβερνοασφάλειας.
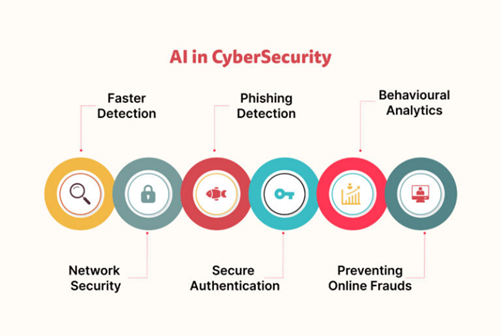
Figure 30: Applications of Ai in Cybersecurity4.
Ανάπτυξη Μοντέλων Μηχανικής Μάθησης/Βαθιάς Μάθησης
Η διαδικασία ανάπτυξης ενός μοντέλου Μηχανικής Μάθησης ή Βαθιάς Μάθησης ακολουθεί μια οργανωμένη σειρά βημάτων, από τη συλλογή δεδομένων έως την εφαρμογή και τη συντήρηση του μοντέλου. Κάθε βήμα διαδραματίζει καθοριστικό ρόλο ώστε το σύστημα να κάνει ακριβείς και αξιόπιστες προβλέψεις υπό πραγματικές συνθήκες. Ακολουθεί μια λεπτομερής ανάλυση ολόκληρης της διαδικασίας, μαζί με επεξηγήσεις που την καθιστούν πιο κατανοητή για όσους δεν είναι εξοικειωμένοι με τον τομέα.
Συλλογή δεδομένων: Συγκέντρωση Σχετικών Πληροφοριών
Το πρώτο βήμα σε κάθε έργο Μηχανικής Μάθησης ή Βαθιάς Μάθησης είναι η συλλογή δεδομένων. Χωρίς δεδομένα υψηλής ποιότητας, ακόμη και οι καλύτεροι αλγόριθμοι δυσκολεύονται να παράγουν χρήσιμα αποτελέσματα. Τα δεδομένα μπορεί να προέρχονται από διάφορες πηγές, ανάλογα με το εκάστοτε πρόβλημα. Στην περίπτωση της κυβερνοασφάλειας στη ναυτιλία, για παράδειγμα, τα σχετικά δεδομένα μπορεί να περιλαμβάνουν αρχεία καταγραφής δικτυακής κίνησης, αρχεία συμβάντων ασφαλείας και δείκτες απόδοσης του συστήματος. Τα αρχεία καταγραφής δικτύου καταγράφουν την επικοινωνία μεταξύ συσκευών, βοηθώντας στον εντοπισμό ασυνήθιστων μοτίβων που ενδέχεται να υποδηλώνουν κυβερνοαπειλές. Τα αρχεία καταγραφής συμβάντων ασφαλείας περιέχουν ειδοποιήσεις που δημιουργούνται από συστήματα κυβερνοασφάλειας όταν εντοπίζεται ύποπτη δραστηριότητα. Τα δεδομένα απόδοσης του συστήματος, όπως η χρήση της CPU ή η δραστηριότητα της μνήμης, προσφέρουν πληροφορίες για πιθανές παραβιάσεις ασφαλείας ή βλάβες. Ο τύπος των δεδομένων που συλλέγονται εξαρτάται εξ ολοκλήρου από το συγκεκριμένο πρόβλημα προς επίλυση από το μοντέλο. Για την ανίχνευση εισβολών, ενδέχεται να απαιτούνται δεδομένα δικτύου σε επίπεδο δέσμης, ενώ για την επιτήρηση πλοίων, θα ήταν πιο συναφές το βιντεοσκοπημένο υλικό σε πραγματικό χρόνο.
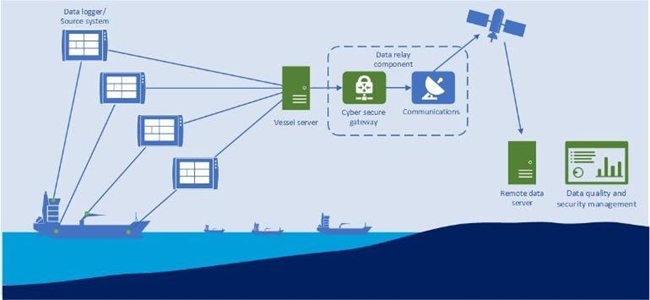
Σχήμα 31: Παράδειγμα Συλλογής Δεδομένων στη ναυτιλία .
Προετοιμασία Δεδομένων: Καθαρισμός και Μορφοποίηση Δεδομένων για Ανάλυση
Τα ακατέργαστα δεδομένα είναι συχνά αδόμητα, ασυνεπή ή περιέχουν σφάλματα που επηρεάζουν αρνητικά την απόδοση του μοντέλου. Για να διασφαλιστεί η χρηστικότητα των δεδομένων, πρέπει πρώτα να περάσουν από μια φάση προετοιμασίας. Αυτή η διαδικασία περιλαμβάνει διάφορα βασικά βήματα, όπως η διαχείριση των ελλιπών τιμών, η απομάκρυνση του θορύβου και η τυποποίηση των εισροών. Οι ελλιπείς τιμές μπορεί να οφείλονται σε ελαττωματικούς αισθητήρες ή σε μη ολοκληρωμένα αρχεία καταγραφής και πρέπει να επιλυθούν είτε συμπληρώνοντάς τις με εκτιμώμενες τιμές είτε απορρίπτοντας τα μη ολοκληρωμένα αρχεία. Ο θόρυβος, όπως τα κατεστραμμένα σημεία δεδομένων ή οι μη σχετικές πληροφορίες, πρέπει να αφαιρούνται για να αποτραπεί η εκμάθηση λανθασμένων προτύπων από το μοντέλο. Η τυποποίηση αποτελεί ένα άλλο κρίσιμο βήμα, καθώς τα δεδομένα συχνά διατίθενται σε διαφορετικές μορφές ή μονάδες. Για παράδειγμα, ενδεχομένως να είναι απαραίτητη η μετατροπή της χρονοσήμανσης στα αρχεία καταγραφής δικτύου σε μια ενιαία ζώνη ώρας, ή η κανονικοποίηση των αριθμητικών τιμών ώστε να διασφαλιστεί ότι βρίσκονται σε συγκρίσιμη κλίμακα. Στα δομημένα σύνολα δεδομένων, όπως πίνακες δραστηριότητας δικτύου, αυτή η φάση μπορεί επίσης να περιλαμβάνει την αφαίρεση διπλών εγγραφών. Όσον αφορά τα μη δομημένα δεδομένα, όπως εικόνες ή κείμενο, η εκ των προτέρων επεξεργασία μπορεί να περιλαμβάνει την αλλαγή μεγέθους εικόνων, τη μείωση του θορύβου φόντου ή τη μετατροπή λέξεων σε αριθμητικές αναπαραστάσεις που μπορεί να επεξεργαστεί το μοντέλο.
Μηχανική Χαρακτηριστικών: Προσδιορισμός ή Δημιουργία Σημαντικών Προτύπων
Στην παραδοσιακή μηχανική μάθηση, τα μοντέλα δεν κατανοούν εκ φύσεως ποιες πτυχές των δεδομένων είναι σχετικές. Αντίθετα, οι ειδικοί πρέπει να καθορίσουν χειροκίνητα τα πιο χρήσιμα χαρακτηριστικά για την επίλυση του προβλήματος. Αυτή η διαδικασία, γνωστή ως μηχανική χαρακτηριστικών, περιλαμβάνει την επιλογή, τον μετασχηματισμό ή τη δημιουργία νέων μεταβλητών από τα ακατέργαστα δεδομένα, με σκοπό τη βελτίωση της απόδοσης του μοντέλου. Η αποτελεσματική επεξεργασία χαρακτηριστικών μπορεί να βελτιώσει σημαντικά την ακρίβεια ενός μοντέλου, παρέχοντάς του ουσιαστικές πληροφορίες. Για παράδειγμα, σε ένα σύστημα ανίχνευσης εισβολών, τα ακατέργαστα αρχεία καταγραφής της δικτυακής κίνησης μπορεί να περιέχουν λεπτομέρειες όπως διευθύνσεις IP, χρονοσήμανση, μεγέθη δέσμης και καταστάσεις σύνδεσης. Ωστόσο, αυτές οι ακατέργαστες τιμές από μόνες τους ενδέχεται να μην παρέχουν επαρκείς πληροφορίες στο μοντέλο. Για να βελτιώσει την ανίχνευση, ένας ειδικός μπορεί να δημιουργήσει νέα χαρακτηριστικά με βάση στατιστικά μοτίβα ή τάσεις συμπεριφοράς. Ένα τέτοιο χαρακτηριστικό ενδέχεται να είναι ο ρυθμός απόπειρας σύνδεσης, όπου μετράται ο αριθμός των αιτήσεων σύνδεσης από μια συγκεκριμένη διεύθυνση IP εντός ενός δεδομένου χρονικού διαστήματος, για παράδειγμα 10 δευτερόλεπτα. Μια ξαφνική αύξηση στις απόπειρες σύνδεσης μπορεί να υποδηλώνει μια επίθεση brute-force.
Η βαθιά μάθηση, ωστόσο, εξαλείφει σε μεγάλο βαθμό την ανάγκη για μηχανική χαρακτηριστικών. Αντί να βασίζεται στην ανθρώπινη διαίσθηση για τον καθορισμό σημαντικών χαρακτηριστικών, τα βαθιά νευρωνικά δίκτυα μαθαίνουν τα αυτόματα μοτίβα απευθείας από τα ακατέργαστα δεδομένα. Αυτό αποτελεί ένα από τα σημαντικότερα πλεονεκτήματα της βαθιάς μάθησης έναντι της παραδοσιακής μηχανικής μάθησης. Μπορεί να επεξεργάζεται μη δομημένα δεδομένα, όπως εικόνες, ήχο και κείμενο, χωρίς την ανάγκη συγκεκριμένων κανόνων για να εξάγει τα χαρακτηριστικά. Για παράδειγμα, στην αναγνώριση εικόνων, ένα συνελικτικό νευρωνικό δίκτυο μαθαίνει να αναγνωρίζει ακμές, υφές και σύνθετα αντικείμενα χωρίς ανθρώπινη παρέμβαση, με αποτέλεσμα να είναι εξαιρετικά αποτελεσματικό για εφαρμογές όπως η ανάλυση βιντεοσκοπημένου υλικού επιτήρησης σε πραγματικό χρόνο σε πλοία.
Επιλογή μοντέλου: Επιλέγοντας τον Σωστό Αλγόριθμο
Αφού τα δεδομένα διαμορφωθούν, το επόμενο βήμα είναι η επιλογή του βέλτιστου μοντέλου για το συγκεκριμένο πρόβλημα. Η επιλογή του αλγορίθμου εξαρτάται από παράγοντες όπως ο τύπος των δεδομένων, η πολυπλοκότητα της εργασίας και οι διαθέσιμοι υπολογιστικοί πόροι. Στην παραδοσιακή μηχανική μάθηση, χρησιμοποιούνται συνήθως μοντέλα όπως τα δέντρα αποφάσεων, οι μηχανές υποστήριξης διανυσμάτων (SVM) ή τα τυχαία δάση, ιδίως όταν πρόκειται για δομημένα σύνολα δεδομένων. Αυτά τα μοντέλα απαιτούν χαρακτηριστικά που ορίζονται χειροκίνητα, αλλά αποδίδουν καλά και με σχετικά μικρά σύνολα δεδομένων.
Τα μοντέλα βαθιάς μάθησης, αφετέρου, είναι πιο ισχυρά, αλλά απαιτούν μεγάλο όγκο δεδομένων και υπολογιστικούς πόρους. Τα CNN είναι ιδιαίτερα αποτελεσματικά για εργασίες συναφείς με εικόνες, όπως η ανίχνευση αντικειμένων σε βίντεο θαλάσσιας επιτήρησης. Τα επαναλαμβανόμενα νευρωνικά δίκτυα ή οι μετασχηματιστές ταιριάζουν καλύτερα σε διαδοχικά δεδομένα, όπως η ανάλυση αρχείων καταγραφής επικοινωνίας σε βάθος χρόνου για τον εντοπισμό μοτίβων κυβερνοαπειλών. Η επιλογή του σωστού μοντέλου αποτελεί κρίσιμο βήμα, καθώς μια λανθασμένη επιλογή μπορεί να οδηγήσει σε χαμηλή απόδοση ή σε αναποτελεσματικούς υπολογισμούς.
Εκπαίδευση μοντέλου: Μάθηση από Δεδομένα
Αφού επιλέξετε ένα μοντέλο, το επόμενο βήμα είναι η εκπαίδευσή του ώστε να μπορεί να κάνει προβλέψεις. Η εκπαίδευση περιλαμβάνει την εισαγωγή δεδομένων στο μοντέλο για να μάθει μοτίβα και την προσαρμογή των εσωτερικών παραμέτρων του για να βελτιώσει την ακρίβεια. Το μοντέλο κάνει αρχικές προβλέψεις και μια συνάρτηση απώλειας μετρά τον βαθμό απόκλισης αυτών των προβλέψεων από τις σωστές απαντήσεις. Αν η απώλεια είναι υψηλή, αυτό σημαίνει ότι το μοντέλο κάνει κακές προβλέψεις. Προκειμένου να βελτιωθεί, μια διαδικασία βελτιστοποίησης, όπως η καθοδική κλίση, ενημερώνει τις παραμέτρους του μοντέλου (γνωστές ως βάρη), ώστε να μειώνεται σταδιακά η απώλεια. Αυτή η επαναληπτική διαδικασία συνεχίζεται μέχρι το μοντέλο να φτάσει σε ένα αποδεκτό επίπεδο ακρίβειας.
Στην επιβλεπόμενη μάθηση, το μοντέλο εκπαιδεύεται σε επισημασμένα δεδομένα, δηλαδή κάθε είσοδος έχει μια γνωστή σωστή έξοδο (π.χ. ετικέτες κλάσεων στην ταξινόμηση ή τιμές-στόχους στην παλινδρόμηση). Ο στόχος είναι να ελαχιστοποιηθεί η διαφορά μεταξύ των προβλέψεων και των πραγματικών ετικετών, χρησιμοποιώντας συνήθως συναρτήσεις απώλειας όπως η διασταυρούμενη εντροπία (για ταξινόμηση) ή το μέσο τετραγωνικό σφάλμα (για παλινδρόμηση).
Στη βαθιά μάθηση, αυτή η διαδικασία είναι υπολογιστικά απαιτητική και χρειάζεται μεγάλα σύνολα δεδομένων. Σε αντίθεση με την παραδοσιακή μηχανική μάθηση, όπου η εκπαίδευση ολοκληρώνεται σε λίγα λεπτά ή ώρες, η εκπαίδευση των βαθιών νευρωνικών δικτύων διαρκεί ημέρες ή ακόμα και εβδομάδες, ανάλογα με την πολυπλοκότητα της αρχιτεκτονικής και το μέγεθος των δεδομένων. Για την αντιμετώπιση αυτής της πολυπλοκότητας, τα πλαίσια βαθιάς μάθησης όπως το TensorFlow και το PyTorch παρέχουν αποτελεσματικά εργαλεία για τη δημιουργία μοντέλων, την αυτόματη διαφοροποίηση και την επιτάχυνση υλικού. Αυτές οι βιβλιοθήκες υποστηρίζουν δυναμικά υπολογιστικά γραφήματα και προσφέρουν ένα ευρύ φάσμα προκατασκευασμένων συναρτήσεων για τη βελτιστοποίηση μοντέλων. Η ρύθμιση των υπερπαραμέτρων, δηλαδή η προσαρμογή παραμέτρων όπως ο ρυθμός μάθησης, το μέγεθος της δέσμης και ο αριθμός των εποχών εκπαίδευσης, είναι απαραίτητη για να διασφαλιστεί ότι το μοντέλο συγκλίνει αποτελεσματικά.
Στη μη επιβλεπόμενη μάθηση, το μοντέλο εκπαιδεύεται σε δεδομένα χωρίς ετικέτες, δηλαδή δεν διαθέτει προκαθορισμένες κατηγορίες ή σωστές απαντήσεις. Αντί να προβλέπει συγκεκριμένα αποτελέσματα, το μοντέλο εντοπίζει μοτίβα, δομές ή ομάδες στα δεδομένα.
-
Οι αλγόριθμοι ομαδοποίησης ομαδοποιούν παρόμοια σημεία δεδομένων με βάση μετρήσεις απόστασης.
-
Οι τεχνικές μείωσης διαστάσεων συμπιέζουν δεδομένα υψηλών διαστάσεων σε μια μορφή χαμηλότερων διαστάσεων, διατηρώντας παράλληλα τις βασικές πληροφορίες.
-
Τα παραγωγικά μοντέλα μαθαίνουν να δημιουργούν νέα δείγματα δεδομένων που μοιάζουν με την κατανομή των δεδομένων εκπαίδευσης.
Δεδομένου ότι δεν υπάρχει ρητή συνάρτηση απώλειας για τη σύγκριση των προβλέψεων με την πραγματική τιμή, η εκπαίδευση συχνά περιλαμβάνει στόχους χωρίς επίβλεψη, όπως η ελαχιστοποίηση του σφάλματος ανακατασκευής ή η μεγιστοποίηση της διακύμανσης μεταξύ των ομάδων.
Επικύρωση και Δοκιμή Μοντέλου: Αξιολόγηση της Απόδοσης
Μόλις ολοκληρωθεί η εκπαίδευση, πρέπει να δοκιμαστεί πόσο καλά εφαρμόζεται το μοντέλο σε νέα, άγνωστα δεδομένα. Αυτό επιτυγχάνεται με επικύρωση και δοκιμή, χρησιμοποιώντας ξεχωριστά σύνολα δεδομένων που δεν περιλαμβάνονταν στη διαδικασία εκπαίδευσης. Αν ένα μοντέλο αποδίδει καλά κατά την εκπαίδευση αλλά δεν καταφέρνει να κάνει ακριβείς προβλέψεις σε νέα δεδομένα, είναι πιθανό να έχει υποστεί υπερπροσαρμογή, δηλαδή να έχει μάθει μοτίβα που είναι υπερβολικά συγκεκριμένα για το σύνολο εκπαίδευσης και δεν εφαρμόζεται καλά σε άγνωστα δεδομένα. Οι μετρήσεις απόδοσης, όπως η ακρίβεια, η ακρίβεια πρόβλεψης, η ανάκληση και το F1-score, χρησιμοποιούνται για την αξιολόγηση της αποτελεσματικότητας του μοντέλου. Η ακρίβεια μετρά το ποσοστό των σωστών προβλέψεων, ενώ η ακρίβεια πρόβλεψης και η ανάκληση παρέχουν πληροφορίες σχετικά με την αξιοπιστία του μοντέλου ως προς την ανίχνευση συγκεκριμένων κατηγοριών, όπως οι κυβερνοαπειλές. Ο δείκτης F1 εξισορροπεί την ακρίβεια και την ανάκληση, προσφέροντας μια πιο ολοκληρωμένη αξιολόγηση. Αν η απόδοση του μοντέλου δεν είναι ικανοποιητική, μπορεί να γίνουν προσαρμογές συλλέγοντας περισσότερα δεδομένα, βελτιώνοντας την επιλογή χαρακτηριστικών (στο ML) ή ρυθμίζοντας τις υπερπαραμέτρους.
Εφαρμογή και Συνεχής Παρακολούθηση: Χρήση του μοντέλου στον Πραγματικό Κόσμο
Μόλις το μοντέλο επιτύχει ικανοποιητική ακρίβεια και ανθεκτικότητα, εφαρμόζεται σε ένα πραγματικό περιβάλλον, όπου αρχίζει να κάνει προβλέψεις σε δεδομένα σε πραγματικό χρόνο. Ωστόσο, η εφαρμογή δεν αποτελεί το τελικό στάδιο· απαιτείται συνεχής παρακολούθηση και συντήρηση για τη διασφάλιση της διαρκούς απόδοσης. Στον τομέα της ναυτιλιακής κυβερνοασφάλειας, για παράδειγμα, αναδύονται συνεχώς νέες κυβερνοαπειλές και ένα μοντέλο που εκπαιδεύτηκε με βάση τα προηγούμενα πρότυπα επιθέσεων ενδέχεται να καταστεί παρωχημένο με την πάροδο του χρόνου. Για να αποφευχθεί η μείωση της απόδοσης, τα μοντέλα χρειάζονται περιοδική επανεκπαίδευση με βάση τα ενημερωμένα δεδομένα, τη συνεχή παρακολούθηση για εντοπισμό σφαλμάτων και βελτιώσεις ώστε να προσαρμόζονται στις μεταβαλλόμενες συνθήκες. Αν αυτό δεν γίνει, μπορεί να οδηγήσει σε παρωχημένες προβλέψεις, κενά ασφαλείας ή χαμηλότερη ακρίβεια.
Στο Σχήμα 32 παρουσιάζεται μια γενική επισκόπηση της ροής εκπαίδευσης για ένα μοντέλο μηχανικής μάθησης με επίβλεψη.
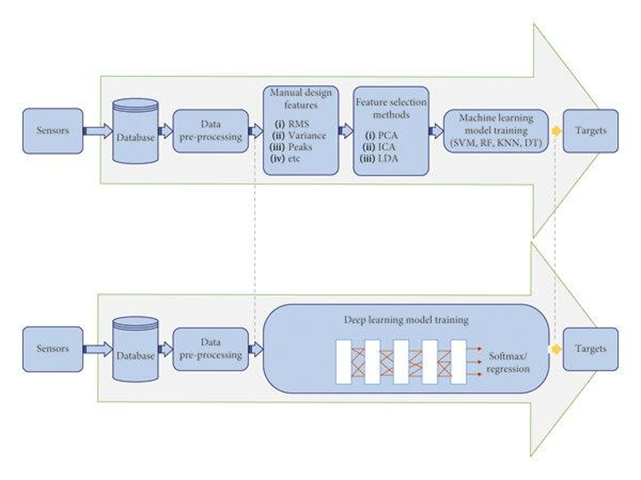
Σχήμα 32: Επισκόπηση των ροών εκπαίδευσης για μοντέλα ML/DL.
Εφαρμογές της Τεχνητής Νοημοσύνης στην κυβερνοασφάλεια του Ναυτιλιακού Τομέα
Συστήματα Ανίχνευσης Εισβολών (IDS)
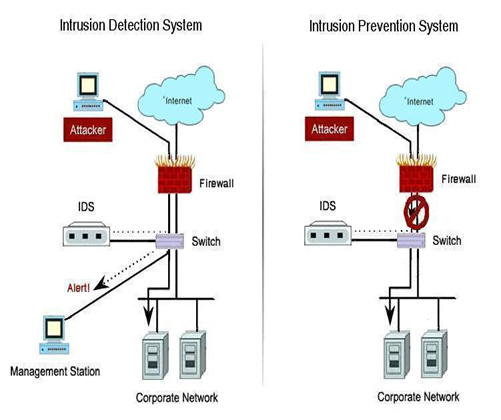
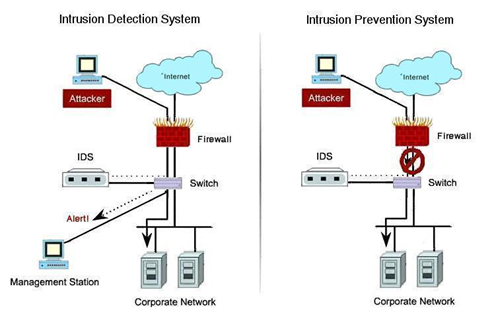
Το Σύστημα Ανίχνευσης Εισβολών (IDS) είναι μια λύση ασφάλειας που σχεδιάστηκε για την ανίχνευση μη εξουσιοδοτημένης πρόσβασης, κακόβουλης δραστηριότητας και πιθανών απειλών μέσω της συνεχούς παρακολούθησης της δικτυακής κίνησης, της συμπεριφοράς των χρηστών και των αρχείων καταγραφής του συστήματος. Η θέση εγκατάστασης ενός IDS εξαρτάται από τον τύπο του. Ένα σύστημα IDS βάσει δικτύου (NIDS) τοποθετείται συνήθως μεταξύ του τείχους προστασίας και του εσωτερικού δικτύου, όπως φαίνεται στο Σχήμα 33, όπου ελέγχει όλη την εισερχόμενη και εξερχόμενη κίνηση για ύποπτα μοτίβα πριν αυτά προσβάλουν κρίσιμα συστήματα. Αν ένας εισβολέας παρακάμψει το firewall, το IDS ανιχνεύει ανωμαλίες και εκπέμπει ειδοποίηση για περαιτέρω διερεύνηση. Αφετέρου, ένα IDS βάσει κεντρικού υπολογιστή (HIDS) εγκαθίσταται απευθείας σε μεμονωμένες συσκευές, όπως το σύστημα πλοήγησης ενός πλοίου, διακομιστές ή σταθμούς εργασίας, όπου παρακολουθεί τα αρχεία καταγραφής του συστήματος, την ακεραιότητα των αρχείων και τη δραστηριότητα των χρηστών για τον εντοπισμό κακόβουλων αλλαγών. Στο ναυτιλιακό πλαίσιο, τα IDS διαδραματίζουν σημαντικό ρόλο στην προστασία κρίσιμων λειτουργιών, όπως η διαχείριση φορτίου, η πλοήγηση και τα δίκτυα επικοινωνίας (MarPoint, 2025).
Το DS χρησιμοποιεί δύο βασικές προσεγγίσεις για την ανίχνευση κακόβουλης συμπεριφοράς:
-
Ανίχνευση βάσει υπογραφών: Συγκρίνει τις παρατηρούμενες δραστηριότητες με μια βάση δεδομένων γνωστών υπογραφών επιθέσεων, χρησιμοποιώντας τεχνικές αντιστοίχισης συμβολοσειρών. Αυτή η μέθοδος είναι ιδιαίτερα αποτελεσματική για τον εντοπισμό ήδη γνωστών απειλών, αλλά δεν καταφέρνει να ανιχνεύσει νέες ή εξελισσόμενες επιθέσεις.
-
Ανίχνευση βάσει συμπεριφοράς: Παρακολουθεί τις αποκλίσεις από τα συνήθη πρότυπα δραστηριότητας, επιτρέποντας τον εντοπισμό νέων ή άγνωστων απειλών. Αν και είναι πιο ευέλικτη, αυτή η μέθοδος ενδέχεται να προκαλέσει περισσότερα ψευδώς θετικά αποτελέσματα.
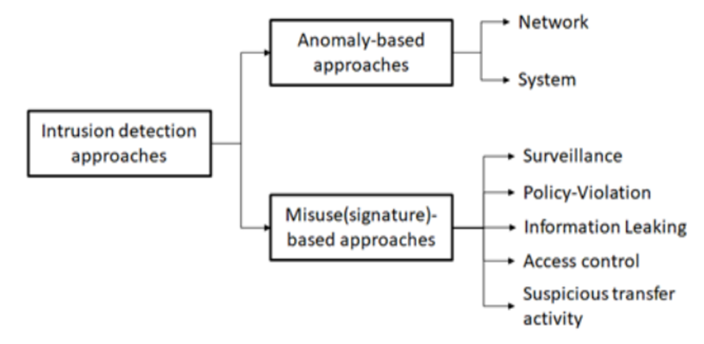
Σχήμα 34: Ταξινόμηση των Προσεγγίσεων Ανίχνευσης Εισβολών.
Τα IDS βάσει Τεχνητής Νοημοσύνης (AI) ενισχύουν την ασφάλεια αναλύοντας δεδομένα σε πραγματικό χρόνο, εντοπίζοντας ανωμαλίες και διακρίνοντας τα τυπικά μοτίβα δικτύου από επιβλαβείς εισβολές. Ενσωματώνοντας τόσο επιβλεπόμενες μεθόδους, οι οποίες βασίζονται σε γνωστές υπογραφές επιθέσεων, όσο και μη επιβλεπόμενες μεθόδους, οι οποίες ανιχνεύουν ασυνήθιστες αποκλίσεις από την κανονική δραστηριότητα, τα IDS βάσει AI μειώνουν τους ψευδείς συναγερμούς και βελτιώνουν την ακρίβεια ανίχνευσης.
Τα IDS βάσει Τεχνητής Νοημοσύνης χρησιμοποιούν αλγόριθμους μηχανικής μάθησης για τον εντοπισμό απειλών με μεγαλύτερη ακρίβεια. Αυτοί οι αλγόριθμοι βοηθούν τα συστήματα IDS να αναγνωρίζουν τόσο γνωστά όσο και άγνωστα είδη κυβερνοεπιθέσεων.
-
Επιβλεπόμενη Μάθηση: Αυτή η προσέγγιση εκπαιδεύει ένα μοντέλο Τεχνητής Νοημοσύνης χρησιμοποιώντας ιστορικά δεδομένα επιθέσεων που επισημαίνονται ως «ασφαλή» ή «επικίνδυνα». Η Τεχνητή Νοημοσύνη μαθαίνει από αυτά τα δεδομένα και στη συνέχεια εφαρμόζει τις γνώσεις της για την ανίχνευση νέων απειλών.
-
Μη επιβλεπόμενη μάθηση: Σε αντίθεση με την επιβλεπόμενη μάθηση, σε αυτή τη μέθοδο τα δεδομένα με ετικέτες δεν είναι απαραίτητα. Αντ’ αυτού, η Τεχνητή Νοημοσύνη εντοπίζει ασυνήθιστη δραστηριότητα ανιχνεύοντας μοτίβα που αποκλίνουν από την κανονική συμπεριφορά.
Ένα συνηθισμένο πρόβλημα των συμβατικών συστημάτων IDS είναι τα ψευδώς θετικά αποτελέσματα, όπου η αβλαβής δραστηριότητα στο δίκτυο επισημαίνεται λανθασμένα ως απειλή. Η Τεχνητή Νοημοσύνη μειώνει τους ψευδείς συναγερμούς μαθαίνοντας από προηγούμενα λάθη και βελτιώνοντας την ακρίβειά της με την πάροδο του χρόνου. Η AI επίσης συνδυάζει πολλαπλές μεθόδους ανίχνευσης για τη βελτίωση των αποτελεσμάτων. Συνδυάζοντας την ανίχνευση βάσει υπογραφών και την ανίχνευση βάσει συμπεριφοράς, τα συστήματα IDS βάσει Τεχνητής Νοημοσύνης ελαχιστοποιούν τα σφάλματα, διατηρώντας παράλληλα υψηλό επίπεδο ασφάλειας. Ορισμένα μοντέλα Τεχνητής Νοημοσύνης χρησιμοποιούν μάλιστα την ενισχυτική μάθηση, μια τεχνική κατά την οποία η Τεχνητή Νοημοσύνη προσαρμόζει συνεχώς τους κανόνες ανίχνευσής της με βάση την ανατροφοδότηση.
Δεδομένου ότι το IDS είναι ένα παθητικό σύστημα, δεν προβαίνει σε άμεση δράση κατά των απειλών που εντοπίζει. Αντ’ αυτού, εκπέμπει ειδοποιήσεις προς τους χειριστές ή ενσωματώνεται σε συστήματα διαχείρισης πληροφοριών και συμβάντων ασφαλείας (SIEM) για περαιτέρω ανάλυση και αντίδραση. Οι εισβολές μπορεί να προέρχονται τόσο από εξωτερικές όσο και από εσωτερικές πηγές, καθιστώντας το IDS βασικό συστατικό των στρατηγικών κυβερνοασφάλειας σε όλους τους κλάδους.
Συστήματα Πρόληψης Εισβολών (IPS)
Το Σύστημα Πρόληψης Εισβολών (IPS) είναι μια τεχνολογία ασφάλειας που σχεδιάστηκε για την ανίχνευση και την πρόληψη κακόβουλων δραστηριοτήτων εντός ενός δικτύου ή συστήματος. Σε αντίθεση με το IDS, το οποίο παρακολουθεί παθητικά και ειδοποιεί για ύποπτες δραστηριότητες, το IPS αναλαμβάνει άμεση δράση για να αποκλείσει, να μετριάσει ή να σταματήσει τις επιθέσεις σε πραγματικό χρόνο. Ουσιαστικά, ενώ το IDS αποτελεί εργαλείο παρακολούθησης, το IPS λειτουργεί ως σύστημα ελέγχου που αποτρέπει ενεργά τις απειλές προτού προκαλέσουν ζημιά σε λειτουργίες όπως η πλοήγηση, η διακίνηση φορτίων ή οι επικοινωνιακές συνδέσεις (Sowmya and Anita, 2023).
Το IPS συνήθως εγκαθίσταται πίσω από ένα firewall αλλά πριν τα εσωτερικά συστήματα, γεγονός που το καθιστά ικανό να ελέγχει τόσο την εισερχόμενη όσο και την εξερχόμενη κίνηση, όπως φαίνεται στο Σχήμα 35. Σε αντίθεση με ένα firewall, το οποίο φιλτράρει κυρίως με βάση προκαθορισμένους κανόνες, το IPS χρησιμοποιεί προηγμένες αναλυτικές λειτουργίες για τον εντοπισμό και τον αποκλεισμό δυναμικών απειλών σε πραγματικό χρόνο. Σε ορισμένες αρχιτεκτονικές δικτύου, το IPS λειτουργεί παράλληλα με το IDS, όπου το IDS εντοπίζει τις απειλές και ειδοποιεί τους διαχειριστές, ενώ το IPS λαμβάνει ενεργά μέτρα για την εξουδετέρωσή τους.
Οι βασικές ενέργειες που εκτελεί ένα IPS είναι οι ακόλουθες:
-
Αποστολή ειδοποιήσεων στους διαχειριστές.
-
Απόρριψη ενδεχομένως επιβλαβών δεσμών δεδομένων.
-
Αποκλεισμός συνδέσεων από κακόβουλες πηγές.
-
Επανεκκίνηση παραβιασμένων συνδέσεων για την αποτροπή περαιτέρω εκμετάλλευσης.
-
IPS βάσει Τεχνητής Νοημοσύνης για μεγαλύτερη ασφάλεια
Οι σύγχρονες λύσεις IPS αξιοποιούν αναλυτικά στοιχεία που βασίζονται στην Τεχνητή Νοημοσύνη (AI) και ροές δεδομένων σε πραγματικό χρόνο για τον αποτελεσματικότερο εντοπισμό και αποκλεισμό απειλών. Μαθαίνοντας συνεχώς από ιστορικά και αναδυόμενα μοτίβα επιθέσεων, τα εν λόγω συστήματα βελτιώνουν την ακρίβειά τους και μειώνουν τα ψευδώς θετικά αποτελέσματα. Ενσωματώνοντας αναλύσεις βάσει Τεχνητής Νοημοσύνης με ροές δεδομένων σε πραγματικό χρόνο, τα σύγχρονα IPS ενισχύουν την ασφάλεια απομονώνοντας τα προσβεβλημένα τερματικά, αποκλείοντας κακόβουλες διευθύνσεις IP και τροποποιώντας δυναμικά τους κανόνες του firewall για την αποτροπή της πλευρικής εξάπλωσης απειλών στα δίκτυα των πλοίων και των λιμένων (Maritime Intelligence, 2025). Αξιοσημείωτο παράδειγμα αποτελεί η εφαρμογή ενός IPS βασισμένου στο δίκτυο από την Cisco, το οποίο ανίχνευσε και μείωσε αποτελεσματικά τις εσωτερικές απειλές του δικτύου πριν προλάβουν να προκαλέσουν απώλεια δεδομένων ή διακοπές λειτουργίας. Αναλύοντας τόσο την εισερχόμενη όσο και την εξερχόμενη κίνηση εντός της εταιρείας, το IPS της Cisco παρείχε ένα κρίσιμο επίπεδο άμυνας, αποδεικνύοντας την αποτελεσματικότητα των IPS ενισχυμένων με Τεχνητή Νοημοσύνη στην προληπτική εξουδετέρωση των απειλών στον κυβερνοχώρο πριν αυτές κλιμακωθούν (Contentree, 2025).
Συστήματα Ανίχνευσης και Πρόληψης Εισβολών Ανοιχτού Κώδικα
Καθώς οι κυβερνοαπειλές συνεχίζουν να εξελίσσονται, τα IDS και IPS ανοικτού κώδικα έχουν καταστεί απαραίτητα εργαλεία για την παρακολούθηση και την ασφάλεια δικτύων. Δύο από τις πιο ευρέως χρησιμοποιούμενες λύσεις IDS/IPS ανοικτού κώδικα είναι τα Snort και Suricata, τα οποία παρέχουν ανίχνευση και πρόληψη απειλών σε πραγματικό χρόνο, προσφέροντας παράλληλα ευελιξία και δυνατότητες προσαρμογής.
Snort: Ένα σύστημα IDS/IPS βασισμένο σε κανόνες
Το Snort, που δημιουργήθηκε αρχικά από τον Martin Roesch το 1998, είναι ένα σύστημα IDS/IPS βασισμένο σε υπογραφές, με ικανότητα ανάλυσης της δικτυακής κίνησης σε πραγματικό χρόνο και καταγραφής δεσμών σε δίκτυα IP. Χρησιμοποιεί μια γλώσσα βασισμένη σε κανόνες, χάρη στην οποία ενσωματώνει τεχνικές ανίχνευσης βασισμένες σε υπογραφές, πρωτόκολλα και ανωμαλίες, ώστε να αναγνωρίζει ένα ευρύ φάσμα απειλών στον κυβερνοχώρο, όπως επιθέσεις άρνησης υπηρεσίας (DoS), υπερχείλιση προσωρινής μνήμης, κρυφές σαρώσεις θυρών και επιθέσεις CGI.
Το Snort λειτουργεί ανιχνεύοντας δέσμες δικτύου με τη χρήση βιβλιοθηκών όπως η libpcap και η WinPcap και έχει τρεις βασικές λειτουργίες:
-
Λειτουργία ανίχνευσης δεσμών δεδομένων – Καταγράφει και παρακολουθεί τη δικτυακή κίνηση ακατέργαστων δεδομένων.
-
Λειτουργία καταγραφής δεσμών δεδομένων – Καταγράφει τις δέσμες δεδομένων δικτύου για ανάλυση και εντοπισμό σφαλμάτων.
-
Λειτουργία ανίχνευσης εισβολών – Συγκρίνει τη δικτυακή δραστηριότητα με προκαθορισμένους κανόνες και αποστέλλει ειδοποιήσεις όταν εντοπίζονται απειλές.
Ένα βασικό πλεονέκτημα του Snort είναι η ευέλικτη γλώσσα κανόνων του, χάρη στην οποία οι χρήστες ορίζουν προσαρμοσμένες πολιτικές ασφαλείας. Ενσωματώνεται άριστα με τα firewall και προσφέρει ένα επιπλέον επίπεδο άμυνας, το οποίο το καθιστά ένα πολύτιμο εργαλείο για την παρακολούθηση του εσωτερικού δικτύου.
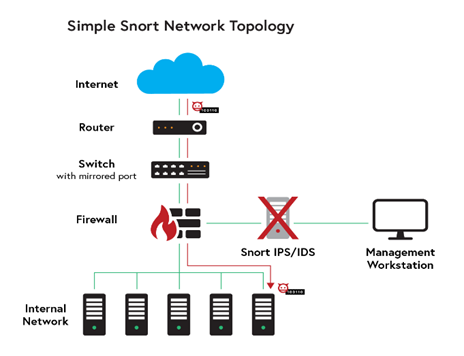
Σχήμα 36: Απλή Τοπολογία Δικτύου Snort.
Suricata: IDS/IPS υψηλής απόδοσης & Παρακολούθηση Ασφάλειας Δικτύου (NSM)
Το Suricata, που αναπτύχθηκε από το Ίδρυμα Ανοιχτής Ασφάλειας Πληροφοριών (OISF), είναι ένα IDS/IPS νέας γενιάς που επεκτείνει την παραδοσιακή παρακολούθηση της ασφάλειας δικτύου με εις Βάθος Έλεγχο Δέσμης Δεδομένων (DPI) και εγγενή πολυνηματική επεξεργασία. Σε αντίθεση με το Snort, το οποίο επικεντρώνεται κυρίως στην ανίχνευση βάσει υπογραφών, το Suricata αναλύει πολλαπλά επίπεδα πρωτοκόλλων (όπως HTTP, TLS, DNS και SMB) για την ανίχνευση πιο εξελιγμένων και δυσδιάκριτων απειλών.
Ένα από τα βασικά πλεονεκτήματά του είναι η ικανότητά του να επεξεργάζεται τη δικτυακή κίνηση με υψηλές ταχύτητες χάρη στην αρχιτεκτονική πολλαπλών νημάτων, γεγονός που το καθιστά ιδανικό για εφαρμογές σε εταιρικό επίπεδο και περιβάλλοντα ασφάλειας βάσει νέφους. Επιπλέον, ενσωματώνεται απρόσκοπτα με διάφορα εργαλεία διαχείρισης πληροφοριών και συμβάντων ασφάλειας, καθώς και με πλατφόρμες ανάλυσης δεδομένων, καθιστώντας δυνατή την απεικόνιση και ανάλυση πιθανών απειλών σε πραγματικό χρόνο.
Ένα άλλο μοναδικό χαρακτηριστικό του Suricata είναι η λειτουργία παρακολούθησης ασφάλειας δικτύου (NSM), η οποία του επιτρέπει να εξάγει μεταδεδομένα δικτυακής κίνησης, πέραν της ανίχνευσης εισβολών. Αυτή η δυνατότητα βοηθά τις ομάδες κυβερνοασφάλειας να διερευνούν τα περιστατικά ασφάλειας πιο αποτελεσματικά, παρέχοντας βαθύτερη εικόνα της συμπεριφοράς του δικτύου.
Εις Βάθος Έλεγχος Δέσμης Δεδομένων για προηγμένη ανίχνευση απειλών
Η τεχνολογία Εις Βάθος Ελέγχου Δέσμης Δεδομένων (DPI) δεν περιορίζεται στον έλεγχο των κεφαλίδων των δεσμών δεδομένων, αλλά αναλύει το ωφέλιμο φορτίο και τα μεταδεδομένα των μεταδιδόμενων δεδομένων, προσφέροντας λεπτομερή εικόνα των πρωτοκόλλων, του περιεχομένου στο επίπεδο εφαρμογών και της συμπεριφοράς που καθορίζεται από τον χρήστη. Σε αντίθεση με το παραδοσιακό φιλτράρισμα δεσμών δεδομένων, το οποίο ελέγχει μόνο τις κεφαλίδες IP και TCP/UDP, ο DPI εξετάζει ολόκληρη τη δέσμη δεδομένων, επιτρέποντάς της να εντοπίζει κακόβουλο ωφέλιμο φορτίο, παραβιάσεις πολιτικών ή κρυπτογραφημένες απειλές που συχνά παραβλέπουν τα απλούστερα συστήματα φιλτραρίσματος κεφαλίδων (Leslie, 2020).
Ένας μηχανισμός DPI λειτουργεί ελέγχοντας το περιεχόμενο των δεσμών δεδομένων σε πραγματικό χρόνο, χρησιμοποιώντας αντιστοίχιση βάσει υπογραφών, ευρετικές μεθόδους και ανίχνευση ανωμαλιών για το φιλτράρισμα της δικτυακής κίνησης. Μπορεί να ταξινομεί τις δέσμες με βάση το πρωτόκολλο, τον τύπο της εφαρμογής και το περιεχόμενο, τα οποία είναι απαραίτητα για τον εντοπισμό απειλών που κρύβονται μέσα σε φαινομενικά νόμιμη δικτυακή κίνηση. Για παράδειγμα, ο DPI μπορεί να διακρίνει την κανονική κίνηση HTTP από μια επίθεση που βασίζεται στο HTTP, όπως η έγχυση SQL ή η επικοινωνία malware διαχείρισης και ελέγχου. Με τον DPI είναι επίσης δυνατή η αποκρυπτογράφηση της κίνησης SSL/TLS για ανάλυση ασφάλειας, διασφαλίζοντας ότι οι κρυπτογραφημένες δέσμες δεδομένων δεν παρακάμπτουν τους ελέγχους ασφαλείας. Πολλές σύγχρονες κυβερνοεπιθέσεις αξιοποιούν κρυπτογραφημένο ωφέλιμο φορτίο για να αποκρύψουν κακόβουλη δραστηριότητα, αλλά ο DPI βάσει Τεχνητής Νοημοσύνης εντοπίζει ανωμαλίες συμπεριφοράς ακόμη και σε κρυπτογραφημένες συνεδρίες, όπως ασυνήθιστα μοτίβα μεταφοράς δεδομένων ή κίνηση προς γνωστούς κακόβουλους τομείς.
Όταν συνδυάζεται με αλγόριθμους τεχνητής νοημοσύνης ή μηχανικής μάθησης, η τεχνολογία DPI βελτιώνει την ανίχνευση απειλών, καθώς μαθαίνει από προηγούμενα μοτίβα δικτύου και εντοπίζει επιθέσεις «zero-day» ή προηγμένες επίμονες απειλές που παρακάμπτουν τα παραδοσιακά μέτρα ασφαλείας.
Αν εντοπιστεί κάποια ανωμαλία, τα συστήματα DPI λαμβάνουν αυτόματα μέτρα αντιμετώπισης, όπως η απομόνωση ενός παραβιασμένου τερματικού, ο τερματισμός ύποπτων συνδέσεων ή η δυναμική αναδιαμόρφωση των κανόνων του firewall, προκειμένου να αποτραπεί η εξάπλωση malware στα ναυτιλιακά δίκτυα IT και OT (Ipoque, 2025).
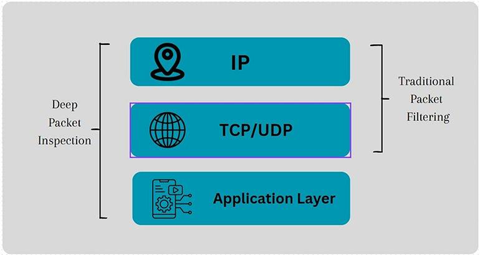
Σχήμα 37: Σύγκριση Παραδοσιακού Φιλτραρίσματος Δεσμών Δεδομένων και σε Βάθος Ελέγχου Δεσμών Δεδομένων
(Nethmal, 2025).
Παραγωγικά Ανταγωνιστικά Δίκτυα για την Ενίσχυση και την Προστασία Δεδομένων
Τα Παραγωγικά Ανταγωνιστικά Δίκτυα (GAN) αποτελούνται από δύο ανταγωνιστικά νευρωνικά δίκτυα: μία γεννήτρια που δημιουργεί συνθετικά δεδομένα και έναν διευκρινιστή που αξιολογεί την αυθεντικότητά τους, όπως φαίνεται στο Σχήμα 38. Αν και αρχικά αναπτύχθηκαν για τη σύνθεση εικόνων και τη δημιουργία deepfake, τα GAN έχουν αποδειχθεί εξαιρετικά αποτελεσματικά σε εφαρμογές κυβερνοασφάλειας, ιδίως στην ανίχνευση εισβολών, στην ανταγωνιστική εκπαίδευση και στην ανάλυση malware. Δημιουργώντας εξαιρετικά ρεαλιστικά δείγματα επιθέσεων, τα GAN ενισχύουν τα μοντέλα ασφάλειας βάσει μηχανικής μάθησης, στοιχείο που τα καθιστά ικανά να αναγνωρίζουν τόσο γνωστές όσο και προηγουμένως άγνωστες απειλές (Zhao, 2024).
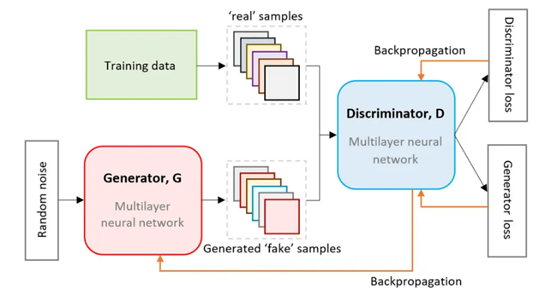
Σχήμα 38: Αρχιτεκτονική ενός δικτύου GAN
(TVS, 2025).
Μία από τις εφαρμογές των Παραγωγικών Ανταγωνιστικών Δικτύων (GAN) στον τομέα της κυβερνοασφάλειας είναι η ικανότητά τους να παράγουν συνθετικά πρότυπα malware ή απόπειρες εκμετάλλευσης, εμπλουτίζοντας αποτελεσματικά τα σύνολα δεδομένων εκπαίδευσης για τα συστήματα IDS και IPS. Οι παραδοσιακές λύσεις IDS/IPS στηρίζονται στην ανίχνευση βάσει υπογραφών, η οποία δυσκολεύεται να αντιμετωπίσει τις απειλές «zero-day» και το πολυμορφικό malware που εξελίσσεται συνεχώς. Με την εκπαίδευση μοντέλων IDS/IPS σε δείγματα ανταγωνιστικών δεδομένων που δημιουργούνται από GAN, τα συστήματα κυβερνοασφάλειας μπορούν να βελτιώσουν την ανθεκτικότητά τους έναντι προηγουμένως άγνωστων στρατηγικών επίθεσης. Τα GAN έχουν εφαρμοστεί επίσης σε αυτοματοποιημένες δοκιμές διείσδυσης, όπου δημιουργούν παραλλαγές email phishing, ωφέλιμα φορτία επιθέσεων brute-force ή σενάρια εκμετάλλευσης για να ελέγξουν την κατάσταση ασφάλειας ενός οργανισμού. Προσομοιώνοντας πραγματικές απειλές στον κυβερνοχώρο, οι δοκιμές διείσδυσης με χρήση GAN επιτρέπουν τη συνεχή αξιολόγηση της ασφάλειας χωρίς να εκθέτουν τα συστήματα σε πραγματικές επιθέσεις.
Πέρα από την ανίχνευση εισβολών, τα GAN χρησιμοποιούνται ευρέως στην ανίχνευση ανωμαλιών. Ένας ανιχνευτής ανωμαλιών βάσει GAN μαθαίνει πρώτα τη στατιστική κατανομή της κανονικής συμπεριφοράς του δικτύου και στη συνέχεια ανιχνεύει λεπτές αποκλίσεις που ενδέχεται να υποδηλώνουν κρυφές απειλές στον κυβερνοχώρο, malware που έχει υποστεί θόλωση ή απόπειρες διαρροής δεδομένων. Σε αντίθεση με την παραδοσιακή ανίχνευση ανωμαλιών βάσει κανόνων, τα GAN προσαρμόζονται συνεχώς στις νέες συνθήκες του δικτύου, μειώνοντας τα ψευδώς θετικά αποτελέσματα και βελτιώνοντας παράλληλα την ακρίβεια της ανίχνευσης. Αυτή η ικανότητα αναγνώρισης ανώμαλης συμπεριφοράς είναι ιδιαίτερα χρήσιμη στην ανίχνευση προηγμένων επίμονων απειλών που αναμειγνύονται με τη νόμιμη δικτυακή κίνηση.
Μια άλλη καινοτόμος εφαρμογή των GAN είναι η ανταγωνιστική εκπαίδευση, όπου τα μοντέλα κυβερνοασφάλειας ενισχύονται έναντι τεχνικών παράκαμψης επιθέσεων. Οι επιτιθέμενοι χρησιμοποιούν συχνά τεχνικές ανταγωνιστικής μηχανικής μάθησης για τη χειραγώγηση μοντέλων IDS/IPS, δημιουργώντας επιθετικά φορτία που παρακάμπτουν τους παραδοσιακούς μηχανισμούς ανίχνευσης. Εκπαιδεύοντας τα GAN να προσομοιώνουν επιθέσεις κακόβουλης δράσης, οι άμυνες στον τομέα της κυβερνοασφάλειας μπορούν να υποβληθούν σε δοκιμές αντοχής και να ενισχυθούν, εξασφαλίζοντας την ανθεκτικότητα έναντι τέτοιων επιθέσεων.
Ανίχνευση Ανωμαλιών
Ενώ τα συστήματα IDS συχνά εστιάζουν σε συγκεκριμένους τύπους εισβολών, η ανίχνευση ανωμαλιών αποτελεί μια ευρύτερη τεχνική που εντοπίζει οποιαδήποτε άτυπη ή ασυνήθιστη συμπεριφορά, η οποία ενδεχομένως υποδηλώνει σφάλμα του συστήματος ή απειλή στον κυβερνοχώρο. Παρακολουθώντας δείκτες όπως η χρήση των πόρων του συστήματος, η καθυστέρηση του δικτύου και οι προσπάθειες σύνδεσης, οι αλγόριθμοι ανίχνευσης ανωμαλιών δημιουργούν μια βάση αναφοράς για το πώς μοιάζει η «κανονική» δραστηριότητα. Οποιαδήποτε σημαντική απόκλιση από αυτό το πρότυπο ενδέχεται να αποτελεί ζήτημα ασφάλειας ή λειτουργικό πρόβλημα. Σε πολλές ναυτιλιακές εφαρμογές, τα συστήματα Τεχνητής Νοημοσύνης ενεργοποιούν αυτοματοποιημένα αντίμετρα, όπως η απομόνωση παραβιασμένων δικτύων ή η προσαρμογή των κανόνων του firewall για την ταχεία αντιμετώπιση πιθανών απειλών (Ribeiro et al., 2023). Αυτή η άμεση, αυτόνομη αντίδραση είναι καθοριστική για τις θαλάσσιες επιχειρήσεις, όπου τα μικρά περιστατικά μπορούν να εξελιχθούν γρήγορα σε προβλήματα μεγάλης κλίμακας που αφορούν τη λογιστική ή την ασφάλεια, αν δεν αντιμετωπιστούν αμέσως.
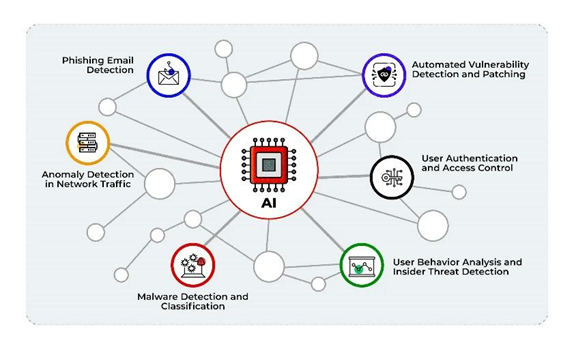
Σχήμα 39: Εφαρμογές ανίχνευσης ανωμαλιών στην κυβερνοασφάλεια .
Προγνωστική Ανάλυση για Κυβερνοαπειλές
Η προγνωστική ανάλυση χρησιμοποιεί ιστορικά δεδομένα και πρότυπα συμπεριφοράς για να προβλέψει πιθανά αδύνατα σημεία και μελλοντικές στρατηγικές επίθεσης, προσφέροντας έτσι προληπτική άμυνα στον κυβερνοχώρο. Εξετάζοντας μεγάλο όγκο παλαιότερων περιστατικών, τα μοντέλα τεχνητής νοημοσύνης εντοπίζουν τους παράγοντες που συχνά προηγούνται των επιθέσεων (Merrick, 2022). Στην πράξη, αυτοί οι αλγόριθμοι προσομοιώνουν διάφορα σενάρια επίθεσης για τον εντοπισμό αδύναμων σημείων, παρέχοντας στις ομάδες ασφάλειας μια σαφή εικόνα για το πού πρέπει να διαθέσουν πρώτα τους πόρους τους. Αποδίδοντας βαθμολογίες κινδύνου σε διαφορετικές απειλές, οι ναυτιλιακοί φορείς μπορούν να ιεραρχήσουν και να ενισχύσουν την άμυνά τους προκειμένου να διατηρήσουν ασφαλή τα κρίσιμα συστήματα. Αυτή η προσέγγιση δεν μετριάζει μόνο τον άμεσο κίνδυνο, αλλά ενισχύει και τη μακροπρόθεσμη ανθεκτικότητα έναντι των εξελισσόμενων απειλών στον κυβερνοχώρο (Meijer and Wessels, 2019). Η προγνωστική ανάλυση ενσωματώνεται συχνά σε συστήματα διαχείρισης πληροφοριών και συμβάντων ασφαλείας (SIEM) για τη συσχέτιση δεδομένων σε πραγματικό χρόνο από πολλαπλές πηγές, βελτιώνοντας την ακρίβεια στην πρόβλεψη απειλών. Όταν συνδυάζονται με συστήματα ανίχνευσης και πρόληψης εισβολών, τα μοντέλα αυτά ενεργοποιούν αυτοματοποιημένα αμυντικά μέτρα για τον αποκλεισμό απειλών πριν αυτές εκδηλωθούν.
Πιθανά Τρωτά Σημεία και Αντιπαραθετικές Επιθέσεις
Αν και η Τεχνητή Νοημοσύνη ενισχύει σημαντικά την κυβερνοασφάλεια στη ναυτιλία, εισάγει επίσης πιθανά τρωτά σημεία τα οποία οι επιτιθέμενοι ενδέχεται να προσπαθήσουν να εκμεταλλευτούν. Οι αντιπαραθετικές επιθέσεις περιλαμβάνουν την εισαγωγή προσεκτικά διαμορφωμένων δεδομένων σε μοντέλα Τεχνητής Νοημοσύνης, παραπλανώντας τα ώστε να λαμβάνουν λανθασμένες αποφάσεις ή να αγνοούν πραγματικές απειλές (Qiu et al., 2019). Για παράδειγμα, οι κακόβουλοι δράστες ενδέχεται να καμουφλάρουν malware, ώστε ένα σύστημα ανίχνευσης που βασίζεται στην Τεχνητή Νοημοσύνη να το κατατάξει εσφαλμένα ως ακίνδυνο. Ένας άλλος κίνδυνος είναι η δηλητηρίαση του μοντέλου, όπου οι επιτιθέμενοι εισάγουν ψευδείς ή παραπλανητικές πληροφορίες στα δεδομένα εκπαίδευσης, υποβαθμίζοντας σταδιακά την ακρίβεια του μοντέλου.
Για την προστασία από αυτές τις τακτικές, οι ναυτιλιακοί οργανισμοί υιοθετούν συχνά μια σειρά προστατευτικών μέτρων. Ένα από αυτά είναι η τακτική επανεκπαίδευση με επαλήθευση της ακεραιότητας των δεδομένων, ώστε να διασφαλίζεται ότι το μοντέλο παραμένει ακριβές και ενημερωμένο. Η αντιπαραθετική εκπαίδευση, κατά την οποία το μοντέλο εκτίθεται σκόπιμα σε παραπλανητική είσοδο δεδομένων κατά την ανάπτυξή του, το βοηθά επίσης να μάθει να αναγνωρίζει και να αντιστέκεται σε επιθέσεις χειραγώγησης. Τέλος, οι αξιόπιστες ροές δεδομένων και οι έλεγχοι πρόσβασης είναι απαραίτητοι για τη διασφάλιση τόσο της διαδικασίας εκπαίδευσης όσο και της επιχειρησιακής χρήσης της τεχνητής νοημοσύνης, διατηρώντας τα πολλά πλεονεκτήματα που προσφέρει στην ασφάλεια και την απόδοση του ναυτιλιακού τομέα.
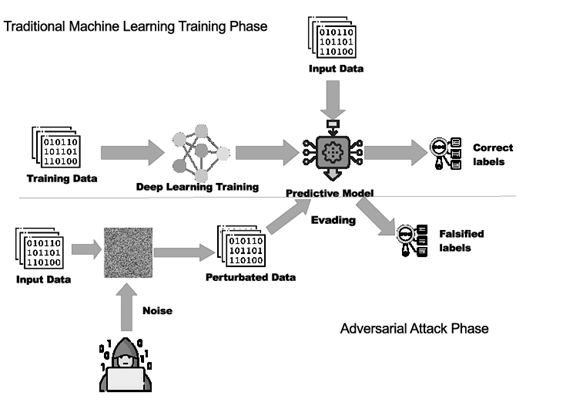
Σχήμα 40: Παράδειγμα αντιπαραθετικής επίθεσης
(Catak & Sule, (2020).
Προκλήσεις και περιορισμοί της Τεχνητής Νοημοσύνης
Τα συστήματα βάσει Τεχνητής Νοημοσύνης προσφέρουν βελτιωμένες δυνατότητες για τον εντοπισμό και τον περιορισμό των απειλών στον κυβερνοχώρο, ωστόσο δημιουργούν μια σειρά προκλήσεων και περιορισμών που οι οργανισμοί πρέπει να αντιμετωπίσουν προκειμένου να καταστούν πιο αποτελεσματικοί.
Ποιότητα και Διαθεσιμότητα Δεδομένων
Ένα σημαντικό ζήτημα αφορά την ποιότητα και τη διαθεσιμότητα των δεδομένων. Δεδομένου ότι τα συστήματα αυτά βασίζονται σε μεγάλο βαθμό σε τεράστιο όγκο δεδομένων υψηλής ποιότητας για την εκπαίδευση και τη βελτίωση των αλγορίθμων ανίχνευσης, τυχόν ανακρίβειες ή κενά στα εν λόγω δεδομένα μπορούν να οδηγήσουν σε λανθασμένες προβλέψεις ή στην παράλειψη απειλών. Οι οργανισμοί συχνά αντιμετωπίζουν δυσκολίες κατά την ενσωμάτωση δεδομένων από πολλαπλά τμήματα δικτύου και διαφορετικές πηγές (Palo Alto Networks, 2025). Αυτό μπορεί να έχει ως αποτέλεσμα την ελλιπή εικόνα των δραστηριοτήτων των χρηστών και της συμπεριφοράς του συστήματος, δημιουργώντας κενά στην ανίχνευση απειλών.
Ψευδώς Θετικά Αποτελέσματα και Κόπωση από Ειδοποιήσεις
Μια άλλη πρόκληση προκύπτει από τον μεγάλο αριθμό ψευδώς θετικών αποτελεσμάτων. Αν και η Τεχνητή Νοημοσύνη σκοπεύει να μειώσει αυτές τις εσφαλμένες ειδοποιήσεις, εξακολουθεί να μπορεί να παράγει πληθώρα προειδοποιήσεων που κατακλύζουν τις ομάδες ασφαλείας. Αυτή η κατάσταση μπορεί να προκαλέσει κόπωση από ειδοποιήσεις, όπου το προσωπικό ασφαλείας αρχίζει να παραβλέπει ειδοποιήσεις που ενδεχομένως είναι σημαντικές, λόγω της συνεχούς ροής ειδοποιήσεων χαμηλού κινδύνου (Olateju et al., 2024). Η διαχείριση και η διερεύνηση αυτών των πολυάριθμων ειδοποιήσεων απαιτεί σημαντικό χρόνο και πόρους, αποσπώντας ενδεχομένως την προσοχή από τις πραγματικές απειλές.
Πολυπλοκότητα και Έλλειψη Δυνατότητα Ερμηνείας
Η πολυπλοκότητα και η δυνατότητα ερμηνείας αποτελούν επιπλέον εμπόδια. Οι σύγχρονες τεχνικές Τεχνητής Νοημοσύνης, και ιδίως η βαθιά μάθηση, παράγουν αποτελέσματα με αδιαφανείς διαδικασίες λήψης αποφάσεων. Οι αναλυτές ασφάλειας ενδέχεται να δυσκολεύονται να εμπιστευτούν τις ειδοποιήσεις ή να ενεργήσουν βάσει αυτών, όταν δεν κατανοούν πώς ή γιατί το μοντέλο Τεχνητής Νοημοσύνης κατέληξε σε ένα συγκεκριμένο συμπέρασμα (Digital Leaders, 2025). Ως εκ τούτου, η εγγύηση ότι το σύστημα παρέχει σαφείς εξηγήσεις και αιτιολογήσεις είναι ζωτικής σημασίας για τη δημιουργία εμπιστοσύνης στα εργαλεία ασφάλειας βάσει Τεχνητής Νοημοσύνης.
Ενσωμάτωση στα Υφιστάμενα Συστήματα
Σε πολλούς οργανισμούς, η ενσωμάτωση στα υφιστάμενα συστήματα είναι κάθε άλλο παρά ομαλή. Τα συστήματα βάσει Τεχνητής Νοημοσύνης πρέπει να λειτουργούν απρόσκοπτα με την υπάρχουσα υποδομή ασφάλειας ενός οργανισμού, κάτι που μπορεί να συνεπάγεται προβλήματα συμβατότητας και να απαιτεί σημαντική τεχνική εμπειρογνωμοσύνη. Τα παλαιά συστήματα συχνά χρειάζονται αναβάθμιση ώστε να ανταποκρίνονται στις απαιτήσεις επεξεργασίας δεδομένων και στις προηγμένες αναλύσεις της Τεχνητής Νοημοσύνης. Αυτές οι απαιτήσεις όχι μόνο εντείνουν την πολυπλοκότητα της ανάπτυξης, αλλά δημιουργούν επίσης ένα πρόσθετο κόστος και παρατείνουν τα χρονοδιαγράμματα υλοποίησης.
Τρωτά Σημεία σε Αντιπαραθετικές Επιθέσεις
Τα ίδια τα μοντέλα Τεχνητής Νοημοσύνης μπορεί να είναι ευάλωτα σε αντιπαραθετικές επιθέσεις, όπου κακόβουλοι δράστες χειραγωγούν σκόπιμα τις εισόδους για να παραπλανήσουν το σύστημα. Αυτό περιλαμβάνει την εισαγωγή παραπλανητικών προτύπων ή σημάτων που επηρεάζουν την Τεχνητή Νοημοσύνη ώστε να ταξινομήσει εσφαλμένα τις απειλές ή να παραχωρήσει μη εξουσιοδοτημένη πρόσβαση. Η αντιμετώπιση αυτών των επιθέσεων απαιτεί τη συνεχή παρακολούθηση και ενημερώσεις, ώστε να διασφαλίζεται ότι τα μοντέλα παραμένουν ανθεκτικά έναντι των εξελισσόμενων αντιπαραθετικών τεχνικών (MetaCompliance, 2025).
Μεροληψία στα μοντέλα Τεχνητής Νοημοσύνης
Η μεροληψία στα μοντέλα Τεχνητής Νοημοσύνης αποτελεί ένα επιπλέον πρόβλημα. Αν τα δεδομένα εκπαίδευσης είναι μεροληπτικά ή αντανακλούν συγκεκριμένες προκαταλήψεις, το IDS ενδέχεται να επισημάνει άδικα συγκεκριμένες ομάδες, τύπους δραστηριοτήτων ή συμπεριφορές χρηστών. Αυτό πιθανόν να οδηγήσει όχι μόνο σε δεοντολογικά ζητήματα, αλλά και σε μη βέλτιστα αποτελέσματα ασφάλειας, καθώς η μεροληπτική στάση μπορεί να καταστήσει το σύστημα ανίκανο να εντοπίσει ευρύτερες απειλές (ISC², 2024). Η αναγνώριση και η άμβλυνση της μεροληψίας είναι επομένως ζωτικής σημασίας για τη διασφάλιση της δικαιοσύνης και τη διατήρηση της ακεραιότητας της διαδικασίας ανίχνευσης.
Προκλήσεις σε θέματα Ρυθμιστικών Απαιτήσεων και Συμμόρφωσης
Οι απαιτήσεις ρυθμιστικής συμμόρφωσης καθιστούν πιο σύνθετο το τοπίο. Πολλοί τομείς, όπως ο ναυτιλιακός, πρέπει να τηρούν αυστηρούς νόμους περί προστασίας δεδομένων και κυβερνοασφάλειας, προκειμένου να διασφαλίζουν την ασφαλή διαχείριση των δεδομένων χρηστών, πελατών και λειτουργικών δεδομένων. Οι λύσεις βάσει Τεχνητής Νοημοσύνης πρέπει να δημιουργούν σαφή ίχνη ελέγχου ώστε να αποδεικνύεται η συμμόρφωση κατά τη διάρκεια ελέγχων, επιβαρύνοντας έτσι τη διαδικασία υλοποίησης με διοικητικό και τεχνικό φόρτο (Ethico, 2024). Η συμμόρφωση με πλαίσια όπως το Πλαίσιο Κυβερνοασφάλειας NIST, το ISO 27001 και τις κατευθυντήριες γραμμές της ENISA, μεταξύ άλλων, είναι κρίσιμη για τη διασφάλιση της ασφαλούς και νόμιμης ανάπτυξης συστημάτων κυβερνοασφάλειας ενισχυμένων με τεχνητή νοημοσύνη.
Υψηλό Κόστος Υλοποίησης και Συντήρησης
Το κόστος αποτελεί επίσης σημαντικό παράγοντα. Οι αρχικές δαπάνες για εξειδικευμένο υλικό, άδειες λογισμικού και επαγγελματικές υπηρεσίες μπορεί να είναι υψηλές, ενώ η συνεχής συντήρηση, οι ενημερώσεις και η επανεκπαίδευση των μοντέλων συνεπάγονται διαρκείς δαπάνες. Ως αποτέλεσμα, οι μικρότεροι οργανισμοί ίσως δυσκολεύονται να δικαιολογήσουν ή να αντέξουν οικονομικά τη μακροπρόθεσμη επένδυση που απαιτείται για την ανάπτυξη και τη συντήρηση δυνατοτήτων βάσει Τεχνητής Νοημοσύνης σε μεγάλη κλίμακα (Modern Diplomacy, 2024).
Έλλειψη Εξειδικευμένων Επαγγελματιών
Επιπλέον, συχνά παρατηρείται ένα αισθητό κενό ως προς την εξειδίκευση βάσει Τεχνητής Νοημοσύνης (AI) που απαιτείται για τη διαχείριση συστημάτων ασφαλείας. Οι οργανισμοί ενδέχεται να αντιμετωπίζουν δυσκολίες στην πρόσληψη ή την εκπαίδευση επαρκούς αριθμού επαγγελματιών που διαθέτουν τόσο γνώσεις Τεχνητής Νοημοσύνης όσο και εμπειρία στον τομέα της ασφάλειας. Η συνεχής ενημέρωση του προσωπικού σχετικά με τις ταχέως εξελισσόμενες τεχνικές AI και τις απειλές στον τομέα της κυβερνοασφάλειας απαιτεί δέσμευση σε προγράμματα δια βίου εκπαίδευσης και κατάρτισης (Technology Magazine, 2024).
Ζητήματα Προστασίας της Ιδιωτικής Ζωής
Τέλος, τα ζητήματα προστασίας της ιδιωτικής ζωής έρχονται στο προσκήνιο κατά τη χρήση συστημάτων ανίχνευσης εισβολών (IDS) βασισμένων σε Τεχνητή Νοημοσύνη για την παρακολούθηση της συμπεριφοράς των χρηστών. Η συλλογή και ανάλυση τόσο λεπτομερών πληροφοριών μπορεί να έρχεται σε σύγκρουση με τη νομοθεσία περί προστασίας δεδομένων, εάν δεν γίνεται σωστά. Οι οργανισμοί πρέπει να διασφαλίζουν ότι τα δεδομένα των χρηστών συλλέγονται, αποθηκεύονται και υποβάλλονται σε επεξεργασία με τρόπο που σέβεται τα δικαιώματα της ιδιωτικής ζωής των ατόμων και συμμορφώνεται με κανονισμούς όπως ο Γενικός Κανονισμός για την Προστασία Δεδομένων (Stewart, 2024). Για να επιτευχθεί αυτή η ισορροπία, απαιτείται η συγκατάθεση των χρηστών, η σαφής διατύπωση των πολιτικών παρακολούθησης και η τήρηση αυστηρών πρακτικών διαχείρισης δεδομένων.
Αντιμετωπίζοντας αυτές τις προκλήσεις - από την ποιότητα των δεδομένων και τα ψευδώς θετικά αποτελέσματα έως τη δυνατότητα ερμηνείας, το κόστος, τη μεροληψία, τα κενά δεξιοτήτων και τα ζητήματα προστασίας της ιδιωτικής ζωής - οι οργανισμοί μπορούν να αξιοποιήσουν το πλήρες δυναμικό των λύσεων βάσει Τεχνητής Νοημοσύνης, διατηρώντας παράλληλα ισχυρή ασφάλεια και συμμόρφωση με τους κανονισμούς.
Συνοψίζοντας, η Τεχνητή Νοημοσύνη (AI) μετασχηματίζει την κυβερνοασφάλεια στη ναυτιλία, βελτιώνοντας την ανίχνευση απειλών, προλαμβάνοντας τις κυβερνοεπιθέσεις και βελτιστοποιώντας τις λειτουργίες των πλοίων. Μέσω της μηχανικής μάθησης και της βαθιάς μάθησης, τα συστήματα βάσει Τεχνητής Νοημοσύνης, όπως τα IDS, IPS και DPI, συμβάλλουν στην παρακολούθηση, την ανάλυση και την αντιμετώπιση των κινδύνων ασφαλείας σε πραγματικό χρόνο. Η προγνωστική ανάλυση ενισχύει περαιτέρω την κυβερνοάμυνα, εντοπίζοντας τα τρωτά σημεία πριν προκύψουν οι επιθέσεις. Ωστόσο, η υιοθέτηση της Τεχνητής Νοημοσύνης συνοδεύεται από προκλήσεις, όπως οι αντιπαραθετικές επιθέσεις, η μεροληψία και οι πολυπλοκότητες της ενσωμάτωσης. Για να διασφαλιστεί η ανθεκτικότητα, είναι απαραίτητες οι συνεχείς βελτιώσεις στις στρατηγικές ασφάλειας της Τεχνητής Νοημοσύνης, όπως η αντιπαραθετική εκπαίδευση, η βελτιωμένη συμμόρφωση με τους κανονισμούς και τα ευέλικτα μοντέλα μάθησης. Καθώς οι κυβερνοαπειλές εξελίσσονται, η Τεχνητή Νοημοσύνη θα διαδραματίζει όλο και πιο σημαντικό ρόλο στην προστασία των ναυτιλιακών δραστηριοτήτων, ενισχύοντας παράλληλα τη λειτουργική απόδοση και την ασφάλεια.