Kapitel 8 – Theorie
5. KI für Cybersicherheit im Seeverkehr und prädiktive Analyse
Cybersicherheit ist zu einem entscheidenden Faktor für den Schutz wichtiger Funktionen wie Navigation, Frachtmanagement und Kommunikationsnetzwerke geworden. Künstliche Intelligenz (KI) hat sich als leistungsstarkes Instrument zur Bewältigung dieser Sicherheitsherausforderungen herausgestellt. Durch die Analyse großer Datenmengen können KI-Systeme Bedrohungen genauer erkennen, Reaktionen beschleunigen und Betriebsstörungen mindern (Kaur et al., 2023). Dieses Dokument bietet einen Überblick über KI, maschinelles Lernen (ML) und Deep Learning (DL), skizziert die Entwicklung von Lebenszyklen maschineller Lernmodelle und erörtert, wie diese Technologien die Cybersicherheit und Betriebseffizienz im Seeverkehr stärken können.
Über die Erkennung von Angriffen hinaus verbessert KI auch die Leistung und Energieeffizienz von Schiffen, indem sie die Sensordaten des Schiffes analysiert, um mögliche mechanische Ausfälle vorherzusagen, bevor sie auftreten (Tu et al., 2018). Diese Technik hilft dabei, Reparaturen zu den kostengünstigsten Zeitpunkten zu planen und unerwartete Ausfälle zu vermeiden. Darüber hinaus kann KI die Geschwindigkeit und Route eines Schiffes auf der Grundlage v en über Wetterbedingungen, Ladung oder Kraftstoffverbrauch dynamisch anpassen, was letztlich zu einer Senkung der Betriebskosten und einer Verringerung der Umweltbelastung führt.
Eine weitere wichtige Anwendung ist die KI-gestützte visuelle Überwachung, die die Sicherheit im Seeverkehr stärkt, indem sie die Aktivitäten an Bord auf unbefugten Zugang oder ungewöhnliches Verhalten überwacht (Şengönül et al., 2023). Deep-Learning-Modelle, wie z. B. Faltungsneuronale Netze, können Anomalien beim Umschlag von Fracht erkennen oder feststellen, wenn Personal Sperrbereiche betritt. Beispielsweise können Robotersysteme Güter sicher und effizient aus Containern entnehmen, die in zufälliger Reihenfolge ankommen, wodurch manuelle Arbeitsrisiken reduziert und die Betriebsgenauigkeit verbessert werden (Mojtahedzadeh et al., 2015).
Grundlagen von KI, ML und DL
Künstliche Intelligenz ist ein breites Gebiet der Informatik, das sich auf die Schaffung von Systemen konzentriert, die Aufgaben ausführen können, die normalerweise menschliche Intelligenz erfordern, wie z. B. das Verstehen von Sprache, das Erkennen von Mustern oder das Treffen von Entscheidungen. Frühe KI-Forschungen stützten sich stark auf sogenannte „regelbasierte” Systeme, bei denen Experten detaillierte IF-THEN-Anweisungen niederschrieben, wie in Abbildung23 dargestellt. Eine Cybersicherheitsregel könnte beispielsweise lauten: „WENN ein Computer mehrere fehlgeschlagene Anmeldeversuche registriert, DANN den Benutzer vorübergehend sperren.” Solche Systeme funktionieren gut in Situationen, in denen Regeln klar definiert werden können, aber sie können Schwierigkeiten haben, wenn sie mit neuen oder unerwarteten Problemen konfrontiert werden.
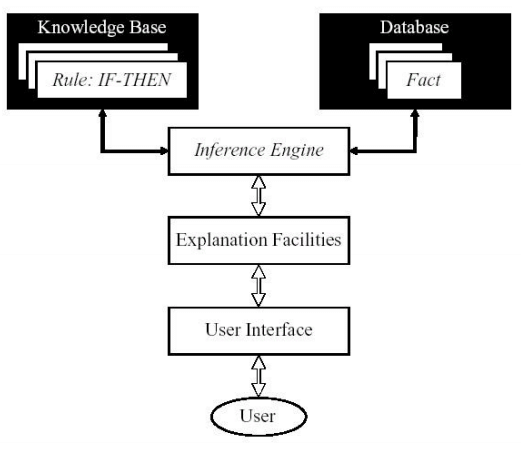
Abbildung 23 : Struktur regelbasierter KI-Systeme
(Mojtahedzadeh et al., 2015)
Moderne KI geht über die ausschließliche Verwendung manuell geschriebener Regeln hinaus. Stattdessen nutzt sie Techniken wie maschinelles Lernen, die es Computern ermöglichen, aus Daten zu lernen, ohne für jedes mögliche Szenario explizit programmiert zu werden. Anstatt Anweisungen für jede Situation festzulegen, versorgen wir das System mit riesigen Mengen an Informationen, sodass es Muster analysieren und eigene Entscheidungen treffen kann. Dieser Prozess spiegelt wider, wie Menschen durch Erfahrung lernen, indem sie zahlreiche Beispiele beobachten, Zusammenhänge erkennen und ihr Verständnis schrittweise verbessern. Im maritimen Bereich kann ML beispielsweise Daten aus GPS-Ortungssystemen analysieren, um ungewöhnliche Schiffsbewegungen zu erkennen, die auf unbefugten Zugang oder Pirateriegefahr hindeuten könnten. Durch kontinuierliches Lernen aus Echtzeit-Standortdaten und vergangenen Vorfällen kann KI Abweichungen von normalen Routen oder Verhaltensweisen erkennen und Warnmeldungen auslösen, bevor potenzielle Sicherheitsrisiken eskalieren. Im Laufe der Zeit verfeinern ML-Modelle ihre Vorhersagen und passen sich an neue Fälle an, sodass sie komplexe und sich entwickelnde Probleme effektiver bewältigen können, ohne dass für jede Entscheidung ein direktes Eingreifen des Menschen erforderlich ist.
Innerhalb des ML gibt es verschiedene Arten des Lernens. Bei einem Ansatz, der oft als überwachtes Lernen bezeichnet wird, werden dem System Beispiele gezeigt, die bereits Antworten oder Beschriftungen enthalten. Mit der Zeit findet es heraus, wie diese Antworten mit den einzelnen Beispielen zusammenhängen, sodass es Ergebnisse für neue, unbekannte Daten vorhersagen kann. Je nach Art des Problems kann überwachtes Lernen für die Klassifizierung verwendet werden, wobei das Ziel darin besteht, Datenpunkte bestimmten Kategorien zuzuordnen, z. B. um festzustellen, ob die Kommunikation eines Schiffes legitim ist oder eine potenzielle Cyberbedrohung darstellt. Es kann auch für Regressionen verwendet werden, bei denen das Modell kontinuierliche Werte vorhersagt, z. B. die Schätzung des Kraftstoffverbrauchs auf der Grundlage von Geschwindigkeit, Ladungsgewicht und Wetterbedingungen.
Bei einem anderen Ansatz, dem sogenannten unüberwachten Lernen, arbeitet das System mit Informationen, die keine Beschriftungen haben, sodass es selbst versteckte Muster entdecken muss, beispielsweise indem es ähnliche Elemente gruppiert. Dies ist in der maritimen Cybersicherheit nützlich, wenn der Netzwerkverkehr analysiert wird, um Anomalien zu erkennen, die auf Cyberangriffe hindeuten könnten, da das System normales und abnormales Verhalten ohne Vorkenntnisse darüber, wie ein Angriff aussieht, gruppieren kann.
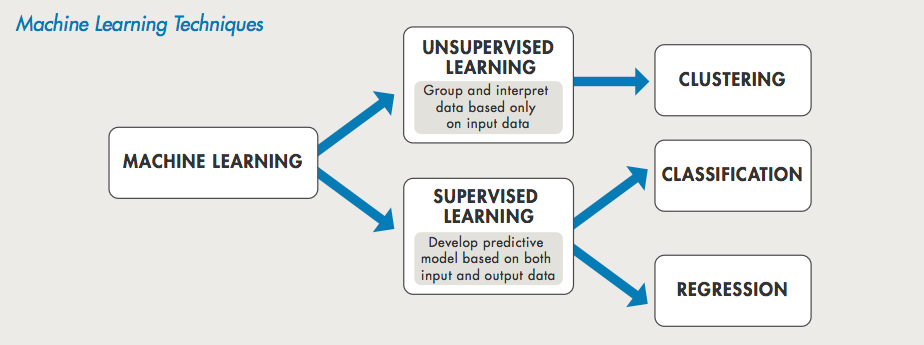
Abbildung 24: Techniken des maschinellen Lernens
Ein dritter Ansatz, das sogenannte Reinforcement Learning (RL), beinhaltet das Lernen durch Versuch und Irrtum. Im Gegensatz zum überwachten Lernen, bei dem dem System beschriftete Beispiele für richtige Antworten gegeben werden, arbeitet das Reinforcement Learning in einer Umgebung, in der es durch Interaktion das optimale Verhalten entdecken muss. Das System, das oft als „Agent” bezeichnet wird, probiert verschiedene Optionen innerhalb dieser Umgebung aus und erhält Feedback in Form von Belohnungen oder Strafen. Eine Belohnung signalisiert, dass eine Aktion wünschenswert war, während eine Strafe auf eine unerwünschte Aktion hinweist. Das Ziel des Agenten ist es, eine „Strategie” zu erlernen, d. h. eine Zuordnung von Zuständen (der aktuellen Situation, in der sich der Agent befindet) zu Aktionen, die seine kumulative Belohnung im Laufe der Zeit maximiert. In der Robotersteuerung kann RL beispielsweise verwendet werden, um einem Roboter das Laufen beizubringen. Der Roboter beginnt mit zufälligen Schritten und erhält Feedback basierend auf Stabilität, Energieeffizienz und Vorwärtsbewegung. Über mehrere Iterationen lernt er, seine Gelenkbewegungen anzupassen, um effizienter zu laufen, sein Gleichgewicht zu verbessern und den Energieverbrauch zu minimieren (Song et al., 2021).
Deep Learning geht noch einen Schritt weiter und versucht, die Art und Weise nachzuahmen, wie das menschliche Gehirn Informationen verarbeitet. Im Kern verwendet es künstliche neuronale Netze, die ähnlich wie biologische Neuronen strukturiert sind, um automatisch Muster in riesigen Datenmengen zu lernen und zu erkennen. Im Gegensatz zum traditionellen maschinellen Lernen, bei dem Menschen oft manuell die relevantesten Merkmale für ein Modell auswählen und definieren müssen, extrahieren Deep-Learning-Modelle diese Merkmale selbstständig und interpretieren Rohdaten ohne explizite Programmierung. Das System bestimmt, welche Aspekte der Daten am wichtigsten sind, sodass es Muster erkennen und Entscheidungen mit minimalem menschlichem Eingriff treffen kann.
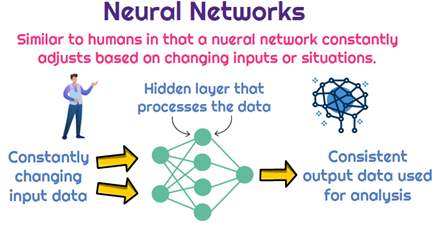
Abbildung 25: Adaptive Lernsysteme, die sich ändernde Eingabedaten verarbeiten,
um konsistente Ergebnisse für die Analyse zu generieren .
Genauso wie das menschliche Gehirn über spezialisierte Regionen für verschiedene Aufgaben verfügt, sind Deep-Learning-Modelle mit Architekturen ausgestattet, die sich auf bestimmte Datentypen konzentrieren. Bei der Verarbeitung visueller Informationen erkennt beispielsweise der visuelle Kortex des Gehirns Objekte, indem er Kanten, Formen und Texturen erkennt, bevor er ein vollständiges Bild erzeugt. Davon inspiriert wurden Convolutional Neural Networks (CNNs) (Jorgecardete, 2025) entwickelt, um visuell relevante Aufgaben zu bewältigen und relevante Merkmale aus Bildern automatisch zu lernen, ohne dass eine manuelle Eingabe erforderlich ist. CNNs können beispielsweise zur Erkennung von Gesichtsausdrücken eingesetzt werden, indem sie Gesichtsbilder analysieren und Emotionen wie Wut, Freude oder Überraschung identifizieren. Anstatt dass Menschen manuell definieren müssen, wie jede Emotion aussieht, lernt das Modell Muster, indem es Tausende von Gesichtsbildern untersucht. Durch Faltungs- und Pooling-Schichten extrahiert es aussagekräftige Merkmale wie Gesichtsmuskelbewegungen und -ausdrücke, die dann von vollständig verbundenen Schichten verarbeitet und mithilfe einer SoftMax-Funktion klassifiziert werden, um die wahrscheinlichste Emotion zu bestimmen.
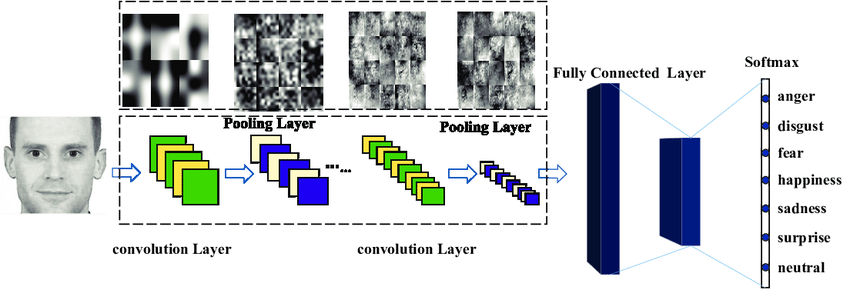
Abbildung 26: Deep-Learning-basierte Pipeline zur Erkennung von Gesichtsemotionen.
Das Gedächtnis und die Sequenzverarbeitung im menschlichen Gehirn spielen ebenfalls eine entscheidende Rolle bei der Entscheidungsfindung und Mustererkennung. Hier kommen Deep-Learning-Modelle wie rekurrenten neuronalen Netzen (RNNs) und Long Short-Term Memory (LSTM)-Netzwerken zum Einsatz. Diese Modelle versuchen, die Art und Weise nachzubilden, wie Menschen sich an vergangene Erfahrungen erinnern und diese nutzen, um gegenwärtige Entscheidungen zu beeinflussen. Sie sind besonders effektiv bei der Verarbeitung sequenzieller Daten, wie Sprache, Zeitreihenvorhersagen oder Netzwerkverkehrsanalysen.
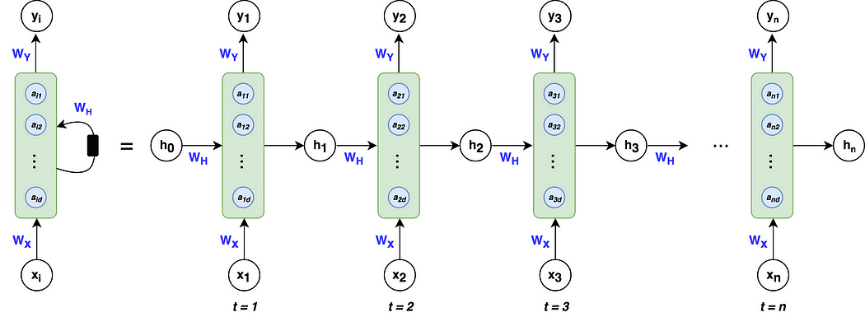
Abbildung 27: Einfache Architektur eines rekurrenten neuronalen Netzwerks
(Khuong, 2025)
Die Sprachverarbeitung ist ein weiterer Bereich, in dem Deep Learning hervorragende Leistungen erbringt, indem es die Art und Weise nachahmt, wie das menschliche Gehirn Sprache interpretiert und generiert. Transformer-basierte Modelle wie BERT und GPT analysieren riesige Textmengen und lernen so, Sprachmuster zu verstehen, ohne dass vordefinierte Grammatikregeln erforderlich sind. In der maritimen Cybersicherheit können solche Modelle E-Mails, Funkkommunikation und Systemprotokolle scannen, um Phishing-Versuche, betrügerische Nachrichten oder unbefugte Anweisungen zu erkennen, die als normale Kommunikation getarnt sind. Anstatt sich auf die einfache Erkennung von Schlüsselwörtern zu verlassen, verstehen diese Modelle den Kontext und die Absicht, wodurch sie sehr effektiv bei der Erkennung subtiler Bedrohungen sind, die herkömmliche regelbasierte Systeme übersehen würden.
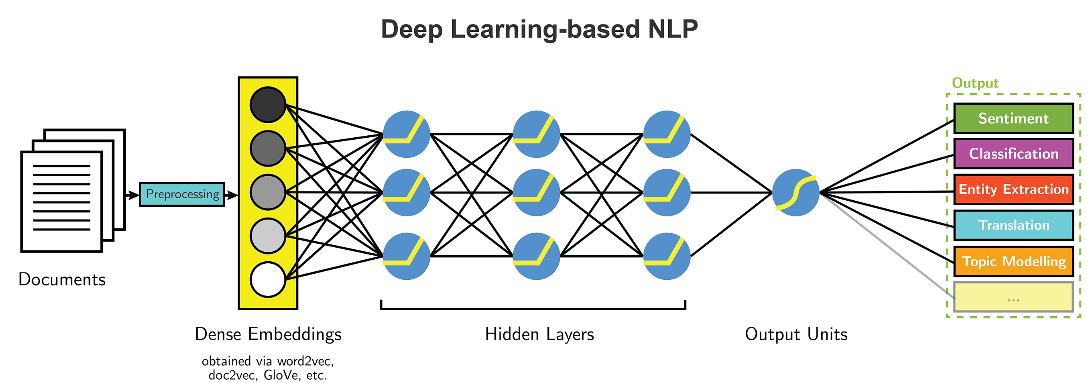
Abbildung 28: Deep-Learning-basierte NLP- .
Die Kernstärke des Deep Learning liegt in seiner Fähigkeit, relevante Merkmale automatisch aus riesigen Mengen unstrukturierter Daten zu lernen. Im Gegensatz zu herkömmlichen Ansätzen des maschinellen Lernens, bei denen menschliche Experten Merkmale entwickeln müssen (d. h. entscheiden müssen, welche Aspekte der Daten wichtig sind), zeichnen sich Deep-Learning-Modelle dadurch aus, dass sie diese Merkmale selbstständig erkennen können, wie in Abbildung29 dargestellt. Unabhängig davon, ob die Daten aus Bildern, Netzwerkprotokollen, Sensorwerten oder Text bestehen, analysiert das System zahlreiche Beispiele, verfeinert nach und nach sein Verständnis und identifiziert autonom die aussagekräftigsten Muster. Dadurch entfällt die manuelle Merkmalsentwicklung, ein Prozess, der zeitaufwändig sein kann, spezielle Fachkenntnisse erfordert und möglicherweise nicht alle in den Daten verborgenen Nuancen erfasst.
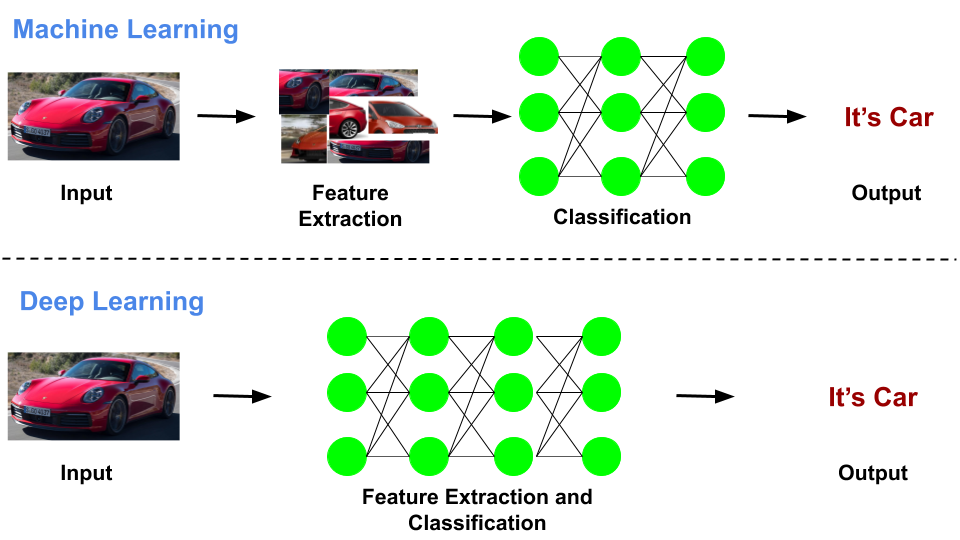
Abbildung 29: Unterschiede zwischen Machine Learning und Deep Learning Pipeline .
In der Schifffahrtsindustrie kann KI in Cybersicherheitssysteme integriert werden, um die riesigen Datenmengen zu verarbeiten, die von Schiffen, Häfen und Satellitenverbindungen erzeugt werden. Da sich Bedrohungen weiterentwickeln, können sich ML- und DL-Modelle mithilfe neuer Informationen kontinuierlich aktualisieren und Risiken oder Angriffe erkennen, die möglicherweise nie explizit in von Menschen verfassten Regeln beschrieben wurden. Diese Fähigkeit, sich im Laufe der Zeit anzupassen und zu verfeinern, macht KI so wertvoll für die Bewältigung moderner Cybersicherheitsherausforderungen. Abbildung30 bietet einen allgemeinen Überblick über KI-Anwendungen in der Cybersicherheit.
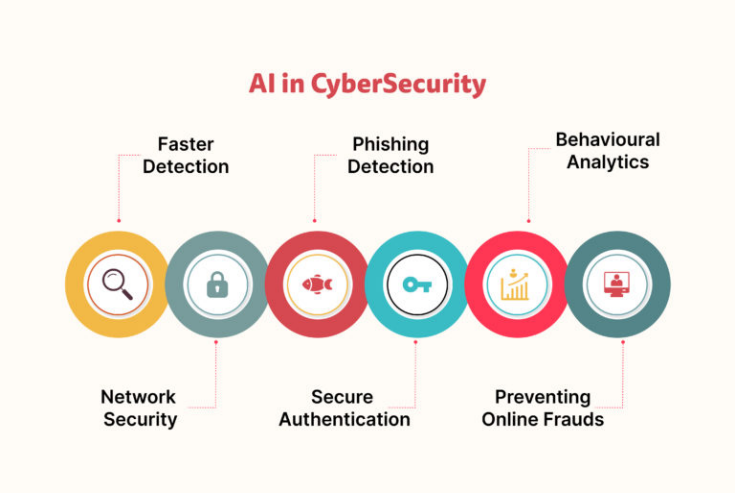
Abbildung 30: Anwendungen von KI in der Cybersicherheit .
Entwicklung von Modellen für maschinelles Lernen/Deep Learning
Der Prozess der Entwicklung eines Modells für maschinelles Lernen oder Deep Learning folgt einer strukturierten Abfolge von Schritten, von der Datenerfassung bis zur Bereitstellung und Wartung des Modells. Jeder Schritt spielt eine entscheidende Rolle, um sicherzustellen, dass das System in realen Umgebungen genaue und zuverlässige Vorhersagen treffen kann. Nachfolgend finden Sie eine detaillierte Aufschlüsselung der gesamten Pipeline sowie Erläuterungen, um sie für diejenigen verständlicher zu machen, die mit diesem Bereich nicht vertraut sind.
Datenerfassung: Sammeln relevanter Informationen
Der erste Schritt in jedem ML- oder DL-Projekt ist die Datenerfassung. Ohne hochwertige Daten können selbst die besten Algorithmen nur schwer nützliche Ergebnisse liefern. Die Daten können je nach Problemstellung aus verschiedenen Quellen stammen. Im Falle der maritimen Cybersicherheit können relevante Daten beispielsweise Netzwerkverkehrsprotokolle, Sicherheitsereignisprotokolle und Systemleistungsmetriken umfassen. Netzwerkprotokolle erfassen die Kommunikation zwischen Geräten und helfen dabei, ungewöhnliche Muster zu identifizieren, die auf Cyberbedrohungen hinweisen können. Sicherheitsereignisprotokolle enthalten Warnmeldungen, die von Cybersicherheitssystemen generiert werden, wenn verdächtige Aktivitäten erkannt werden. Systemleistungsdaten wie CPU-Auslastung oder Speicheraktivität können Aufschluss über potenzielle Sicherheitsverletzungen oder Ausfälle geben. Die Art der erfassten Daten hängt vollständig von dem spezifischen Problem ab, das mit dem Modell gelöst werden soll. Für die Intrusion Detection sind möglicherweise Netzwerkdaten auf Paketebene erforderlich, während für die Schiffsüberwachung Echtzeit-Videomaterial relevanter wäre.
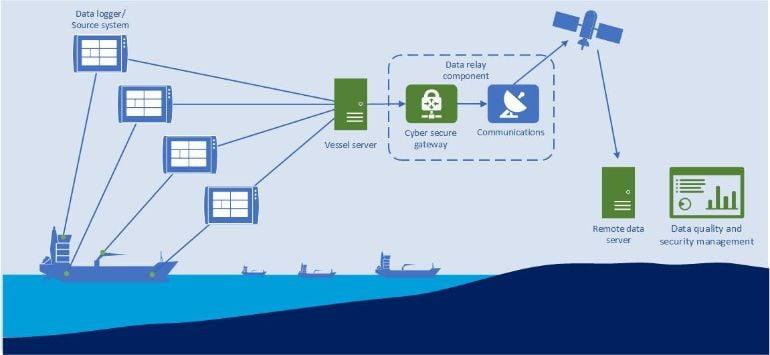
Abbildung 31: Beispiel für die Datenerfassung in der maritimen Überwachung .
Datenaufbereitung: Bereinigung und Formatierung von Daten für die Analyse
Rohdaten sind oft unstrukturiert, inkonsistent oder enthalten Fehler, die sich negativ auf die Modellleistung auswirken können. Um sicherzustellen, dass die Daten verwendbar sind, müssen sie eine Vorbereitungsphase durchlaufen. Dieser Prozess umfasst mehrere wichtige Schritte, darunter die Behandlung fehlender Werte, die Entfernung von Rauschen und die Standardisierung der Eingaben. Fehlende Werte können aufgrund fehlerhafter Sensoren oder unvollständiger Protokolle auftreten und müssen entweder durch das Einfügen geschätzter Werte oder das Verwerfen unvollständiger Datensätze behoben werden. Rauschen, wie z. B. beschädigte Datenpunkte oder irrelevante Informationen, muss entfernt werden, um zu verhindern, dass das Modell falsche Muster lernt. Die Standardisierung ist ein weiterer wichtiger Schritt, da Daten oft in unterschiedlichen Formaten oder Einheiten vorliegen. Beispielsweise müssen Zeitstempel in Netzwerkprotokollen möglicherweise in eine einheitliche Zeitzone konvertiert werden, oder numerische Werte müssen normalisiert werden, um sicherzustellen, dass sie auf einer vergleichbaren Skala liegen. Bei strukturierten Datensätzen, wie Tabellen mit Netzwerkaktivitäten, kann diese Phase auch das Entfernen doppelter Einträge umfassen. Bei unstrukturierten Daten wie Bildern oder Texten kann die Vorverarbeitung das Ändern der Bildgröße, das Reduzieren von Hintergrundrauschen oder das Konvertieren von Wörtern in numerische Darstellungen umfassen, die das Modell verarbeiten kann.
Feature Engineering: Identifizieren oder Erstellen aussagekräftiger Muster
Beim traditionellen maschinellen Lernen verstehen Modelle nicht von Natur aus, welche Aspekte der Daten relevant sind. Stattdessen müssen Experten manuell die Merkmale definieren, die für die Lösung des Problems am nützlichsten sind. Dieser als Feature Engineering bezeichnete Prozess umfasst die Auswahl, Transformation oder Erstellung neuer Variablen aus Rohdaten, um die Modellleistung zu verbessern. Effektives Feature Engineering kann die Genauigkeit eines Modells erheblich verbessern, indem es ihm aussagekräftige Informationen liefert. In einem Intrusion-Detection-System können beispielsweise rohe Netzwerkverkehrsprotokolle Details wie IP-Adressen, Zeitstempel, Paketgrößen und Verbindungsstatus enthalten. Diese Rohwerte allein sind jedoch möglicherweise nicht aussagekräftig genug für das Modell. Um die Erkennung zu verbessern, könnte ein Experte neue Merkmale auf der Grundlage statistischer Muster oder Verhaltenstrends erstellen. Ein solches Merkmal könnte die Verbindungsversuchsrate sein, bei der die Anzahl der Verbindungsanfragen von einer bestimmten IP-Adresse innerhalb eines bestimmten Zeitfensters, z. B. 10 Sekunden, gemessen wird. Ein plötzlicher Anstieg der Verbindungsversuche könnte auf einen Brute-Force-Angriff hindeuten.
Deep Learning macht jedoch Feature Engineering weitgehend überflüssig. Anstatt sich auf die menschliche Intuition zu verlassen, um wichtige Merkmale zu definieren, lernen tiefe neuronale Netze Muster automatisch direkt aus Rohdaten. Dies ist einer der größten Vorteile von DL gegenüber traditionellem ML. Es kann unstrukturierte Daten wie Bilder, Audio und Text verarbeiten, ohne dass explizite Regeln für die Merkmalsextraktion erforderlich sind. Bei der Bilderkennung kann ein Convolutional Neural Network beispielsweise lernen, Kanten, Texturen und komplexe Objekte ohne menschliches Zutun zu erkennen, was es für Anwendungen wie die Analyse von Echtzeit-Überwachungsaufnahmen auf Schiffen äußerst effektiv macht.
Modellauswahl: Auswahl des richtigen Algorithmus
Nachdem die Daten vorbereitet wurden, besteht der nächste Schritt darin, das beste Modell für das Problem auszuwählen. Die Wahl des Algorithmus hängt von Faktoren wie der Art der Daten, der Komplexität der Aufgabe und den verfügbaren Rechenressourcen ab. Im traditionellen ML werden häufig Modelle wie Entscheidungsbäume, Support-Vektor-Maschinen (SVMs) oder Random Forests verwendet, insbesondere bei der Arbeit mit strukturierten Datensätzen. Diese Modelle erfordern manuell definierte Merkmale, können aber mit relativ kleinen Datensätzen gute Ergebnisse erzielen.
Deep-Learning-Modelle sind hingegen leistungsfähiger, erfordern jedoch große Datenmengen und Rechenressourcen. CNNs sind besonders effektiv für bildbezogene Aufgaben, wie z. B. die Erkennung von Objekten in Aufnahmen der Seeverwachung. Rekursive neuronale Netze oder Transformer eignen sich besser für sequenzielle Daten, wie z. B. die Analyse von Kommunikationsprotokollen im Zeitverlauf, um Muster von Cyber-Bedrohungen zu erkennen. Die Auswahl des richtigen Modells ist ein entscheidender Schritt, da eine falsche Wahl zu schlechter Leistung oder ineffizienter Berechnung führen kann.
Modelltraining: Lernen aus Daten
Nach der Auswahl eines Modells besteht der nächste Schritt darin, es für Vorhersagen zu trainieren. Beim Training werden Daten in das Modell eingespeist, damit es Muster lernen kann, und seine internen Parameter werden angepasst, um die Genauigkeit zu verbessern. Das Modell erstellt erste Vorhersagen, und eine Verlustfunktion misst, wie weit diese Vorhersagen von den richtigen Antworten entfernt sind. Ist der Verlust hoch, bedeutet dies, dass das Modell schlechte Vorhersagen trifft. Um dies zu verbessern, werden in einem Optimierungsprozess, beispielsweise durch Gradientenabstieg, die Parameter des Modells (bekannt als Gewichte) aktualisiert, um den Verlust schrittweise zu reduzieren. Dieser iterative Prozess wird fortgesetzt, bis das Modell ein akzeptables Maß an Genauigkeit erreicht hat.
Beim überwachten Lernen wird das Modell anhand von gekennzeichneten Daten trainiert, d. h., jede Eingabe hat eine bekannte korrekte Ausgabe (z. B. Klassenbezeichnungen bei der Klassifizierung oder Zielwerte bei der Regression). Das Ziel besteht darin, die Differenz zwischen Vorhersagen und tatsächlichen Bezeichnungen zu minimieren, in der Regel unter Verwendung von Verlustfunktionen wie Kreuzentropie (für die Klassifizierung) oder mittlerer quadratischer Fehler (für die Regression).
Beim Deep Learning ist dieser Prozess rechenintensiv und erfordert große Datensätze. Im Gegensatz zum traditionellen ML, bei dem das Training in wenigen Minuten oder Stunden abgeschlossen sein kann, kann das Training tiefer neuronaler Netze je nach Komplexität der Architektur und Größe der Daten Tage oder sogar Wochen dauern. Um diese Komplexität zu bewältigen, bieten Deep-Learning-Frameworks wie TensorFlow und PyTorch effiziente Tools für die Modellerstellung, automatische Differentiation und Hardwarebeschleunigung. Diese Bibliotheken unterstützen dynamische Berechnungsgraphen und bieten eine Vielzahl vorgefertigter Funktionen zur Modelloptimierung. Die Hyperparameter-Optimierung, also die Anpassung von Parametern wie Lernrate, Batchgröße und Anzahl der Trainings-Epochen, ist unerlässlich, um eine effektive Konvergenz des Modells sicherzustellen.
Beim unüberwachten Lernen wird das Modell anhand unbeschrifteter Daten trainiert, d. h. es gibt keine vordefinierten Kategorien oder richtigen Antworten. Anstatt bestimmte Ergebnisse vorherzusagen, identifiziert das Modell Muster, Strukturen oder Cluster in den Daten.
Clustering-Algorithmen gruppieren ähnliche Datenpunkte anhand von Distanzmaßen.
Techniken zur Dimensionsreduktion können hochdimensionale Daten in eine niedrigdimensionale Form komprimieren und dabei wichtige Informationen erhalten.
Generative Modelle lernen, neue Datenproben zu generieren, die der Trainingsverteilung ähneln.
Da keine explizite Verlustfunktion Vorhersagen mit der Grundwahrheit vergleicht, umfasst das Training oft unüberwachte Ziele, wie z. B. die Minimierung von Rekonstruktionsfehlern oder die Maximierung der Varianz zwischen Clustern.
Modellvalidierung und -test: Bewertung der Leistung
Nach Abschluss des Trainings muss unbedingt getestet werden, wie gut das Modell auf neue, unbekannte Daten generalisiert. Dies geschieht durch Validierung und Testen unter Verwendung separater Datensätze, die nicht Teil des Trainingsprozesses waren. Wenn ein Modell während des Trainings gute Leistungen erbringt, aber keine genauen Vorhersagen für neue Daten liefert, ist es wahrscheinlich überangepasst, d. h., es hat zu spezifische Muster für den Trainingssatz gelernt und lässt sich nicht gut auf unbekannte Daten generalisieren. Leistungskennzahlen wie Genauigkeit, Präzision, Recall und der F1-Score werden verwendet, um die Effektivität des Modells zu bewerten. Die Genauigkeit misst den Anteil korrekter Vorhersagen, während Präzision und Recall Aufschluss über die Zuverlässigkeit des Modells bei der Erkennung bestimmter Kategorien, wie z. B. Cyber-Bedrohungen, geben. Der F1-Score gleicht Präzision und Recall aus und bietet eine umfassendere Bewertung. Wenn die Leistung des Modells nicht zufriedenstellend ist, können Anpassungen vorgenommen werden, indem mehr Daten gesammelt, die Merkmalsauswahl (im ML) verfeinert oder Hyperparameter feinabgestimmt werden.
Bereitstellung und kontinuierliche Überwachung: Einsatz des Modells in der Praxis
Sobald das Modell eine zufriedenstellende Genauigkeit und Robustheit erreicht hat, wird es in einer realen Umgebung eingesetzt, wo es beginnt, Vorhersagen zu Live-Daten zu treffen. Die Bereitstellung ist jedoch nicht der letzte Schritt, denn eine kontinuierliche Überwachung und Wartung sind notwendig, um eine anhaltende Leistung sicherzustellen. Im Bereich der maritimen Cybersicherheit beispielsweise tauchen ständig neue Cyberbedrohungen auf, und ein Modell, das auf der Grundlage früherer Angriffsmuster trainiert wurde, kann mit der Zeit veralten. Um eine Leistungsminderung zu verhindern, müssen Modelle regelmäßig mit aktualisierten Daten neu trainiert, kontinuierlich auf Fehler überwacht und an sich ändernde Bedingungen angepasst werden. Andernfalls kann es zu veralteten Vorhersagen, Sicherheitslücken oder einer sinkenden Genauigkeit kommen.
Eine allgemeine Übersicht über die Trainingspipeline für ein überwachtes maschinelles Lernmodell ist in Abbildung32 dargestellt.
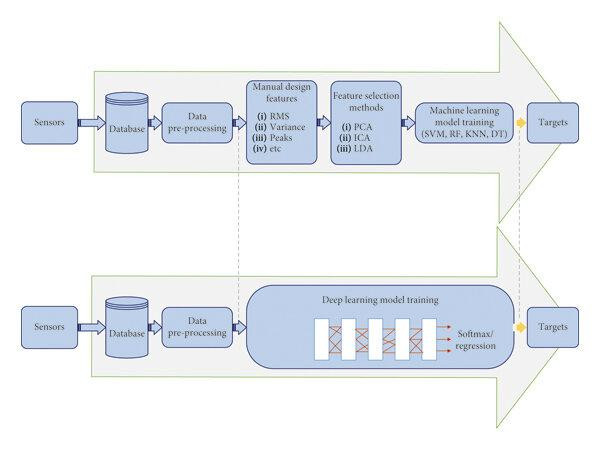
Abbildung 32: Überblick über die Trainingspipelines für ML/DL-Modelle .
Anwendungen von KI in der maritimen Cybersicherheit
Intrusion Detection Systems (IDS)
Ein Intrusion Detection System (IDS) ist eine Sicherheitslösung, die dazu dient, unbefugte Zugriffe, böswillige Aktivitäten und potenzielle Bedrohungen zu erkennen, indem sie den Netzwerkverkehr, das Benutzerverhalten und die Systemprotokolle kontinuierlich überwacht. Die Platzierung eines IDS hängt von seinem Typ ab. Ein netzwerkbasiertes IDS (NIDS) wird in der Regel zwischen der Firewall und dem internen Netzwerk platziert, wie in Abbildung33 dargestellt, wo es den gesamten ein- und ausgehenden Datenverkehr auf verdächtige Muster überprüft, bevor diese kritische Systeme erreichen. Wenn ein Angreifer die Firewall umgeht, erkennt das IDS Anomalien und generiert eine Warnmeldung für weitere Untersuchungen. Ein hostbasiertes IDS (HIDS) hingegen wird direkt auf einzelnen Geräten wie dem Navigationssystem eines Schiffes, Servern oder Workstations installiert, wo es Systemprotokolle, Dateiintegrität und Benutzeraktivitäten überwacht, um böswillige Änderungen zu erkennen. Im maritimen Kontext spielen IDS eine entscheidende Rolle beim Schutz kritischer Vorgänge wie Frachtmanagement, Navigation und Kommunikationsnetzwerke (MarPoint, 2025).
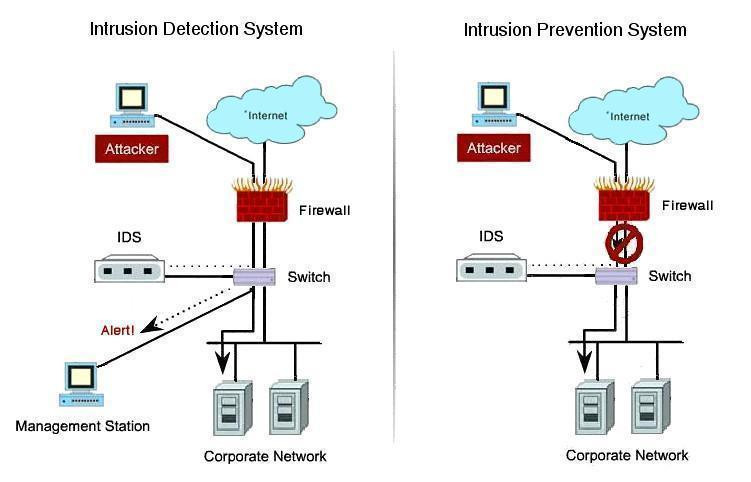
Abbildung 33: Intrusion Detection System
DS nutzt zwei primäre Ansätze zur Erkennung böswilliger Aktivitäten:
- Signaturbasierte Erkennung: Vergleicht beobachtete Aktivitäten mit einer Datenbank bekannter Angriffssignaturen unter Verwendung von String-Matching-Techniken. Diese Methode ist sehr effektiv für die Identifizierung bereits bekannter Bedrohungen, kann jedoch neue oder sich weiterentwickelnde Angriffe nicht erkennen.
- Verhaltensbasierte Erkennung: Überwacht Abweichungen von normalen Aktivitätsmustern und ermöglicht so die Identifizierung neuer oder unbekannter Bedrohungen. Diese Methode ist zwar anpassungsfähiger, kann jedoch zu mehr Fehlalarmen führen.
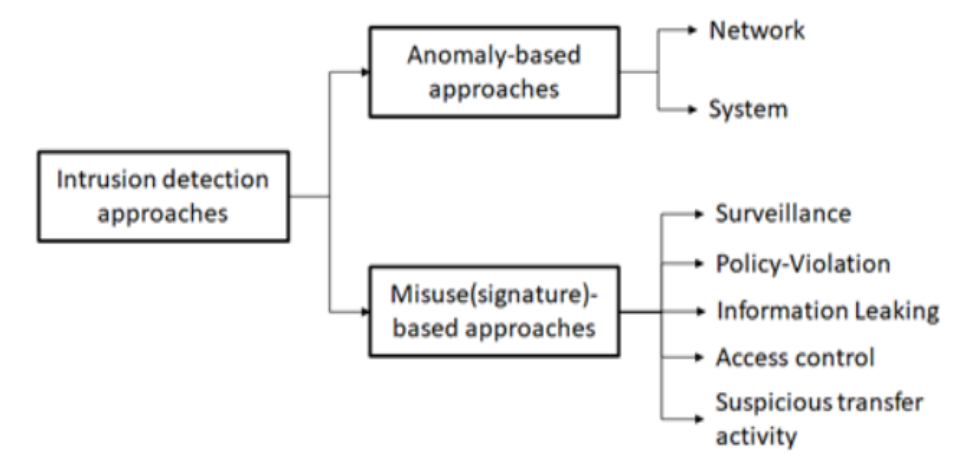
Abbildung 34: Klassifizierung von Ansätzen zur Intrusion Detection .
KI-gesteuerte IDS verbessern die Sicherheit, indem sie Daten in Echtzeit analysieren, Anomalien identifizieren und typische Netzwerkmuster von schädlichen Eindringversuchen unterscheiden. Durch die Integration sowohl überwachter Methoden, die auf bekannten Angriffssignaturen basieren, als auch unüberwachter Methoden, die ungewöhnliche Abweichungen von normalen Aktivitäten erkennen, reduzieren KI-basierte IDS Fehlalarme und verbessern die Erkennungsgenauigkeit.
KI-gestützte IDS verwenden Algorithmen des maschinellen Lernens, um Bedrohungen genauer zu erkennen. Diese Algorithmen helfen IDS dabei, sowohl bekannte als auch unbekannte Cyberangriffe zu erkennen.
- Überwachtes Lernen: Bei diesem Ansatz wird ein KI-Modell anhand von Angriffsdaten aus der Vergangenheit trainiert, die als „sicher” oder „gefährlich” gekennzeichnet sind. Die KI lernt aus diesen Daten und wendet ihr Wissen dann an, um neue Bedrohungen zu erkennen.
- Unüberwachtes Lernen: Im Gegensatz zum überwachten Lernen erfordert diese Methode keine gekennzeichneten Daten. Stattdessen identifiziert die KI ungewöhnliche Aktivitäten, indem sie Muster erkennt, die nicht dem normalen Verhalten entsprechen.
Ein häufiges Problem bei herkömmlichen IDS sind Fehlalarme, bei denen harmlose Netzwerkaktivitäten fälschlicherweise als Bedrohung gekennzeichnet werden. KI reduziert Fehlalarme, indem sie aus früheren Fehlern lernt und ihre Genauigkeit im Laufe der Zeit verbessert. KI kann auch mehrere Erkennungsmethoden kombinieren, um die Ergebnisse zu verbessern. Durch die Kombination von signaturbasierter und verhaltensbasierter Erkennung minimieren KI-gestützte IDS Fehler und gewährleisten gleichzeitig eine hohe Sicherheit. Einige KI-Modelle verwenden sogar verstärktes Lernen, eine Technik, bei der die KI ihre Erkennungsregeln auf der Grundlage von Rückmeldungen kontinuierlich anpasst.
Da ein IDS ein passives System ist, ergreift es keine direkten Maßnahmen gegen erkannte Bedrohungen. Stattdessen generiert es Warnmeldungen für menschliche Bediener oder integriert sich in SIEM-Systeme (Security Information and Event Management) zur weiteren Analyse und Reaktion. Eindringversuche können sowohl von externen als auch von internen Quellen ausgehen, was IDS zu einer wesentlichen Komponente von Cybersicherheitsstrategien in allen Branchen macht.
Intrusion Prevention Systems (IPS)
Ein Intrusion Prevention System (IPS) ist eine Sicherheitstechnologie, die entwickelt wurde, um böswillige Aktivitäten innerhalb eines Netzwerks oder Systems zu erkennen und proaktiv zu verhindern. Im Gegensatz zu einem IDS, das verdächtige Aktivitäten passiv überwacht und meldet, ergreift ein IPS direkte Maßnahmen, um Angriffe in Echtzeit zu blockieren, abzuschwächen oder zu stoppen. Während ein IDS im Wesentlichen ein Überwachungsinstrument ist, fungiert ein IPS als Kontrollsystem, das Bedrohungen aktiv verhindert, bevor sie Schäden in Bereichen wie Navigation, Frachtumschlag oder Kommunikationsverbindungen verursachen (Sowmya und Anita, 2023).
IPS wird in der Regel hinter einer Firewall, aber vor internen Systemen eingesetzt, sodass es sowohl den eingehenden als auch den ausgehenden Datenverkehr überprüfen kann, wie in Abbildung35 dargestellt. Im Gegensatz zu einer Firewall, die in erster Linie auf der Grundlage vordefinierter Regeln filtert, nutzt ein IPS fortschrittliche Analysen, um dynamische Bedrohungen in Echtzeit zu erkennen und zu blockieren. In einigen Netzwerkarchitekturen arbeitet IPS zusammen mit IDS, wobei IDS Bedrohungen erkennt und Administratoren alarmiert, während IPS aktive Maßnahmen ergreift, um Bedrohungen zu neutralisieren.
Abbildung 35: Intrusion Prevention System
Wichtige Aktionen, die von einem IPS ausgeführt werden:
- Senden von Warnmeldungen an Administratoren.
- Verwerfen potenziell schädlicher Pakete.
- Blockieren von Verbindungen aus böswilligen Quellen.
- Neustart kompromittierter Verbindungen, um weitere Ausnutzung zu verhindern.
- KI-gesteuertes IPS für mehr Sicherheit
Moderne IPS-Lösungen nutzen KI-gesteuerte Analysen und Echtzeit-Datenfeeds, um Bedrohungen effektiver zu erkennen und zu blockieren. Durch kontinuierliches Lernen aus historischen und neuen Angriffsmustern verbessern diese Systeme ihre Genauigkeit und reduzieren Fehlalarme. Durch die Integration von KI-gesteuerten Analysen mit Echtzeit-Datenfeeds verbessern moderne IPS die Sicherheit, indem sie infizierte Endpunkte isolieren, bösartige IP-Adressen blockieren und Firewall-Regeln dynamisch ändern, um die seitliche Ausbreitung von Bedrohungen über Schiffs- und Hafennetzwerke zu verhindern (Maritime Intelligence, 2025). Ein bemerkenswertes Beispiel hierfür ist die Implementierung eines netzwerkbasierten IPS durch Cisco, das interne Netzwerkbedrohungen effektiv erkannte und abwehrte, bevor sie zu Datenverlusten oder Dienstunterbrechungen führen konnten. Durch die Analyse des ein- und ausgehenden Datenverkehrs innerhalb des Unternehmens bot das IPS von Cisco eine wichtige Verteidigungsebene und demonstrierte die Wirksamkeit von KI-gestützten IPS bei der proaktiven Neutralisierung von Cyberbedrohungen, bevor diese eskalieren (Contentree, 2025).
Open-Source-Systeme zur Erkennung und Abwehr von Eindringlingen
Da sich Cyber-Bedrohungen ständig weiterentwickeln, sind Open-Source-IDS und -IPS zu unverzichtbaren Tools für die Überwachung und Sicherung von Netzwerken geworden. Zwei der am weitesten verbreiteten Open-Source-IDS/IPS-Lösungen sind Snort und Suricata, die beide eine Echtzeit-Erkennung und -Prävention von Bedrohungen bieten und gleichzeitig Flexibilität und Anpassungsmöglichkeiten bieten.
Snort: Ein regelbasiertes IDS/IPS
Snort wurde ursprünglich 1998 von Martin Roesch entwickelt und ist ein signaturbasiertes IDS/IPS, das in der Lage ist, Echtzeit-Verkehrsanalysen und Paketprotokollierungen in IP-Netzwerken durchzuführen. Es verwendet eine regelbasierte Sprache, die es ermöglicht, Signaturen, Protokolle und anomaliebasierte Erkennungs -Techniken zu integrieren, um eine Vielzahl von Cyber-Bedrohungen zu identifizieren, darunter Denial-of-Service-Angriffe (DoS), Pufferüberläufe, Stealth-Port-Scans und CGI-Angriffe.
Snort funktioniert durch das Sniffen von Netzwerkpaketen mithilfe von Bibliotheken wie libpcap und WinPcap und kann in drei Hauptmodi betrieben werden:
- Paket-Sniffing-Modus – Erfasst und überwacht den rohen Netzwerkverkehr.
- Paketprotokollierungsmodus – Zeichnet Netzwerkpakete zur Analyse und Fehlerbehebung auf.
- Intrusion Detection Mode – Vergleicht die Netzwerkaktivität mit vordefinierten Regeln und sendet Warnmeldungen, wenn Bedrohungen erkannt werden.
Ein wesentlicher Vorteil von Snort ist seine anpassungsfähige Regelsprache, mit der Benutzer benutzerdefinierte Sicherheitsrichtlinien festlegen können. Es lässt sich gut in Firewalls integrieren und bietet so eine zusätzliche Verteidigungsebene, was es zu einem wertvollen Werkzeug für die interne Netzwerküberwachung macht.
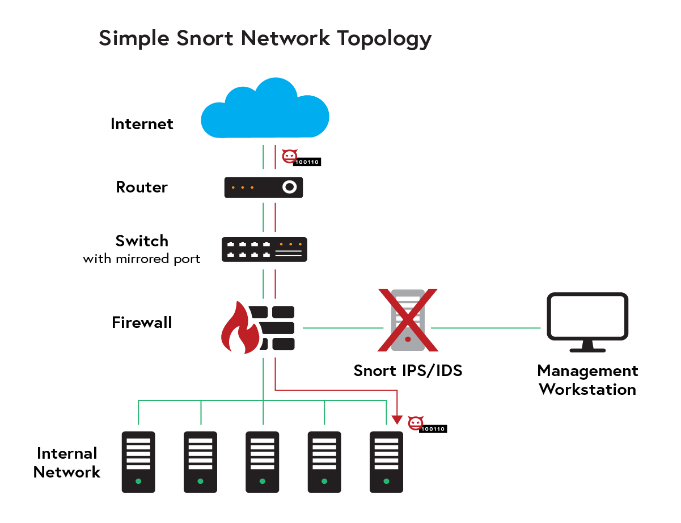
Abbildung 36: Einfache Snort-Netzwerktopologie .
Suricata: Hochleistungsfähiges IDS/IPS und Netzwerk-Sicherheitsüberwachung (NSM)
Suricata, entwickelt von der Open Information Security Foundation (OISF), ist ein IDS/IPS der nächsten Generation, das die traditionelle Netzwerksicherheitsüberwachung um Deep Packet Inspection (DPI) und natives Multithreading erweitert. Im Gegensatz zu Snort, das sich in erster Linie auf die signaturbasierte Erkennung konzentriert, kann Suricata mehrere Protokollschichten (einschließlich HTTP, TLS, DNS und SMB) analysieren, um komplexere und schwerer zu erkennende Bedrohungen zu erkennen.
Einer der wichtigsten Vorteile ist die Fähigkeit, Netzwerkverkehr dank seiner Multithreading-Architektur mit hoher Geschwindigkeit zu verarbeiten, wodurch es sich gut für den Einsatz in Unternehmen und cloudbasierten Sicherheitsumgebungen eignet. Darüber hinaus lässt es sich nahtlos in verschiedene Tools für Sicherheitsinformationen und Ereignismanagement sowie Datenanalyseplattformen integrieren und ermöglicht so die Visualisierung und Analyse potenzieller Bedrohungen in Echtzeit.
Eine weitere einzigartige Funktion von Suricata ist die Netzwerk-Sicherheitsüberwachung (NSM), mit der neben der Erkennung von Eindringlingen auch Metadaten aus dem Netzwerkverkehr extrahiert werden können. Diese Funktion hilft Cybersicherheitsteams dabei, Sicherheitsvorfälle effektiver zu untersuchen, und liefert tiefere Einblicke in das Netzwerkverhalten.
Deep Packet Inspection für die Erkennung komplexer Bedrohungen
Deep Packet Inspection (DPI) geht über die Untersuchung von Paket-Headern hinaus, indem es die Nutzdaten und Metadaten der übertragenen Daten analysiert und so einen detaillierten Einblick in Protokolle, Inhalte auf Anwendungsebene und benutzerdefiniertes Verhalten bietet. Im Gegensatz zur herkömmlichen Paketfilterung, bei der nur die IP- und TCP/UDP-Header überprüft werden, untersucht DPI das gesamte Paket und kann so bösartige Nutzdaten, Richtlinienverstöße oder verschlüsselte Bedrohungen identifizieren, die von einfacheren, nur auf Headern basierenden Filtersystemen oft übersehen werden (Leslie, 2020).
Eine DPI-Engine überprüft den Inhalt von Paketen in Echtzeit und filtert den Datenverkehr mithilfe von signaturbasiertem Abgleich, Heuristik und Anomalieerkennung. Sie kann Pakete anhand von Protokoll, Anwendungstyp und Inhalt klassifizieren, was für die Identifizierung von Bedrohungen, die in legitim aussehendem Netzwerkverkehr versteckt sind, unerlässlich ist. Beispielsweise kann DPI zwischen normalem HTTP-Verkehr und einem HTTP-basierten Angriff wie SQL-Injection oder Command-and-Control-Malware-Kommunikation unterscheiden. DPI ist auch in der Lage, SSL/TLS-Datenverkehr für Sicherheitsanalysen zu entschlüsseln, um sicherzustellen, dass verschlüsselte Pakete die Sicherheitskontrollen nicht umgehen. Viele moderne Cyberangriffe nutzen verschlüsselte Nutzdaten, um böswillige Aktivitäten zu verbergen, aber KI-gestützte DPI kann selbst in verschlüsselten Sitzungen Verhaltensanomalien identifizieren, wie z. B. ungewöhnliche Datenübertragungsmuster oder Datenverkehr zu bekannten bösartigen Domänen.
In Kombination mit KI- oder Machine-Learning-Algorithmen verbessert DPI die Erkennung von Bedrohungen, indem es aus vergangenen Netzwerkmustern lernt und Zero-Day-Angriffe oder fortgeschrittene persistente Bedrohungen erkennt, die herkömmliche Sicherheitsmaßnahmen umgehen.
Wenn eine Anomalie erkannt wird, können DPI-Systeme automatisierte Maßnahmen ergreifen, z. B. die Isolierung eines kompromittierten Endpunkts, die Beendigung verdächtiger Verbindungen oder die dynamische Neukonfiguration von Firewall-Regeln, um die Verbreitung von Malware in maritimen IT- und OT-Netzwerken zu verhindern (Ipoque, 2025).
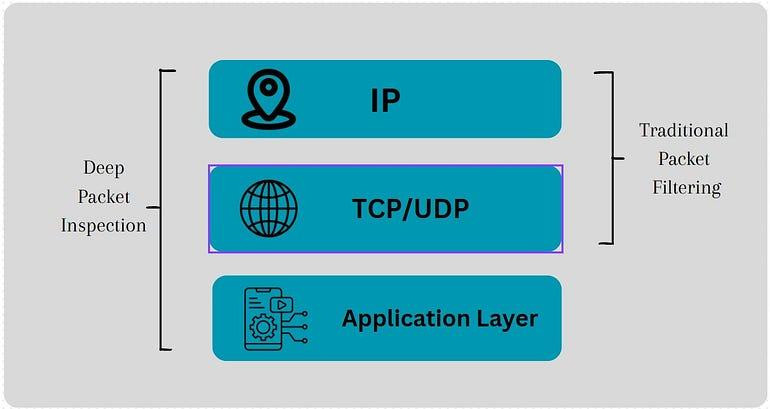
Abbildung 37: Vergleich zwischen herkömmlicher Paketfilterung und Deep Packet Inspection
(Nethmal, 2025).
Generative gegnerische Netzwerke für Datenvergrößerung und Verteidigung
Generative Adversarial Networks (GANs) bestehen aus zwei konkurrierenden neuronalen Netzwerken: einem Generator, der synthetische Daten erstellt, und einem Diskriminator, der deren Authentizität bewertet, wie in Abbildung38 dargestellt. Ursprünglich für die Bildsynthese und die Erzeugung von Deepfakes entwickelt, haben sich GANs als äußerst effektiv in Cybersicherheitsanwendungen erwiesen, insbesondere bei der Intrusion Detection, dem Adversarial Training und der Malware-Analyse. Durch die Generierung hochrealistischer Angriffsbeispiele verbessern GANs maschinell lernbasierte Sicherheitsmodelle und ermöglichen ihnen, sowohl bekannte als auch bisher unbekannte Bedrohungen zu erkennen (Zhao, 2024).
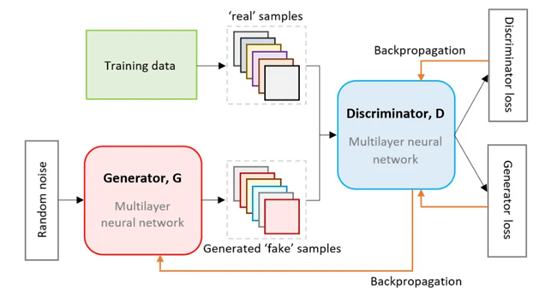
Abbildung 38: Architektur eines GAN-Netzwerks
(TVS, 2025).
Eine der Anwendungen von Generative Adversarial Networks (GANs) in der Cybersicherheit ist ihre Fähigkeit, synthetische Malware-Muster oder Exploit-Versuche zu erzeugen und so die Trainingsdatensätze für IDS und IPS effektiv zu erweitern. Herkömmliche IDS/IPS-Lösungen basieren auf signaturbasierter Erkennung, die mit Zero-Day-Bedrohungen und sich ständig weiterentwickelnder polymorpher Malware zu kämpfen hat. Durch das Training von IDS/IPS-Modellen mit von GANs generierten gegnerischen Mustern können Cybersicherheitssysteme ihre Widerstandsfähigkeit gegenüber bisher unbekannten Angriffsstrategien verbessern. GANs werden auch bei automatisierten Penetrationstests eingesetzt, wo sie Variationen von Phishing-E-Mails, Brute-Force-Angriffs-Payloads oder Exploit-Skripte generieren, um die Sicherheitslage eines Unternehmens zu testen. Durch die Simulation realer Cyberbedrohungen ermöglichen GAN-gesteuerte Penetrationstests eine kontinuierliche Sicherheitsbewertung, ohne die Systeme tatsächlichen Angriffen auszusetzen.
Über die Intrusion Detection hinaus werden GANs häufig zur Anomalieerkennung eingesetzt. Ein GAN-basierter Anomalie-Detektor lernt zunächst die statistische Verteilung des normalen Netzwerkverhaltens und erkennt dann subtile Abweichungen, die auf versteckte Cyber-Bedrohungen, verschleierte Malware oder Versuche der Datenexfiltration hinweisen könnten. Im Gegensatz zur traditionellen regelbasierten Anomalieerkennung passen sich GANs kontinuierlich an neue Netzwerkbedingungen an, wodurch Fehlalarme reduziert und die Erkennungsgenauigkeit verbessert werden. Diese Fähigkeit, anomales Verhalten zu erkennen, ist besonders nützlich bei der Erkennung von fortgeschrittenen, hartnäckigen Bedrohungen, die sich in den legitimen Datenverkehr einfügen.
Eine weitere innovative Anwendung von GANs ist das Adversarial Training, bei dem Cybersicherheitsmodelle gegen ausweichende Angriffstechniken gehärtet werden. Angreifer verwenden häufig gegnerische Machine-Learning-Techniken, um IDS/IPS-Modelle zu manipulieren und Angriffs-Payloads zu erstellen, die herkömmliche Erkennungsmechanismen umgehen. Durch das Training von GANs zur Simulation gegnerischer Angriffe können Cybersicherheitsmaßnahmen einem Stresstest unterzogen und verstärkt werden, um die Robustheit gegen gegnerische Angriffe sicherzustellen.
Anomalieerkennung
Während IDS sich oft auf bestimmte Arten von Eindringversuchen konzentrieren, ist die Anomalieerkennung eine umfassendere Technik, die jedes atypische oder ungewöhnliche Verhalten identifiziert, das möglicherweise auf einen Systemfehler oder eine Cyberbedrohung hinweist. Durch die Überwachung von Indikatoren wie der Nutzung von Systemressourcen, der Netzwerklatenz und den Anmeldeversuchen erstellen Anomalieerkennungsalgorithmen eine Basislinie dafür, wie „normale“ Aktivitäten aussehen. Jede größere Abweichung von diesem Muster kann ein Sicherheitsproblem oder ein Betriebsproblem darstellen. In vielen maritimen Anwendungen können KI-Systeme automatisierte Gegenmaßnahmen einleiten, wie z. B. die Isolierung kompromittierter Netzwerke oder die Anpassung von Firewall-Regeln, um potenzielle Bedrohungen schnell einzudämmen (Ribeiro et al., 2023). Diese schnelle, autonome Reaktion ist in der Schifffahrt von entscheidender Bedeutung, wo kleine Zwischenfälle schnell zu großen logistischen oder sicherheitstechnischen Herausforderungen eskalieren können, wenn sie nicht sofort behoben werden.
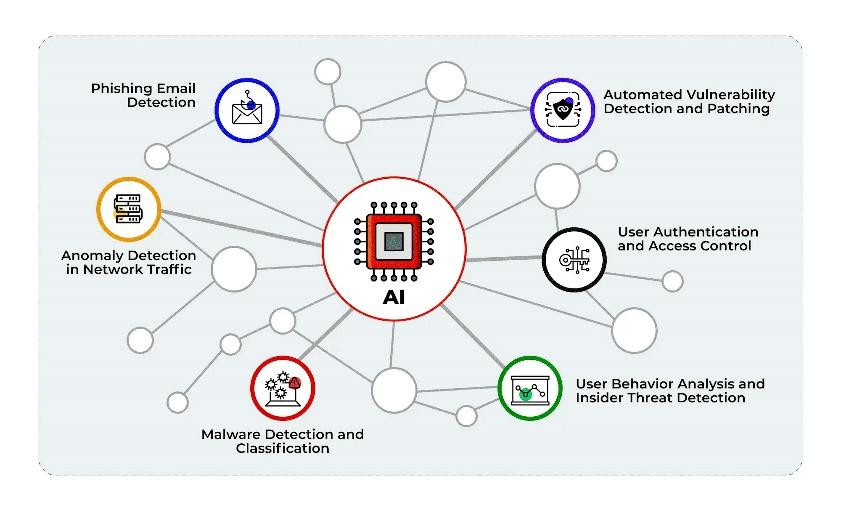
Abbildung 39: Anwendungen der Anomalieerkennung in Cybersicherheits .
Prädiktive Analyse für Cyberbedrohungen
Die prädiktive Analyse nutzt historische Daten und Verhaltensmuster, um potenzielle Schwachstellen und zukünftige Angriffsstrategien zu antizipieren und so eine proaktive Cyberabwehr zu ermöglichen. Durch die Untersuchung großer Mengen vergangener Vorfälle können KI-Modelle Faktoren isolieren, die häufig Angriffen vorausgehen (Merrick, 2022). In der Praxis simulieren diese Algorithmen verschiedene Angriffsszenarien, um Schwachstellen zu identifizieren, und vermitteln den Sicherheitsteams ein klares Bild davon, wo sie ihre Ressourcen zuerst einsetzen sollten. Durch die Zuweisung von Risikobewertungen zu verschiedenen Bedrohungen können maritime Betreiber ihre Abwehrmaßnahmen priorisieren und verstärken, um kritische Systeme zu schützen. Dieser Ansatz reduziert nicht nur unmittelbare Risiken, sondern verbessert auch die langfristige Widerstandsfähigkeit gegen sich entwickelnde Cyberbedrohungen (Meijer und Wessels, 2019). Prädiktive Analysen werden häufig in Sicherheitsinformations- und Ereignismanagementsysteme integriert, um Echtzeitdaten aus mehreren Quellen zu korrelieren und so die Genauigkeit bei der Vorhersage von Bedrohungen zu verbessern. In Kombination mit Intrusion Detection and Prevention Systems können diese Modelle automatisierte Abwehrmaßnahmen auslösen, um Bedrohungen zu blockieren, bevor sie sich materialisieren.
Potenzielle Schwachstellen und gegnerische Angriffe
Obwohl KI die Cybersicherheit im Seeverkehr erheblich stärkt, birgt sie auch potenzielle Schwachstellen, die Angreifer auszunutzen versuchen könnten. Bei Angriffen werden sorgfältig manipulierte Daten in KI-Modelle eingespeist, um diese zu falschen Entscheidungen zu verleiten oder echte Bedrohungen zu ignorieren (Qiu et al., 2019). Beispielsweise könnten böswillige Akteure Malware so tarnen, dass ein KI-basiertes Erkennungssystem sie fälschlicherweise als harmlos einstuft. Eine weitere Gefahr ist das Modellvergiftung, bei der Angreifer falsche oder irreführende Informationen in die Trainingsdaten einschleusen und so die Genauigkeit des Modells nach und nach beeinträchtigen.
Um sich gegen diese Taktiken zu schützen, ergreifen maritime Organisationen häufig eine Reihe von Schutzmaßnahmen. Eine davon ist die regelmäßige Nachschulung mit auf Integrität geprüften Daten, um sicherzustellen, dass das Modell genau und auf dem neuesten Stand bleibt. Adversarial Training, bei dem das Modell während der Entwicklung absichtlich mit irreführenden Eingaben konfrontiert wird, hilft ihm ebenfalls, manipulative Angriffe zu erkennen und abzuwehren. Schließlich sind robuste Datenpipelines und Zugriffskontrollen unerlässlich, um sowohl den Trainingsprozess als auch den operativen Einsatz von KI zu schützen und die vielen Vorteile zu bewahren, die sie für die maritime Sicherheit und Effizienz mit sich bringt.
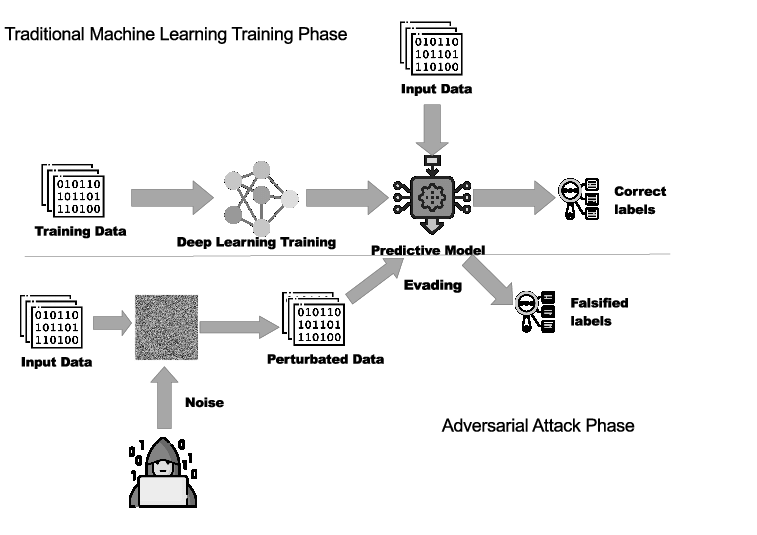
Abbildung 40: Beispiel für einen adversarialen Angriff
(Catak & Sule, (2020).
Herausforderungen und Grenzen der KI
KI-gesteuerte Systeme bieten verbesserte Fähigkeiten zur Identifizierung und Abwehr von Cyberbedrohungen, bringen jedoch eine Reihe von Herausforderungen und Einschränkungen mit sich, denen sich Unternehmen stellen müssen, um ihre Wirksamkeit zu maximieren.
Datenqualität und -verfügbarkeit
Ein wesentliches Problem betrifft die Datenqualität und -verfügbarkeit. Da diese Systeme in hohem Maße auf große Mengen hochwertiger Daten angewiesen sind, um ihre Erkennungsalgorithmen zu trainieren und zu verbessern, können Ungenauigkeiten oder Lücken in diesen Daten zu fehlerhaften Vorhersagen oder übersehenen Bedrohungen führen. Unternehmen stehen oft vor Schwierigkeiten, wenn sie versuchen, Daten aus mehreren Netzwerksegmenten und unterschiedlichen Quellen zu integrieren (Palo Alto Networks, 2025). Dies kann zu einem unvollständigen Bild der Benutzeraktivitäten und des Systemverhaltens führen und Lücken in der Erkennung von Bedrohungen verursachen.
Falsch-positive Ergebnisse und Alarmmüdigkeit
Eine weitere Herausforderung ergibt sich aus der hohen Anzahl von Fehlalarmen. Obwohl KI darauf abzielt, diese fehlerhaften Warnmeldungen zu reduzieren, kann sie dennoch eine Flut von Warnungen generieren, die die Sicherheitsteams überfordern. Diese Situation kann zu Alarmmüdigkeit führen, bei der das Sicherheitspersonal aufgrund des ständigen Zustroms von Meldungen mit geringem Risiko beginnt, potenziell wichtige Warnmeldungen zu übersehen (Olateju et al., 2024). Die Verwaltung und Untersuchung dieser zahlreichen Warnmeldungen erfordert einen erheblichen Zeit- und Ressourcenaufwand, wodurch die Aufmerksamkeit möglicherweise von echten Bedrohungen abgelenkt wird.
Komplexität und mangelnde Interpretierbarkeit
Komplexität und Interpretierbarkeit stellen zusätzliche Hürden dar. Moderne KI-Techniken, insbesondere Deep Learning, können durch undurchsichtige Entscheidungsprozesse zu Ergebnissen führen. Sicherheitsanalysten fällt es möglicherweise schwer, Warnmeldungen zu vertrauen oder darauf zu reagieren, wenn sie nicht verstehen, wie oder warum das KI-Modell zu einer bestimmten Schlussfolgerung gelangt ist (Digital Leaders, 2025). Daher ist es für den Aufbau von Vertrauen in KI-gesteuerte Sicherheitstools von entscheidender Bedeutung, dass das System klare Erklärungen und Begründungen liefert.
Integration in bestehende Systeme
In vielen Unternehmen verläuft die Integration in bestehende Systeme alles andere als reibungslos. KI-gesteuerte Systeme müssen nahtlos mit der bestehenden Sicherheitsinfrastruktur eines Unternehmens zusammenarbeiten, was Kompatibilitätsprobleme mit sich bringen und umfangreiches technisches Fachwissen erfordern kann. Ältere Systeme müssen oft aktualisiert werden, bevor sie die Datenverarbeitungsanforderungen und fortschrittlichen Analysen der KI bewältigen können. Diese Anforderungen erhöhen nicht nur die Komplexität der Bereitstellung, sondern verursachen auch zusätzliche Kosten und verlängern die Implementierungszeit.
Anfälligkeit für gegnerische Angriffe
KI-Modelle selbst können anfällig für Angriffe sein, bei denen böswillige Akteure absichtlich Eingaben manipulieren, um das System zu täuschen. Dazu gehört das Einfügen irreführender Muster oder Signale, die dazu führen, dass die KI Bedrohungen falsch klassifiziert oder unbefugten Zugriff gewährt. Um diese Angriffe abzuwehren, sind eine ständige Überwachung und Aktualisierungen erforderlich, damit die Modelle angesichts sich weiterentwickelnder Angriffstechniken robust bleiben (MetaCompliance, 2025).
Voreingenommenheit in KI-Modellen
Eine weitere Sorge sind Verzerrungen innerhalb von KI-Modellen. Wenn die Trainingsdaten verzerrt sind oder bestimmte Vorurteile widerspiegeln, könnte das IDS bestimmte Gruppen, Arten von Aktivitäten oder Benutzerverhalten unfairerweise als verdächtig markieren. Dies kann nicht nur zu ethischen Problemen führen, sondern auch zu suboptimalen Sicherheitsergebnissen, da eine verzerrte Fokussierung dazu führen kann, dass das System umfassendere Bedrohungen übersieht (ISC², 2024). Die Identifizierung und Minderung von Verzerrungen ist daher entscheidend, um Fairness zu gewährleisten und die Integrität des Erkennungsprozesses aufrechtzuerhalten.
Herausforderungen in Bezug auf Regulierung und Compliance
Regulatorische und Compliance-Anforderungen führen zu einer weiteren Komplexitätsebene. Viele Branchen, darunter auch der maritime Sektor, müssen strenge Datenschutz- und Cybersicherheitsgesetze einhalten, um einen sicheren Umgang mit Nutzer-, Kunden- und Betriebsdaten zu gewährleisten. KI-gesteuerte Lösungen müssen klare Prüfpfade generieren und ausreichende Transparenz bieten, um die Compliance bei Audits nachzuweisen, was den Implementierungsprozess mit administrativen und technischen Aufwänden verbindet (Ethico, 2024). Die Einhaltung von Rahmenwerken wie dem NIST Cybersecurity Framework, ISO 27001 und den ENISA-Richtlinien ist entscheidend für die sichere und rechtmäßige Bereitstellung von KI-gestützten Cybersicherheitssystemen.
Hohe Implementierungs- und Wartungskosten
Auch die Kosten sind ein wichtiger Faktor. Die Anschaffungskosten für spezielle Hardware, Softwarelizenzen und professionelle Dienstleistungen können hoch sein, und die laufende Wartung, Aktualisierungen und das erneute Training der Modelle sind mit kontinuierlichen Ausgaben verbunden. Daher kann es für kleinere Organisationen schwierig sein, die langfristigen Investitionen zu rechtfertigen oder zu finanzieren, die für die Bereitstellung und Wartung von KI-gesteuerten Funktionen in großem Maßstab erforderlich sind (Modern Diplomacy, 2024).
Mangel an qualifizierten Fachkräften
Darüber hinaus besteht häufig eine spürbare Lücke beim erforderlichen Fachwissen für die Verwaltung KI-basierter Sicherheitssysteme. Für Unternehmen kann es schwierig sein, genügend Fachkräfte mit KI-Kenntnissen und Sicherheitserfahrung zu rekrutieren oder auszubilden. Um die Mitarbeiter über die sich schnell entwickelnden KI-Techniken und Cybersicherheitsbedrohungen auf dem Laufenden zu halten, sind kontinuierliche Weiterbildungs- und Schulungsprogramme erforderlich (Technology Magazine, 2024).
Datenschutzbedenken
Schließlich treten Datenschutzbedenken in den Vordergrund, wenn KI-gesteuerte IDS zur Überwachung des Benutzerverhaltens eingesetzt werden. Das Sammeln und Analysieren solcher detaillierten Informationen kann mit Datenschutzgesetzen in Konflikt geraten, wenn nicht sorgfältig damit umgegangen wird. Unternehmen müssen sicherstellen, dass Benutzerdaten so erfasst, gespeichert und verarbeitet werden, dass die Datenschutzrechte des Einzelnen gewahrt bleiben und Vorschriften wie die DSGVO eingehalten werden (Stewart, 2024). Um dieses Gleichgewicht zu erreichen, ist es erforderlich, die Zustimmung der Benutzer einzuholen, die Überwachungsrichtlinien klar zu formulieren und strenge Datenverwaltungspraktiken einzuhalten.
Durch die Bewältigung dieser Herausforderungen, von Datenqualität und Fehlalarmen bis hin zu Interpretierbarkeit, Kosten, Voreingenommenheit, Qualifikationslücken und Datenschutzbedenken, können Unternehmen das volle Potenzial KI-gesteuerter Lösungen ausschöpfen und gleichzeitig eine robuste Sicherheit und die Einhaltung gesetzlicher Vorschriften gewährleisten.
Zusammenfassend lässt sich sagen, dass KI die Cybersicherheit im Seeverkehr verändert, indem sie die Erkennung von Bedrohungen verbessert, Cyberangriffe verhindert und den Schiffsbetrieb optimiert. Durch maschinelles Lernen und Deep Learning helfen KI-gesteuerte Systeme wie IDS, IPS und DPI dabei, Sicherheitsrisiken in Echtzeit zu überwachen, zu analysieren und darauf zu reagieren. Predictive Analytics stärkt die Cyberabwehr zusätzlich, indem Schwachstellen identifiziert werden, bevor Angriffe stattfinden. Die Einführung von KI bringt jedoch auch Herausforderungen mit sich, darunter gegnerische Angriffe, Verzerrungen und Komplexitäten bei der Integration. Um die Widerstandsfähigkeit zu gewährleisten, sind kontinuierliche Fortschritte bei KI-Sicherheitsstrategien wie gegnerischem Training, verbesserter Einhaltung gesetzlicher Vorschriften und adaptiven Lernmodellen unerlässlich. Mit der Weiterentwicklung der Cyberbedrohungen wird KI eine immer wichtigere Rolle beim Schutz des Seeverkehrs spielen und gleichzeitig die betriebliche Effizienz und Sicherheit verbessern.