Poglavje 8 – Teorija
| Website: | CyberSEA training platform |
| Kurs: | CyberSEA Training Course - Slovenian |
| Buch: | Poglavje 8 – Teorija |
| Gedruckt von: | Guest user |
| Datum: | Sonntag, 22. November 2026, 00:07 |
Beschreibung
Nastajajoče tehnologije in prihodnji izzivi
1. Uvod
Prihodnost pomorske kibernetske varnosti je neločljivo povezana z nenehnim napredkom novih tehnologij in naraščajočo kompleksnostjo svetovnih ladijskih operacij. Ker se avtonomni sistemi in tehnologije naslednje generacije vse bolj integrirajo v pomorske operacije, se povečuje potencial za nova kibernetska tveganja. To poglavje preučuje nove tehnologije, ki preoblikujejo pomorski sektor, od avtonomnih procesov do vse večje vloge naprav interneta stvari (IoT) in uporabe umetne inteligence (UI) za kibernetsko varnost in napovedno analizo.
Začeli bomo z raziskovanjem tveganj, povezanih z avtomatizacijo in avtonomnimi procesi in analizirali morebitne ranljivosti, ki jih prinaša vse večja odvisnost od teh tehnologij. Poglavje se nato osredotoči na zagotavljanje tehnologij naslednje generacije v pomorskem sektorju, vključno s tem, kako naprave interneta stvari omogočajo inovacije in ustvarjajo nove točke napadov. Ogledali si bomo tudi, kako se umetna inteligenca uporablja za napovedno analizo in proaktivne ukrepe kibernetske varnosti.
To poglavje ponuja perspektivo o tem, kako lahko pomorski sektor zagotovi svojo prihodnost z obravnavo tveganj kibernetske varnosti, ki so neločljivo povezana s temi nastajajočimi tehnologijami, in se pripravi na izzive, ki so pred njim.
2. Avtonomni procesi in tveganja avtomatizacije
SS Ideal X je bila prva komercialna kontejnerska ladja. Iz tankerja za prevoz nafte iz obdobja druge svetovne vojne je bila preurejena v kontejnersko ladjo za panožno parniško družbo Pan-Atlantic. Ideal X je imela nosilnost 58 kontejnerjev. Njena kariera v pomorski logistiki se je končala leta 1965, ko je bila nekoč vodilna ladja novega pomorskega prometa poslana v razrez.
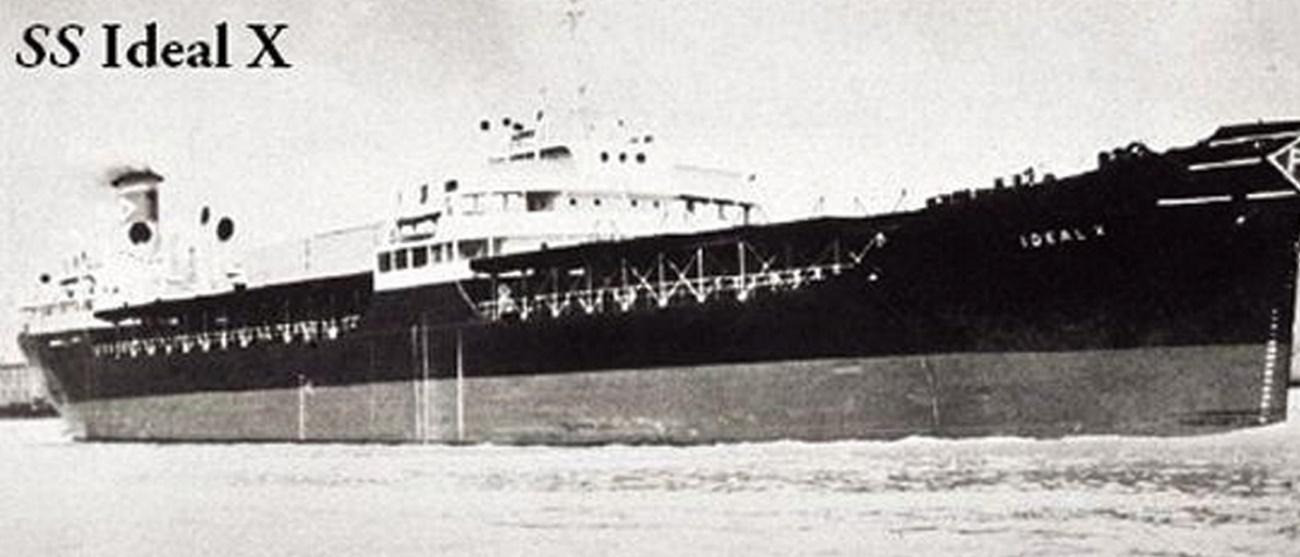
Slika 19: SS Ideal X
(Slika: Malcolm McLean, Panatlantic Steamship Company, 26. 4. 1956)
Na splošno velja, da je pretovor kontejnerjev od časov Ideal X doživel ogromne preobrazbe. Danes je največja kontejnerska ladja MSC Irina. Z dolžino trupa 399 metrov in širino 61,3 metra zagotavlja osupljivo kontejnersko kapaciteto 24346 TEU (Transport Equivalent Unit – enota ekvivalentna dvajsetim čevljem oz. 40m3).
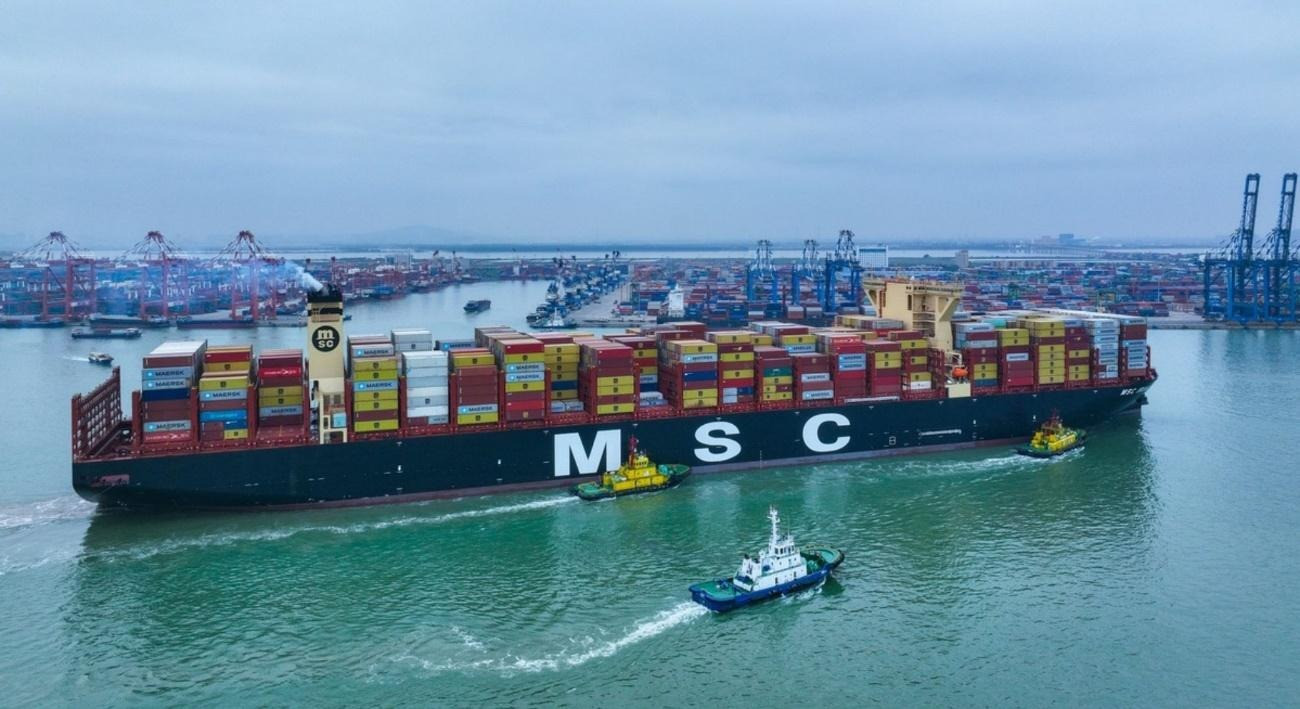
Slika 20: MSC Irina
(Slika: Orbits hub Technology Private Ltd., 2024)
Še danes zahteva po komercialnosti dviguje meje načrtovanja in operativna pričakovanja, postavljena za Ideal X in MSC Irina. Toda kombinacija pomanjkljivo preverjenih poslovnih primerov in novih načrtov je najhitrejša pot do poloma. Medtem ko se razprava vrti okoli možnosti avtonomnih plovil, se moramo spomniti, da je že človek pristal na Luni s pomočjo različnih oddaljenih kontrol vesoljskega poleta in pristajalnega modula. Le kratek čas med dejanskim pristankom na Luni je pristajalni modul upravljal izključno lokalno pilot, preostanek leta je izvedel navigacijski računalnik Apollo. Vodilni računalnik je imel vmesnike za navigacijo in nadzor vesoljskega plovila. Vse to je bilo zasnovano, uporabljeno in funkcionalno potrjeno leta 1966. Zato lahko upravičeno rečemo, da razlog za odsotnost avtonomnih plovil ni pomanjkanje tehnologije. Da bi se bolj poglobili v utemeljitev komercialnega primera avtonomnega plovila, moramo bolje razumeti s tem povezana tveganja.
Tveganje je verjetnost pomnožena s posledicami. Večja kot je verjetnost in hujše kot so posledice, večje je tveganje. Pri obvladovanju tveganj je temeljna ideja zmanjšati verjetnost ali zmanjšati resnost posledic. Ali pa seveda zmanjšati oboje. Tveganja se pojavljajo v številnih različnih oblikah in kategorijah. Spodaj je naštetih nekaj splošno prepoznanih tveganj v pomorstvu.
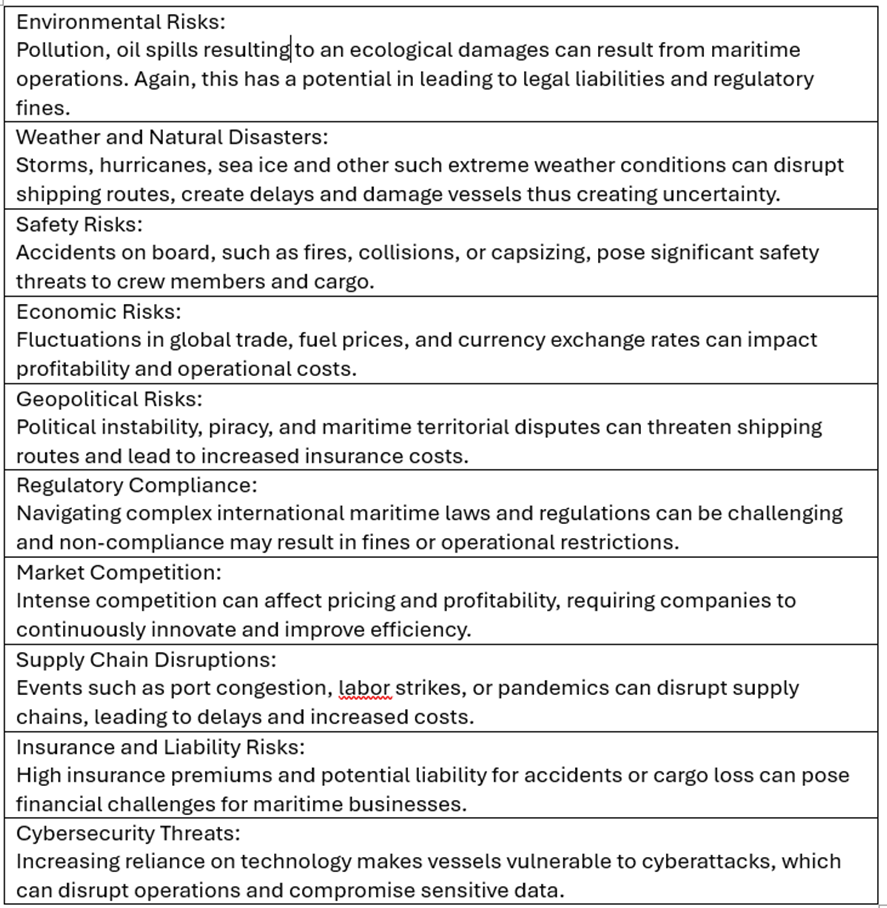
Slika 21: Seznam splošno prepoznanih tveganj v pomorskem okolju
(Lahtinen, 2025)
Za ublažitev teh tveganj so potrebne celovite strategije za obvladovanje tveganj, naložbe v tehnologijo in redno usposabljanje osebja. Na zgornjem seznamu tveganj je kibernetska varnost omenjena nazadnje. Zaradi odvisnosti od IT sistemov pri upravljanju pomorskih procesov je skoraj vse ranljivo za kibernetska tveganja. Motorji plovil so vklopljeni za spremljanje stanja v realnem času. Vremenski podatki temeljijo na vremenskih analizah, izboljšanih z umetno inteligenco in zbranih izkušnjah s preteklih poti. Navigacijski sistemi plovil se posodabljajo na spletu in temeljijo izključno na digitalno ustvarjenih in predstavljenih uporabniških vmesnikih. Dobavne verige se spremljajo in prilagajajo v realnem času z uporabo programske opreme za optimizacijo in umetne inteligence. Če bi že želeli škodovati dobavni verigi v ladijskem prometu, se zdi kibernetska varnost odlična možnost, saj so v današnjem sodobnem ladijskem prometu IT sistemi vključeni v vse procese. Namen škodovati ladijskemu prometu je pomemben dejavnik pri obvladovanju tveganj kibernetske varnosti iz očitnega razloga.
Pri obvladovanju tveganj operiramo z dvema izrazoma: varnost in zaščita. Varnost in zaščita se pogosto uporabljata kot sopomenki, vendar se nanašata na različna koncepta, zlasti v kontekstih, kot je pomorstvo.
Varnost se nanaša na zaščito ljudi, premoženja in okolja pred nenamernimi poškodbami ali škodo. Osredotoča se na preprečevanje nesreč in zmanjševanje tveganj, povezanih z delovanjem. Zajema ukrepe, sprejete za preprečevanje nesreč, kot so usposabljanje, vzdrževanje opreme, varnostni protokoli in skladnost s predpisi o zdravju in varnosti. Zagotoviti je potrebno, da so rešilni jopiči na voljo in v dobrem stanju, izvajati je treba redne varnostne vaje in izvajati postopke za preprečevanje zdrsov in padcev na plovilu.
Drugič, varnost vključuje zaščito ljudi, premoženja in informacij pred namernimi grožnjami ali zlonamernimi dejanji. Osredotoča se na preprečevanje namerne škode, kot so tatvina, sabotaža ali terorizem. Vključuje ukrepe za zaščito pred kriminalnimi dejavnostmi, nepooblaščenim dostopom in drugimi grožnjami, ki bi lahko ogrozile varnost ali premoženje. Uporaba sistemov za nadzor dostopa, izvajanje preverjanj preteklosti osebja in uporaba nadzornih kamer za spremljanje sumljivih dejavnosti so tudi del zagotavljanja varnosti.
Končno, varnost pomeni preprečevanje nenamerne škode, medtem ko je zaščita preprečevanje namerne škode. Oboje je ključnega pomena za celovito zaščito posameznikov in premoženja, zlasti v okoljih z visokim tveganjem, kot je pomorstvo. Lahko torej rečemo, da se varnost nanaša na notranje grožnje, medtem ko se zaščita nanaša na zunanje grožnje. Notranje grožnje lahko obvladujemo z lastnim vedenjem in na primer z usposabljanjem. Na zunanje grožnje se lahko le pripravimo.
Ker pomorstvo vse bolj sprejema avtonomne sisteme, so robustni ukrepi kibernetske varnosti bistveni za zaščito pred razvijajočimi se grožnjami, zagotavljanje varnega delovanja in ohranjanje integritete pomorskih dejavnosti. To zahteva proaktiven pristop, stalno spremljanje in sodelovanje v celotni panogi. Prehod na rastoče avtonomne sisteme lahko celo zmanjša kibernetska tveganja, saj se človeške interakcije, ki zavestno spodbujajo tveganja, zmanjšujejo.
3. Zagotavljanje tehnologij naslednje generacije
Pomorski avtonomni sistemi predstavljajo za svoje upravljavce različne varnostne izzive. Če je varnost plovila ali njegovih vitalnih sistemov ogrožena, se prej ali slej raven varnosti zmanjša. Od vsakega komercialnega plovila se pričakuje, da bo ohranilo operativnost v vseh predvidljivih pogojih, avtonomna plovila pa niso izjema od te filozofije. Na splošno velja, da je uvedba avtonomnih sistemov ugodna, ker, kot se domneva, avtonomni sistemi povečujejo varnost. Če se varnost resnično poveča, je operativna varnost pogoj za komercialni uspeh.
Avtonomni sistemi na krovu ali celo avtonomno plovilo se ne bi smeli razlikovati od običajnih sistemov na plovilih glede kibernetske varnosti. Prevladujoča tveganja so zelo enaka, vendar odsotnost človeških akterjev pri operativnem delu prenese velik del odgovornosti za obvladovanje tveganj na ramena sistemskih oblikovalcev. Pri avtonomnih sistemih se številne odločitve, ki narekujejo operativno varnost, sprejmejo v fazi načrtovanja sistemov.
Tveganja pri vključevanju najnovejših tehnologij v operacije, kritične za pomorsko varnost, so v nizki ravni izkušenj iz resničnega življenja. Modeliranje in testiranje sistemov za mizo sta nedvomno potrebna, vendar kompleksnost sistemov zahteva sistemsko-teoretični pristop, kjer se razume, da lahko sistem odpove, čeprav vse njegove posamezne komponente počnejo točno tisto, za kar so bile zasnovane. Gre za kontekstualnost. Bolj ko je sistem kompleksen, več možnih kontekstov obstaja, ko se na primer spremenijo okoljski pogoji. Vsaka komponenta v sistemu deluje glede na prevladujočo situacijo, kar ima za posledico scenarij, ki narekuje dejanje komponente poleg nje in nato pošlje ukaz za odziv aktivni komponenti v sistemu. Nenazadnje je število možnih izidov skoraj neomejeno. Ne glede na to, kako dobro je sistem zasnovan, lahko v kompleksnem okolju pravilno dejanje komponente privede do katastrofalnih posledic.
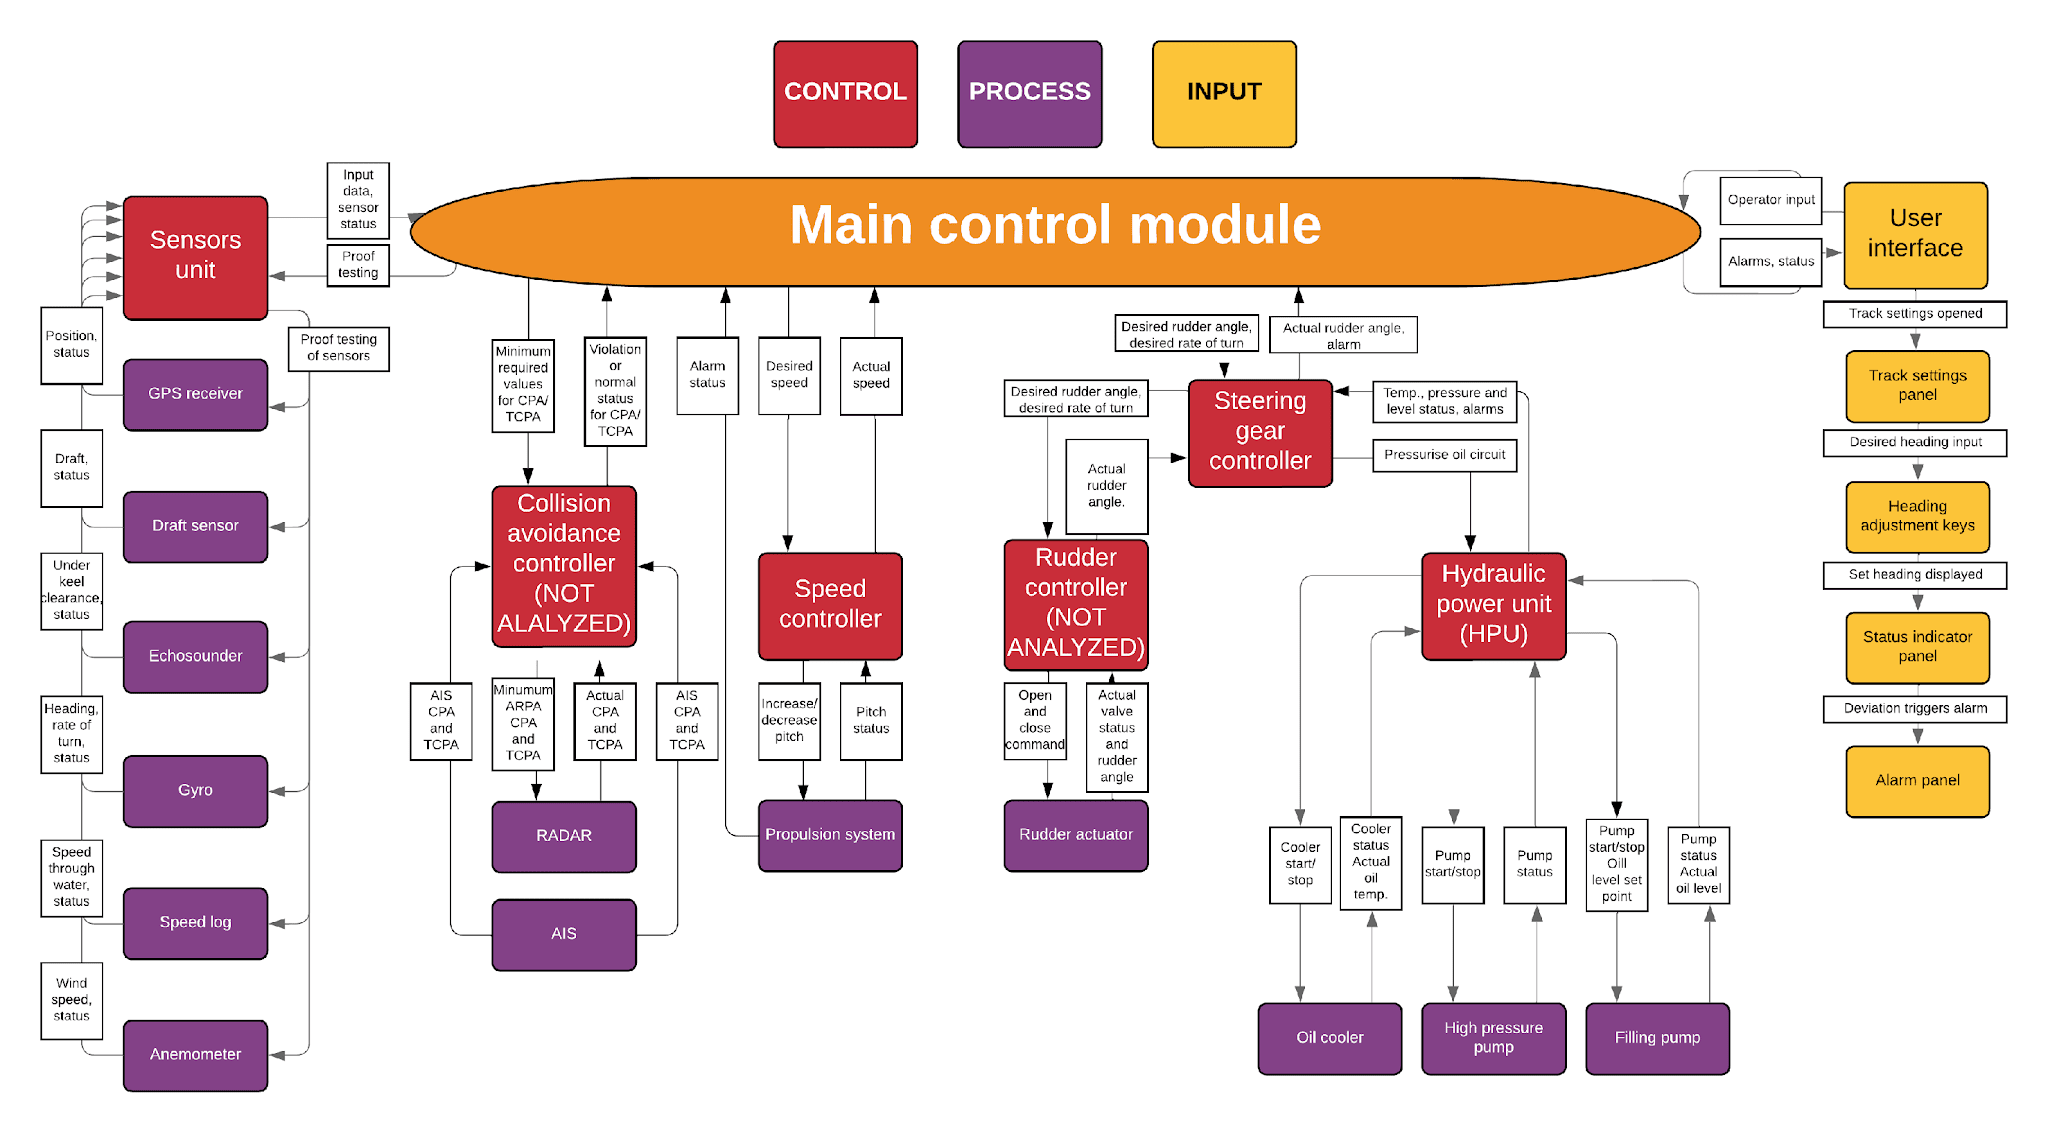
Slika 22: Avtonomni sistem za upravljanje mostu
(Lahtinnen, 2024)
Na zgornji ilustraciji vsak bel okvirček označuje podatkovno sporočilo, ki potuje znotraj sistema. Hkrati vsak bel okvirček predstavlja kibernetsko grožnjo, ko se podatki prenašajo med komponentami. Namerna motnja GPS-a je zdaj predmet številnih razprav. Ta izziv je primer situacije, ko ne moremo odstraniti temeljnega vzroka nevarnosti. Lahko le povečamo redundanco in poskrbimo, da se težave zavedamo takoj, ko se pojavi. Tudi ta tema ima pomembno težo pri obravnavanju tako avtonomnih kot tudi konvencionalnih plovil.
4. Internet stvari v ladijskem prometu: tveganja in varnostni ukrepi
Pomorska ladijska industrija hitro sprejema internet stvari za izboljšanje operativne učinkovitosti, zmanjšanje stroškov in povečanje varnosti. Naprave interneta stvari na plovilih in v pristaniških operacijah omogočajo zbiranje podatkov v realnem času za navigacijo, krmiljenje motorjev, sledenje tovora in dobro počutje posadke (Stellios et al., 2018). Vendar pa te prednosti spremljajo tudi pomembna tveganja in ranljivosti za kibernetsko varnost, ki jih je treba pravilno razumeti in obvladovati. V kontekstu ladijskega prometa se »tveganje« nanaša na vsak dogodek ali dejanje, ki bi lahko škodovalo delovanju, motilo integriteto sistema, ogrozilo osebje, ogrozilo tovor ali negativno vplivalo na okolje. Takšna tveganja vplivajo na različne deležnike, vključno z ladjarskimi družbami, člani posadke, pristaniškimi oblastmi in celo končnimi strankami. Glede na resnost in naravo grožnje se lahko posledice gibljejo od manjših operativnih nevšečnosti do obsežne okoljske škode in velikih finančnih izgub.
Ker imajo številne naprave interneta stvari omejene računalniške vire (Pereira et al., 2020), je lahko izvajanje robustnih varnostnih ukrepov zahtevno. Napadalci pogosto izkoristijo te omejitve za pridobitev nepooblaščenega dostopa ali povzročitev motenj, ki vodijo do zlorabe podatkov, nelegalne pridobitve lastniških informacij ali celo industrijskega vohunjenja. Slabosti skrite v eni sami napravi imajo lahko tudi kaskadni učinek, ogrozijo širše sisteme in spodkopavajo zaupanje v pomorske operacije. Za zaščito pred temi grožnjami je ključnega pomena obravnavati ranljivosti v vsaki funkcionalni domeni sistemov interneta stvari, hkrati pa upoštevati širše vidike kibernetske varnosti, ki se pojavljajo v celotni svetovni pomorski dobavni verigi.
Naprave interneta stvari običajno opravljajo štiri ključne funkcije – prenos podatkov, izvajanje krmilnih dejanj, zaznavanje ali spremljanje okolja ter obdelavo ali shranjevanje informacij. Vsaka vloga prinaša različne ranljivosti. V pomorskem okolju se te ranljivosti kažejo na treh glavnih področjih: tveganja obdelave/shranjevanja/prenosa podatkov, tveganja nadzora/aktiviranja in tveganja zaznavanja/spremljanja.
Tveganja pri prenosu podatkov
V pomorstvu se ladje pogosto zanašajo na satelitske, radijske ali druge brezžične povezave za izmenjavo kritičnih informacij, kot so navigacijske koordinate, podatki sistema samodejne identifikacije (AIS), vremenske napovedi in operativna komunikacija med ladjo in obalo. Če ti kanali niso zavarovani, jih je mogoče prestreči ali spremeniti, kot je prikazano v delu Balduzzi in sodelavci (2014), kjer so napadalci ponaredili signal »človek v vodi«. Napadi, kot sta prisluškovanje in manipulacija s »človekom vmes«, omogočajo nepooblaščenim osebam spremljanje ali spreminjanje navigacijskih podatkov, kar lahko vodi do napačnega usmerjanja, ponarejenih identitet plovil in poslabšanih varnostnih protokolov.
Če nepooblaščene osebe dobijo dostop do teh shramb podatkov, lahko pridobijo občutljive informacije o trgovskih poteh, pogodbah o prevozu in podrobnostih o skladnosti s predpisi ali pa spremenijo ključne operativne evidence (Nicaise, 2025). Slabo zavarovani šifrirni ključi in zastareli protokoli za varnostno kopiranje naredijo shrambe podatkov ranljive za zlorabe, brisanje ali napade izsiljevalske programske opreme, ki lahko ustavijo delovanje pristanišč in povzročijo resno finančno škodo in tudi škodo ugledu.
Poleg tega lahko napadi za zavrnitev storitve preobremenijo komunikacijske kanale, zaradi česar so v ključnih trenutkih neuporabni.
Tveganja nadzora/aktiviranja
Sodobna plovila vse pogosteje uporabljajo avtomatizacijo za upravljanje pogona, krmiljenja, balastnih sistemov, opreme za ravnanje s tovorom in drugih kritičnih procesov. Ti avtomatizirani sistemi pogosto sprejemajo oddaljene ukaze, kar omogoča učinkovito delovanje, hkrati pa odpirajo pot za zlonamerne posege, če so varnostni ukrepi šibki (Longo et al., 2024). Drugi primeri, npr. ogrožen sistem avtopilota lahko spremeni smer plovila, kar povzroči nasedanje ali trčenje, napadalec pa lahko onemogoči ključne varnostne mehanizme ali sabotira delovanje žerjavov v pristaniščih in povzroči motnje. Fizično poseganje v strojno opremo na krovu še poveča grožnje, saj lahko posameznik z neposrednim dostopom preglasi ali poškoduje kritične komponente, kar lahko ogrozi tako posadko kot strukturno celovitost plovila.
Zaznavanje/spremljanje tveganj
Širok nabor senzorjev zagotavlja informacije v realnem času o stanju in okolju ladje, vključno z integriteto trupa, delovanjem motorja, temperaturo tovora in atmosferskimi podatki. Če so ti senzorji ponarejeni ali spremenjeni, lahko upravljavci plovil dobijo napačne odčitke, kar lahko povzroči napačne navigacijske odločitve, slabo upravljanje tovora ali nepričakovane mehanske okvare. Napadi na senzorje, kot so radar, sonar ali AIS, lahko popačijo ali prikrijejo položaje in gibanje plovila, kar poveča tveganje trčenja (Jones, 2017). Poškodovani ali zakasnjeni podatki senzorjev lahko ovirajo tudi bistvene funkcije, kot so zaznavanje požara, nadzor okolja in načrtovanje vzdrževanja motorjev, s čimer ogrozijo varnost in skladnost s pomorskimi predpisi.
Varnostni ukrepi
Pomorsko kibernetsko varnost urejajo različni nacionalni in mednarodni standardi, vključno s smernicami Mednarodne pomorske organizacije (IMO). Organizacije lahko sprejmejo tudi okvire, kot sta okvir za kibernetsko varnost NIST ali ISO 27001. Skladnost je bistvena ne le za izogibanje pravnim kaznim, temveč tudi za vzpostavitev kulture varnosti, ki ustreza splošno priznanim najboljšim praksam.
1. Izolacija omrežja in arhitektura ničelnega zaupanja
Segmentacija kritičnih sistemov, kot so navigacijska in nadzorna omrežja, od nekritičnih sistemov, kot so internetne storitve za potnike, je bistvenega pomena za preprečevanje napada iz ozadja v primeru zlorabe. Razdelitev omrežja omogoča ustvarjanje izoliranih virtualnih omrežij za različne sisteme, kar zagotavlja varno komunikacijo med njimi brez motenj. Sprejetje načel ničelnega zaupanja to še izboljša, saj zahteva nenehno preverjanje pristnosti in spremljanje vsakega uporabnika, naprave in aplikacije. To zmanjšuje tveganje za nepooblaščen dostop in zagotavlja, da zaupanje ni samoumevno, niti za notranje naprave. Če je na primer naprava člana posadke ogrožena, ji bodo sistemi ničelnega zaupanja preprečili dostop do občutljivih navigacijskih podatkov ali kritičnih nadzornih sistemov.
2. Napredno zaznavanje in preprečevanje groženj
Zaznavanje kibernetskih groženj v realnem času je ključnega pomena za pomorske operacije. Sistemi za zaznavanje in preprečevanje vdorov (IDS/IPS) spremljajo omrežni promet, da bi prepoznali in blokirali nepooblaščene dejavnosti. Če napadalec na primer poskuša vdreti v nadzorni sistem ladje, lahko IDS/IPS zazna nenavaden vzorec prometa in samodejno ukrepa, da ga blokira. Globok pregled paketov (Deep Packet Inspection - DPI) analizira vsebino podatkovnih paketov med prenosom in prepozna skrito zlonamerno programsko opremo, sumljive ukaze ali nepooblaščene tokove podatkov. DPI je še posebej uporaben pri prepoznavanju groženj, ki se izognejo tradicionalnim požarnim zidovom tako, da se prikrijejo kot legitimen promet.
Požarni zidovi ostajajo temeljni ukrep za nadzor dohodnega in odhodnega prometa, vendar napredni požarni zidovi zdaj vključujejo strojno učenje za dinamično prilagajanje novim grožnjam, zaradi česar so učinkovitejši v pomorskih okoljih z nenehno spreminjajočimi se omrežji.
3. Virtualizacija in izolacija
Za zagotovitev izolacije in odpornosti sistema sta virtualizacija in izolacija ključnega pomena. Virtualizacija omogoča delovanje več virtualnih računalnikov na enem fizičnem strežniku, kar zagotavlja, da če je en sistem ogrožen, drugi ostanejo nespremenjeni. Podobno izolacija izolira posamezne aplikacije in preprečuje, da bi se medsebojno motile. Na primer, navigacijski sistem in sistem za sledenje tovora lahko delujeta v ločenih sektorjih strežnika, kar zmanjša tveganje, da napad na en sistem vpliva na drugega.
4. Napredne tehnike šifriranja
Zaščita občutljivih podatkov je ključnega pomena za pomorske operacije, še posebej ker sistemi interneta stvari ustvarjajo ogromne količine informacij. Homomorfno šifriranje omogoča obdelavo in analizo podatkov brez dešifriranja, kar zagotavlja, da občutljivi podatki ostanejo varni tudi med računanjem. To je še posebej uporabno za ladje, ki pošiljajo podatke v pristanišča ali nadzorne centre, saj odpravlja tveganje razkritja podatkov med obdelavo.
Nove tehnologije, kot je kvantno šifriranje, zlasti prek kvantne distribucije ključev (QKD - Quantum Key Distribution) (Scarani et al., 2009), uporabljajo načela kvantne mehanike, kot sta superpozicija in prepletenost, za ustvarjanje šifrirnih ključev, ki jih je praktično nemogoče dešifrirati.
5. Upravljanje identitete
Ključno je, da lahko do pomorskih sistemov interneta stvari dostopajo le pooblaščeni uporabniki in naprave. Napredni sistemi za upravljanje identitet uporabljajo večnivojsko avtentikacijo, biometrično preverjanje in nadzor dostopa na podlagi dodeljene vloge v podjetju, da lahko vzpostavijo visoko varnost. Član posadke bo na primer morda moral za dostop do kritičnih sistemov vnesti geslo in skenirati prstni odtis, medtem ko so njegove pravice dostopa omejene na specifične funkcije, povezane z njegovo vlogo. Tehnologija veriženja blokov lahko dodatno izboljša upravljanje identitet z ustvarjanjem decentraliziranega in pred posegi zaščitenega zapisa identitet, kar napadalcem otežuje ponarejanje gesel ali pridobitev nepooblaščenega dostopa.
6. Odziv na napade in redundanca
Tudi pri uporabi robustnih varnostnih ukrepov lahko pride do zlorabe, zato je načrtovanje odziva na napade bistvenega pomena. Vnaprej določene vloge, postopki stopnjevanja odziva in redne vaje zagotavljajo, da lahko ekipe hitro omejijo grožnje in zmanjšajo škodo. Če je na primer ogrožen sistem interneta stvari, ki nadzoruje spremljanje goriva, bi vnaprej določen načrt odziva vključeval izolacijo prizadetega sistema, opozarjanje ustreznih deležnikov in aktiviranje redundantnih sistemov za vzdrževanje delovanja.
7. Fizična varnost
Digitalni varnostni ukrepi so le tako močni kot fizična varnost, ki ščiti strojno opremo. Zavarovanje strežniških omar z zaklenjenimi ohišji, uporaba varnostnih pečatov na nadzornih ploščah in uporaba nadzornih sistemov zmanjšujejo tveganje za vdor na lokaciji. Napadalci, ki dobijo fizični dostop do kritičnih sistemov, lahko zaobidejo tudi najnaprednejše digitalne varnostne ukrepe s povezovanjem lažnih naprav ali neposrednim dostopom do občutljivih komponent.
8. Človeški dejavnik in usposabljanje
Močna strategija kibernetske varnosti se začne pri ljudeh. Člani posadke, pristaniški uradniki in vodstveno osebje se morajo redno usposabljati o novih grožnjah in vrstah napadov, kot so lažna e-poštna sporočila, lažne naprave USB ali socialni inženiring. Realistične simulacije, kot so lažni kibernetski napadi, pomagajo ozaveščati in pripravljati ekipe za učinkovit odziv na resnične napade. Jasne varnostne politike v kombinaciji s stalnim izobraževanjem znatno zmanjšujejo tveganje človeške napake, ki ostaja eden glavnih vzrokov za uspešne kibernetske napade.
Z izvajanjem teh ukrepov znatno izboljšamo varnost pomorskih sistemov in ustvarimo robustno obrambo pred kibernetskimi grožnjami. To ne le varuje občutljive podatke in kritične operacije, temveč zagotavlja tudi varnost članov posadke, plovil in tovora.
5. Umetna inteligenca za pomorsko kibernetsko varnost in napovedno analizo
Kibernetska varnost je postala ključnega pomena za zaščito vitalnih funkcij, kot so navigacija, upravljanje tovora in komunikacijska omrežja. Umetna inteligenca (UI) se je izkazala za močno orodje za reševanje teh varnostnih izzivov. Z analizo ogromnih količin podatkov lahko sistemi UI natančneje zaznajo grožnje, pospešijo odziv in ublažijo motnje v delovanju (Kaur et al., 2023). Ta dokument ponuja pregled UI, strojnega učenja (ML - Machine Learning) in globokega učenja (DL - Deep Learning), opisuje razvoj življenjskih ciklov modelov strojnega učenja in obravnava, kako lahko te tehnologije okrepijo pomorsko kibernetsko varnost in operativno učinkovitost.
Poleg zaznavanja napadov umetna inteligenca z analizo podatkov ladijskih senzorjev izboljša tudi delovanje plovil in energetsko učinkovitost, da bi predvidela morebitne mehanske okvare, še preden se zgodijo (Tu et al., 2018). Ta tehnika pomaga načrtovati popravila v stroškovno najbolj učinkovite časovnem okviru in preprečuje nepričakovane okvare. Poleg tega lahko umetna inteligenca dinamično spreminja hitrost in pot ladje glede na vremenske razmere, obremenitev tovora ali porabo goriva, kar na koncu zmanjša obratovalne stroške in vpliv na okolje.
Druga ključna aplikacija je vizualni nadzor, ki ga poganja umetna inteligenca, ki krepi pomorsko varnost s spremljanjem dejavnosti na krovu glede nepooblaščenega dostopa ali nenavadnega vedenja (Şengönül et al., 2023). Modeli globokega učenja, kot so konvolucijske nevronske mreže, lahko prepoznajo anomalije pri ravnanju s tovorom ali zaznajo, kdaj osebje vstopi v območja z omejenim dostopom. Robotski sistemi lahko na primer varno in učinkovito odstranijo blago iz zabojnikov, ki prispejo v naključnem vrstnem redu, kar zmanjša tveganja ročnega dela in izboljša operativno natančnost (Mojtahedzadeh et al., 2015).
Osnove umetne inteligence, strojnega učenja in globokega učenja
Umetna inteligenca je široko področje računalništva, osredotočeno na ustvarjanje sistemov, ki lahko opravljajo naloge, ki običajno zahtevajo človeško inteligenco, kot so razumevanje jezika, prepoznavanje vzorcev ali sprejemanje odločitev. Zgodnje raziskave umetne inteligence so se močno zanašale na tako imenovane sisteme, ki temeljijo na pravilih, kjer so strokovnjaki zapisali podrobne nabore navodil ČE-POTEM, kot je prikazano na sliki 23. Pravilo kibernetske varnosti bi lahko bilo naslednje: »ČE računalnik zabeleži več neuspešnih poskusov prijave, POTEM začasno blokiraj uporabnika.« Takšni sistemi dobro delujejo v situacijah, kjer je mogoče pravila jasno opredeliti, vendar se lahko soočajo z novimi ali nepričakovanimi težavami.
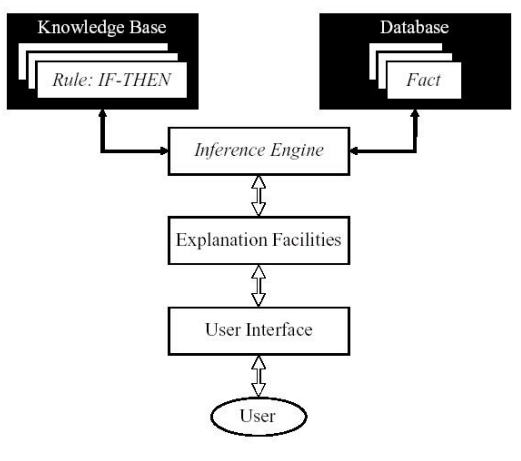
Slika 23: Struktura sistemov, ki temeljijo na pravilih umetne inteligence
(Mojtahedzadeh et al., 2015)
Sodobna umetna inteligenca se ne zanaša zgolj na ročno napisana pravila. Namesto tega uporablja tehnike, kot je strojno učenje, ki računalnikom omogočajo učenje iz podatkov, ne da bi bili izrecno programirani za vsak možen scenarij. Namesto da bi za vsako situacijo določali navodila, sistemu zagotavljamo ogromne količine informacij, kar mu omogoča analizo vzorcev in sprejemanje lastnih odločitev. Ta proces odraža, kako se ljudje učijo skozi izkušnje z opazovanjem številnih primerov, prepoznavanjem odnosov in postopnim izboljševanjem svojega razumevanja. V pomorskih operacijah lahko na primer strojno učenje analizira podatke iz sistemov za sledenje GPS, da zazna nenavadne premike plovil, ki lahko kažejo na nepooblaščen dostop ali grožnje piratstva. Z nenehnim učenjem iz podatkov o lokaciji v realnem času in preteklih napadov lahko umetna inteligenca prepozna odstopanja od običajnih poti ali vedenja ter sproži opozorila, preden se potencialna varnostna tveganja stopnjujejo. Sčasoma modeli strojnega učenja izpopolnijo svoje napovedi in se prilagodijo novim primerom, zaradi česar so učinkovitejši pri reševanju kompleksnih in razvijajočih se problemov, ne da bi za vsako odločitev potrebovali neposredno človeško posredovanje.
Znotraj strojnega učenja obstajajo različni načini učenja. Pri enem od pristopov, ki ga pogosto imenujemo nadzorovano učenje, se sistemu prikažejo primeri, ki že imajo odgovore ali oznake. Sčasoma ugotovi, kako so ti odgovori povezani z vsakim primerom, da lahko napove rezultate za nove, nevidne podatke. Glede na vrsto problema se lahko nadzorovano učenje uporabi za klasifikacijo, kjer je cilj dodeliti podatkovne točke določenim kategorijam, na primer za zaznavanje, ali je komunikacija plovila legitimna ali predstavlja potencialno kibernetsko grožnjo. Uporablja se lahko tudi za regresijo, kjer model napoveduje neprekinjene vrednosti, na primer ocenjevanje porabe goriva na podlagi hitrosti, teže tovora in vremenskih razmer.
Pri drugem pristopu, znanem kot nenadzorovano učenje, sistem deluje z informacijami, ki nimajo oznak, zato mora sam odkriti skrite vzorce, na primer združevanje podobnih elementov. To je uporabno v pomorski kibernetski varnosti pri analizi omrežnega prometa za odkrivanje anomalij, ki bi lahko kazale na kibernetske napade, saj lahko sistem združuje normalno in nenormalno vedenje brez predhodnega poznavanja videza napada.
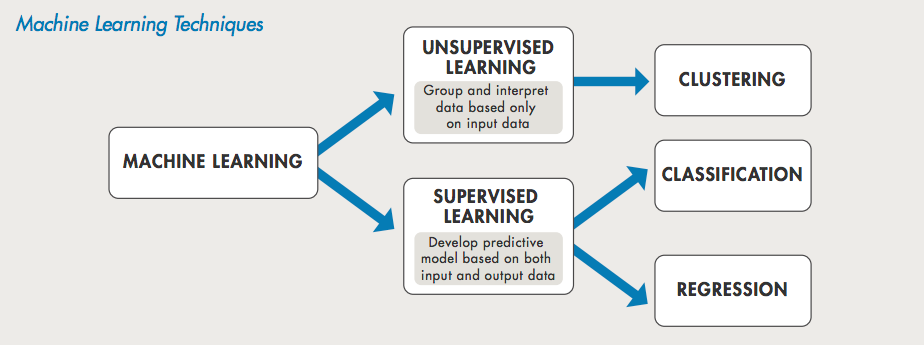
Slika 24: Tehnike strojnega učenja
Tretji pristop, imenovan učenje z okrepitvijo (RL - reinforcement learning), vključuje učenje s poskusi in napakami. Za razliko od nadzorovanega učenja, kjer sistemu damo označene primere pravilnih odgovorov, učenje z okrepitvijo deluje v okolju, kjer mora optimalno vedenje odkriti z interakcijo. Sistem, pogosto imenovan "agent", preizkuša različne frakcije v tem okolju in prejema povratne informacije v obliki nagrad ali kazni. Nagrada signalizira, da je bilo dejanje zaželeno, medtem ko kazen kaže na neželeno dejanje. Cilj agenta je naučiti se "politike", ki je preslikava iz stanj (trenutne situacije, v kateri se agent nahaja) v dejanja, kar sčasoma poveča njegovo kumulativno nagrado. Npr. pri robotskem krmiljenju se lahko RL uporabi za učenje hoje robota. Robot začne z naključnimi koraki in prejema povratne informacije na podlagi stabilnosti, energetske učinkovitosti in gibanja naprej. Skozi več iteracij se nauči prilagajati gibe sklepov, da bi hodil učinkoviteje, izboljšal ravnotežje in zmanjšal porabo energije (Song et al., 2021).
Globoko učenje umetno inteligenco popelje še korak dlje, saj poskuša posnemati način, kako človeški možgani obdelujejo informacije. V svojem bistvu uporablja umetne nevronske mreže, ki so strukturirane podobno kot biološki nevroni, za samodejno učenje in prepoznavanje vzorcev v ogromnih količinah podatkov. Za razliko od tradicionalnega strojnega učenja, kjer morajo ljudje pogosto ročno izbrati in definirati najpomembnejše značilnosti, da model deluje, modeli globokega učenja te značilnosti izluščijo sami in tako osmislijo surove podatke brez eksplicitnega programiranja. Sistem določi, kateri vidiki podatkov so najpomembnejši, kar mu omogoča prepoznavanje vzorcev in sprejemanje odločitev z minimalnim človeškim posredovanjem.
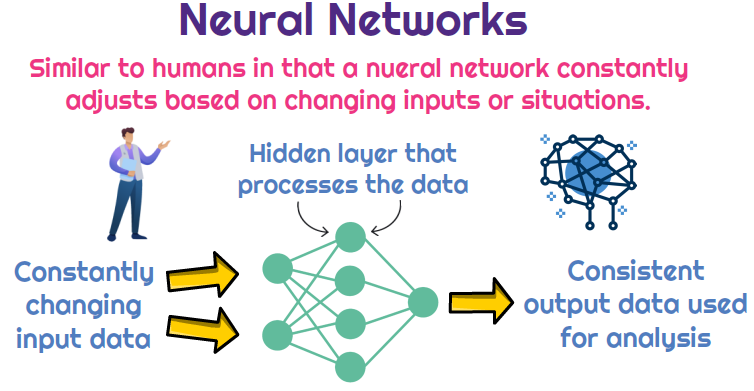
Slika 25: Prilagodljivi učni sistemi, ki obdelujejo spreminjajoče se vhodne podatke za ustvarjanje doslednih rezultatov za analizo .
Tako kot imajo človeški možgani specializirane regije za različne naloge, so modeli globokega učenja zasnovani z arhitekturami, ki se osredotočajo na specifične vrste podatkov. Pri obdelavi vizualnih informacij na primer vidna skorja možganov prepozna predmete z zaznavanjem robov, oblik in tekstur, preden oblikuje popolno sliko. Navdihnjene s tem so konvolucijske nevronske mreže (Convolutional Neural Networks - CNN) (Jorgecardete, 2025) zgrajene za obvladovanje nalog, povezanih z vidom, in samodejno učenje ustreznih značilnosti slik brez potrebe po ročnem vnosu. CNN se lahko na primer uporabljajo za prepoznavanje izrazov obraza z analizo podob obraza in prepoznavanjem čustev, kot so jeza, sreča ali presenečenje. Namesto da bi ljudje morali ročno opredeliti, kako je videti vsako čustvo, se model uči vzorcev s preučevanjem tisočih podob obraza. S konvolucijskimi in združevalnimi plastmi izlušči pomembne značilnosti, kot so gibi in izrazi obraznih mišic, ki jih nato obdelajo popolnoma povezane plasti in razvrstijo s funkcijo SoftMax za določitev najverjetnejšega čustva.
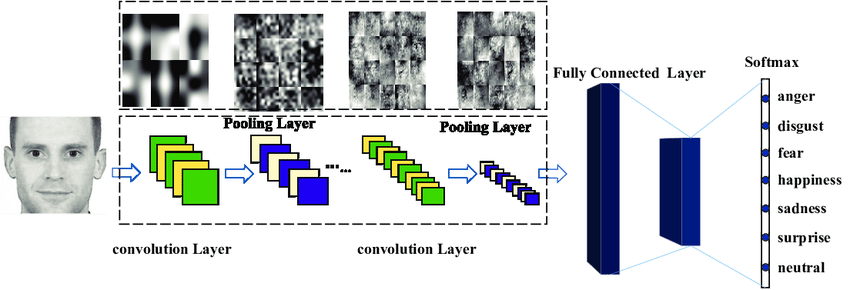
Slika 26: Shema prepoznavanja obraznih čustev na podlagi globokega učenja.
Spomin in obdelava zaporedij v človeških možganih igrata ključno vlogo tudi pri odločanju in prepoznavanju vzorcev, kjer pridejo v poštev modeli globokega učenja, kot so rekurentne nevronske mreže (Recurrent Neural Networks - RNN) in mreže dolgega kratkoročnega spomina (Long Short-Term Memory - LSTM). Ti modeli poskušajo posnemati način, kako si ljudje zapomnijo pretekle izkušnje in jih uporabljajo za vplivanje na sedanje odločitve. Še posebej učinkoviti so pri obdelavi zaporednih podatkov, kot so jezik, vrstno-časovne napovedi ali analiza omrežnega prometa.
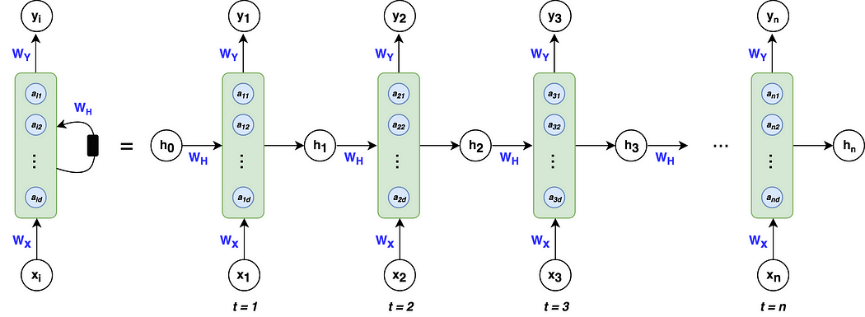
Slika 27: Arhitektura preproste rekurentne nevronske mreže
(Khuong, 2025)
Obdelava jezika je še eno področje, kjer se globoko učenje odlično obnese, saj posnema način, kako človeški možgani interpretirajo in ustvarjajo govor. Modeli, ki temeljijo na transformatorjih, kot sta BERT in GPT, analizirajo ogromne količine besedila in se učijo razumeti jezikovne vzorce, ne da bi za to potrebovali vnaprej določena slovnična pravila. V pomorski kibernetski varnosti lahko takšni modeli skenirajo e-pošto, radijske komunikacije in sistemske dnevnike, da bi odkrili poskuse lažnega predstavljanja, goljufiva sporočila ali nepooblaščena navodila, prikrita kot običajna komunikacija. Namesto da se zanašajo na preprosto zaznavanje ključnih besed, ti modeli razumejo kontekst in namen, zaradi česar so zelo učinkoviti pri označevanju subtilnih groženj, ki bi jih tradicionalni sistemi, ki temeljijo na pravilih, spregledali.
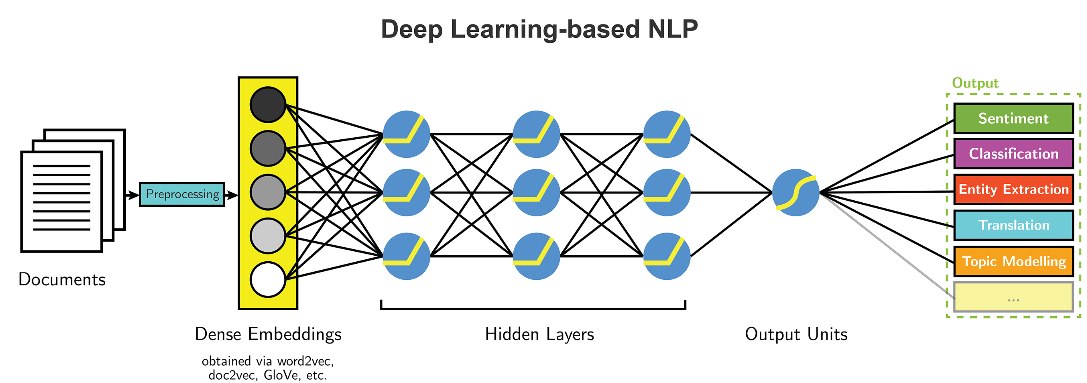
Slika 28: NLP (Natural language processing, obdelava naravnega jezika), ki temelji na globokem učenju .
Glavna moč globokega učenja je v njegovi sposobnosti samodejnega učenja ustreznih značilnosti iz ogromnih količin nestrukturiranih podatkov. Za razliko od tradicionalnih pristopov strojnega učenja, kjer morajo človeški strokovnjaki načrtovati značilnosti (tj. odločiti, kateri vidiki podatkov so pomembni), modeli globokega učenja blestijo pri samostojnem prepoznavanju teh značilnosti, kot je prikazano na sliki 29. Ne glede na to, ali podatki vsebujejo slike, omrežne dnevnike, odčitke senzorjev ali besedilo, sistem analizira številne primere, postopoma izboljšuje svoje razumevanje in samostojno prepoznava najbolj informativne vzorce. To odpravlja potrebo po ročnem inženiringu značilnosti, procesu, ki je lahko dolgotrajen, zahteva specializirano strokovno znanje na določenem področju in morda ne zajame vseh odtenkov, skritih v podatkih.
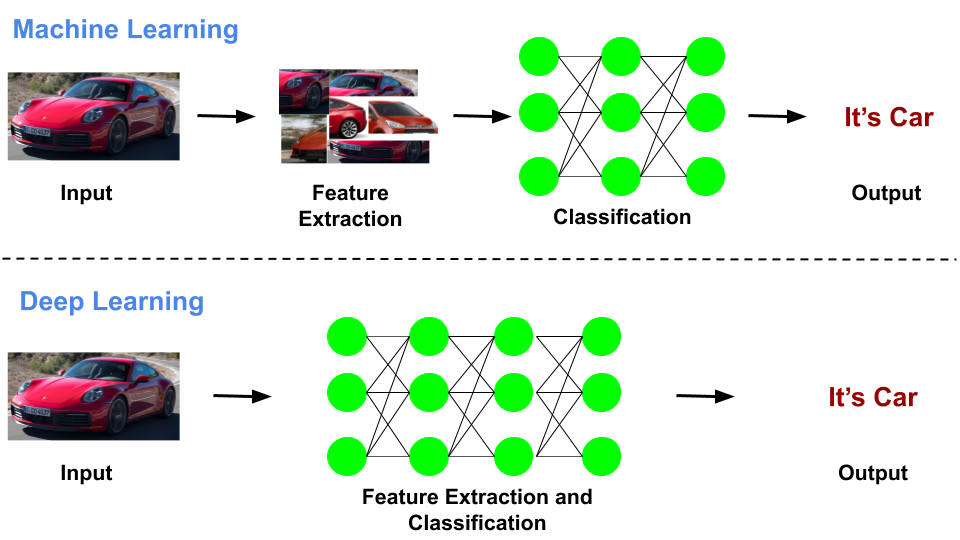
Slika 29: Shema razlik med strojnim in globokim učenjem .
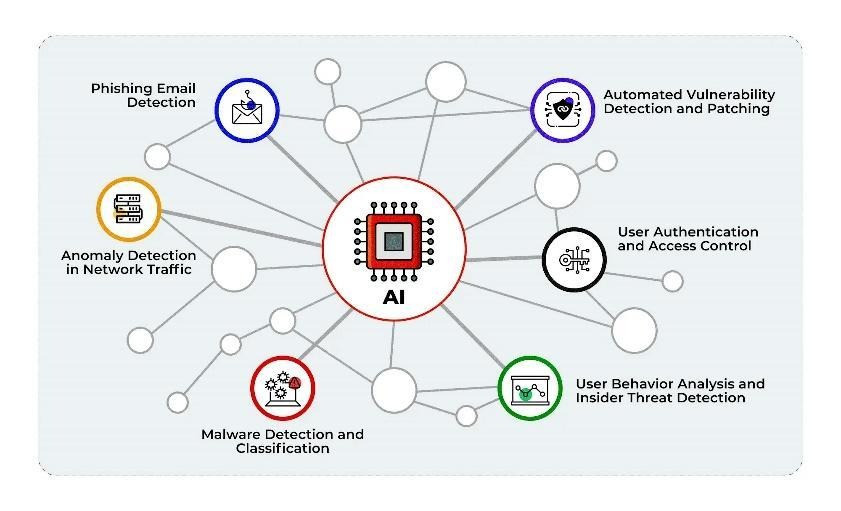
V pomorstvu je mogoče umetno inteligenco integrirati v sisteme kibernetske varnosti za obdelavo ogromnih količin podatkov, ki jih proizvajajo ladje, pristanišča in satelitske povezave. Z razvojem groženj se lahko modeli strojnega in globokega učenja z učenjem nenehno posodabljajo z uporabo novih informacij, s čimer odkrivajo tveganja ali napade, ki jih morda nikoli niso izrecno opisala pravila, ki jih je napisal človek. Ta sposobnost prilagajanja in izpopolnjevanja skozi čas je tisto, zaradi česar je umetna inteligenca tako dragocena za spopadanje s sodobnimi izzivi kibernetske varnosti. Slika 30 ponuja pregled aplikacij umetne inteligence v kibernetski varnosti na visoki ravni.
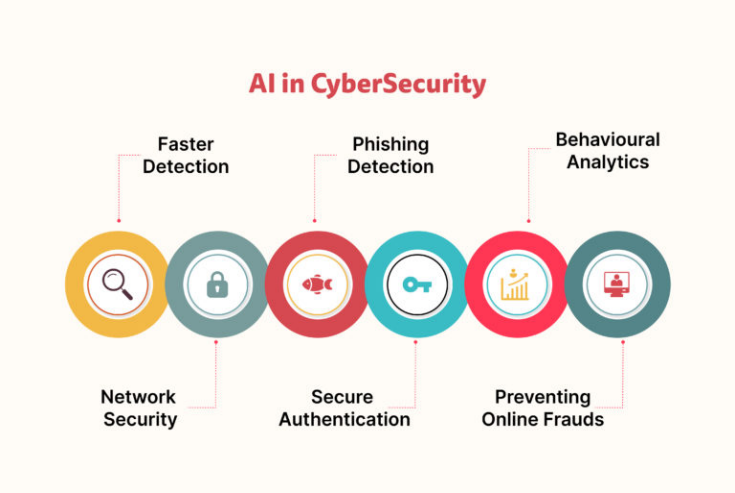
Slika 30: Uporaba umetne inteligence v kibernetski varnosti .
Razvoj modelov strojnega/globokega učenja
Postopek razvoja modela strojnega učenja ali globokega učenja sledi strukturiranemu nizu korakov, od pridobivanja podatkov do uvajanja in vzdrževanja modela. Vsak korak igra ključno vlogo pri zagotavljanju, da lahko sistem v resničnih okoljih daje natančne in zanesljive napovedi. Spodaj je podrobna razčlenitev celotnega procesa, skupaj z razlagami, ki bodo olajšale razumevanje tistim, ki tega področja ne poznajo.
Pridobivanje podatkov: Zbiranje ustreznih informacij
Prvi korak v katerem koli projektu strojnega učenja ali globokega učenja je pridobivanje podatkov. Brez visokokakovostnih podatkov bodo tudi najboljši algoritmi težko dosegli koristne rezultate. Podatki lahko prihajajo iz različnih virov, odvisno od problema. V primeru pomorske kibernetske varnosti lahko na primer ustrezni podatki vključujejo dnevnike omrežnega prometa, zapise varnostnih dogodkov in meritve delovanja sistema. Omrežni dnevniki zajemajo komunikacijo med napravami in pomagajo prepoznati nenavadne vzorce, ki lahko kažejo na kibernetske grožnje. Dnevniki varnostnih dogodkov vsebujejo opozorila, ki jih ustvarijo sistemi kibernetske varnosti, ko je zaznana sumljiva dejavnost. Podatki o delovanju sistema, kot sta poraba procesorja ali dejavnost pomnilnika, lahko zagotovijo vpogled v morebitne zlorabe ali napake v varnostnem sistemu. Vrsta zbranih podatkov je v celoti odvisna od specifične težave, ki jo model namerava rešiti. Za zaznavanje vdorov so morda potrebni omrežni podatki na ravni paketov, medtem ko bi bili za nadzor ladij bolj ustrezni video posnetki v realnem času.
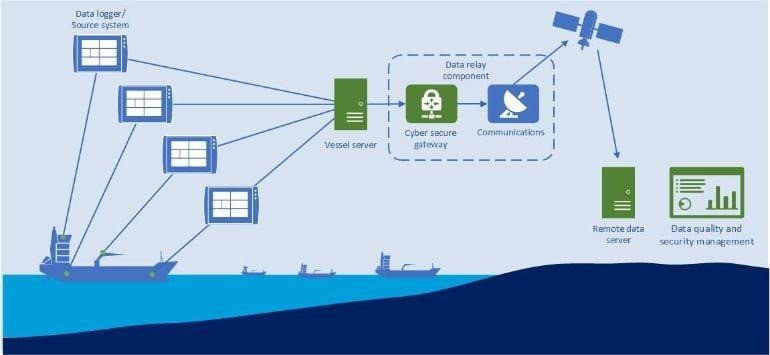
Slika 31: Primer pridobivanja podatkov v pomorstvu .
Priprava podatkov: Čiščenje in oblikovanje podatkov za analizo
Surovi podatki so pogosto nestrukturirani, nedosledni ali vsebujejo napake, ki lahko negativno vplivajo na delovanje modela. Da bi zagotovili uporabne podatke, morajo iti skozi fazo priprave. Ta postopek vključuje več ključnih korakov, vključno z obravnavo manjkajočih vrednosti, odstranjevanjem šuma in standardizacijo vhodnih podatkov. Manjkajoče vrednosti se lahko pojavijo zaradi okvarjenih senzorjev ali nepopolnih dnevnikov in jih je treba odpraviti tako, da jih zapolnimo z ocenjenimi vrednostmi ali zavržemo nepopolne zapise. Šum, kot so poškodovane podatkovne točke ali nepomembne informacije, je treba odstraniti, da se prepreči učenje napačnih vzorcev v modelu. Standardizacija je še en ključni korak, saj so podatki pogosto v različnih oblikah ali enotah. Na primer, časovne žige v omrežnih dnevnikih je morda treba pretvoriti v standarden časovni pas ali pa je treba številske vrednosti normalizirati, da se zagotovi, da so v primerljivem merilu. V strukturiranih naborih podatkov, kot so tabele omrežne aktivnosti, lahko ta faza vključuje tudi odstranjevanje podvojenih vnosov. Za nestrukturirane podatke, kot so slike ali besedilo, lahko predobdelava vključuje spreminjanje velikosti slik, zmanjšanje šuma v ozadju ali pretvorbo besed v številčne predstavitve, ki jih model lahko obdela.
Inženiring značilnosti: prepoznavanje ali ustvarjanje smiselnih vzorcev
V tradicionalnem strojnem učenju modeli sami po sebi ne razumejo, kateri vidiki podatkov so pomembni. Namesto tega morajo strokovnjaki ročno definirati značilnosti, ki so najbolj uporabne za rešitev problema. Ta postopek, znan kot inženiring značilnosti, vključuje izbiro, preoblikovanje ali ustvarjanje novih spremenljivk iz surovih podatkov za izboljšanje delovanja modela. Učinkovito inženirstvo značilnosti lahko znatno izboljša natančnost modela, saj mu zagotovi smiselne informacije. Npr. v sistemu za zaznavanje vdorov lahko surovi dnevniki omrežnega prometa vsebujejo podrobnosti, kot so naslovi IP, časovni žigi, velikosti paketov in stanja povezav. Vendar pa te surove vrednosti same po sebi morda niso dovolj informativne za model. Za izboljšanje zaznavanja lahko strokovnjak ustvari nove značilnosti na podlagi statističnih vzorcev ali vedenjskih trendov. Ena takšnih značilnosti je lahko stopnja poskusov povezave, kjer se število zahtev za povezavo z določenega naslova IP meri v danem časovnem oknu, na primer 10 sekund. Nenaden porast poskusov povezave lahko kaže na napad s surovo silo.
Globoko učenje pa odpravlja veliko potrebo po inženiringu značilnosti. Namesto da bi se za definiranje pomembnih značilnosti zanašale na človeško intuicijo, se globoke nevronske mreže samodejno učijo vzorcev neposredno iz surovih podatkov. To je ena glavnih prednosti globokega učenja pred tradicionalnim strojnim učenjem. Lahko obdeluje nestrukturirane podatke, kot so slike, zvok in besedilo, ne da bi zahtevala eksplicitna pravila za ekstrakcijo značilnosti. Npr. pri prepoznavanju slik se lahko konvolucijska nevronska mreža nauči zaznavati robove, teksture in kompleksne predmete brez človeškega posredovanja, zaradi česar je zelo učinkovita za aplikacije, kot je analiza posnetkov nadzora v realnem času na ladjah.
Izbira modela: Izbira pravega algoritma
Ko so podatki pripravljeni, je naslednji korak izbira najboljšega modela za reševanje problema. Izbira algoritma je odvisna od dejavnikov kot so vrsta podatkov, kompleksnost naloge in razpoložljivi računalniški viri. V tradicionalnem strojnem učenju se pogosto uporabljajo modeli, kot so »odločitvena drevesa«, metoda podpornih vektorjev (support vector machines - SVM) ali »naključni gozdovi«, zlasti pri delu s strukturiranimi nabori podatkov. Ti modeli zahtevajo ročno definirane funkcije, vendar lahko dobro delujejo z relativno majhnimi nabori podatkov.
Modeli globokega učenja pa so zmogljivejši, vendar zahtevajo velike količine podatkov in računalniških virov. CNN so še posebej učinkovite za naloge, povezane s slikami, kot je zaznavanje predmetov v posnetkih pomorskega nadzora. Rekurentne nevronske mreže ali transformatorji so bolj primerni za zaporedne podatke, kot je analiza komunikacijskih dnevnikov skozi čas za odkrivanje vzorcev kibernetskih groženj. Izbira pravega modela je ključni korak, saj lahko napačna izbira povzroči slabo delovanje ali neučinkovito računanje.
Usposabljanje modela: Učenje iz podatkov
Po izbiri modela je naslednji korak njegovo učenje za napovedovanje. Usposabljanje vključuje vnašanje podatkov v model, kar mu omogoča učenje vzorcev in prilagajanje njegovih notranjih parametrov za izboljšanje natančnosti. Model naredi začetne napovedi, funkcija izgub pa meri, kako daleč so te napovedi od pravilnih odgovorov. Če je izguba velika, to pomeni, da model daje slabe napovedi. Za izboljšanje se s procesom optimizacije, kot je gradientni spust, posodobijo parametri modela (znani kot uteži), da se postopoma zmanjša izguba. Ta iterativni proces se nadaljuje, dokler model ne doseže sprejemljive ravni natančnosti.
Pri nadzorovanem učenju se model uči na označenih podatkih, kar pomeni, da ima vsak vhod znan pravilen izhod (npr. oznake razredov v klasifikaciji ali ciljne vrednosti v regresiji). Cilj je zmanjšati razliko med napovedmi in resničnimi oznakami, običajno z uporabo funkcij izgub, kot sta navzkrižna entropija (za klasifikacijo) ali povprečna kvadratna napaka (za regresijo).
Pri globokem učenju je ta proces računsko intenziven in zahteva velike nabore podatkov. Za razliko od tradicionalnega strojnega učenja, kjer je učenje lahko končano v nekaj minutah ali urah, lahko učenje globokih nevronskih mrež traja več dni ali celo tednov, odvisno od kompleksnosti arhitekture in velikosti podatkov. Za obvladovanje te kompleksnosti ogrodja za globoko učenje, kot sta TensorFlow in PyTorch, zagotavljajo učinkovita orodja za gradnjo modelov, samodejno diferenciacijo in strojno pospeševanje. Te knjižnice podpirajo dinamične računske grafe in ponujajo široko paleto vnaprej izdelanih funkcij za optimizacijo modelov. Uglaševanje hiperparametrov, prilagajanje parametrov, kot so hitrost učenja, velikost serije in število učnih dob, je bistveno za zagotovitev učinkovite konvergence modela.
Pri nenadzorovanem učenju se model uči na neoznačenih podatkih, kar pomeni, da nima vnaprej določenih kategorij ali pravilnih odgovorov. Namesto napovedovanja določenih izhodov model identificira vzorce, strukture ali skupine v podatkih.
Algoritmi grupirajo podobne podatkovne točke na podlagi razdalje med njimi.
Tehnike zmanjševanja dimenzionalnosti lahko stisnejo visoko dimenzionalne podatke v nižje dimenzionalno obliko, pri tem pa ohranijo bistvene informacije.
Generativni modeli se naučijo ustvarjati nove vzorce podatkov, ki so podobni učnim primerom.
Ker nobena posebna funkcija ne primerja napovedi z resničnim stanjem, učenje pogosto vključuje nenadzorovane cilje, kot sta zmanjšanje napake pri rekonstrukciji podatkov ali maksimiranje variance med skupinami.
Validacija in testiranje modela: ocenjevanje učinkovitosti delovanja
Ko je učenje končano, je bistveno preizkusiti, kako dobro se model prenaša na nove, nevidne podatke. To se doseže z validacijo in testiranjem z uporabo ločenih naborov podatkov, ki niso bili del procesa učenja. Če model med učenjem deluje dobro, vendar ne daje natančnih napovedi na podlagi novih podatkov, je verjetno preveč prilagojen, kar pomeni, da se je naučil vzorcev, ki so preveč specifični za učni nabor in se ne posplošuje dobro na nevidne podatke. Za oceno učinkovitosti modela se uporabljajo metrike delovanja, kot so natančnost, preciznost, odpoklic in F1-rezultat. Natančnost meri delež pravilnih napovedi, medtem ko natančnost in odpoklic zagotavljata vpogled v zanesljivost modela pri zaznavanju določenih kategorij, kot so kibernetske grožnje. F1-rezultat uravnoteži natančnost in odpoklic ter ponuja celovitejšo oceno. Če je delovanje modela nezadovoljivo, je mogoče prilagoditve izvesti z zbiranjem več podatkov, izboljšanjem izbire značilnosti (v strojnem učenju) ali natančnim uglaševanjem hiperparametrov.
Uvajanje in neprekinjeno spremljanje: uporaba modela v resničnem svetu
Ko model doseže zadovoljivo natančnost in robustnost, se ga uvede v realno okolje, kjer začne napovedovati podatke v živo. Vendar pa uvedba ni zadnji korak. Za zagotovitev nadaljnjega delovanja sta potrebna stalno spremljanje in vzdrževanje. Npr. v pomorski kibernetski varnosti se nenehno pojavljajo nove kibernetske grožnje, model, usposobljen na preteklih vzorcih napadov, pa lahko sčasoma zastari. Da bi preprečili poslabšanje delovanja, je treba modele redno ponovno usposabljati na posodobljenih podatkih, nenehno spremljati napake in izboljševati, da se prilagodijo spreminjajočim se pogojem. Če tega ne storite, lahko to privede do zastarelih napovedi, varnostnih ranljivosti ali zmanjšane natančnosti.
Slika 32 prikazuje splošen pregled učnega procesa za model nadzorovanega strojnega učenja.
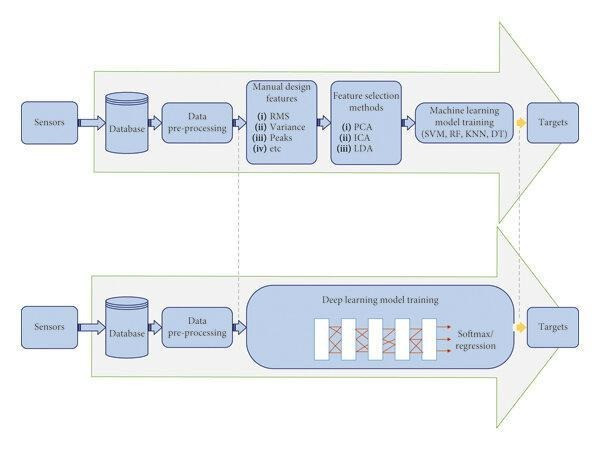
Slika 32: Pregled učnih shem za modele ML/DL .
Uporaba umetne inteligence v pomorski kibernetski varnosti
Sistemi za zaznavanje vdorov (IDS)
Sistem za zaznavanje vdorov (Intrusion Detection System - IDS) je varnostna rešitev, zasnovana za zaznavanje nepooblaščenega dostopa, zlonamernih dejavnosti in potencialnih groženj z nenehnim spremljanjem omrežnega prometa, vedenja uporabnikov in sistemskih dnevnikov. Namestitev IDS-ja je odvisna od njegove vrste. Omrežni IDS (Network-Based IDS - NIDS) je običajno nameščen med požarnim zidom in notranjim omrežjem, kot je prikazano na sliki 33 , kjer pregleda ves dohodni in odhodni promet in išče sumljive vzorce, preden dosežejo kritične sisteme. Če napadalec zaobide požarni zid, IDS zazna anomalije in ustvari opozorilo za nadaljnjo preiskavo. Po drugi strani pa je gostiteljski IDS (Host-Based IDS - HIDS) nameščen neposredno na posameznih napravah, kot so navigacijski sistem ladje, strežniki ali delovne postaje, kjer spremlja sistemske dnevnike, celovitost datotek in dejavnost uporabnikov, da odkrije zlonamerne spremembe. V pomorskem kontekstu imajo IDSi ključno vlogo pri zaščiti kritičnih operacij, kot so upravljanje tovora, navigacija in komunikacijska omrežja (MarPoint, 2025).
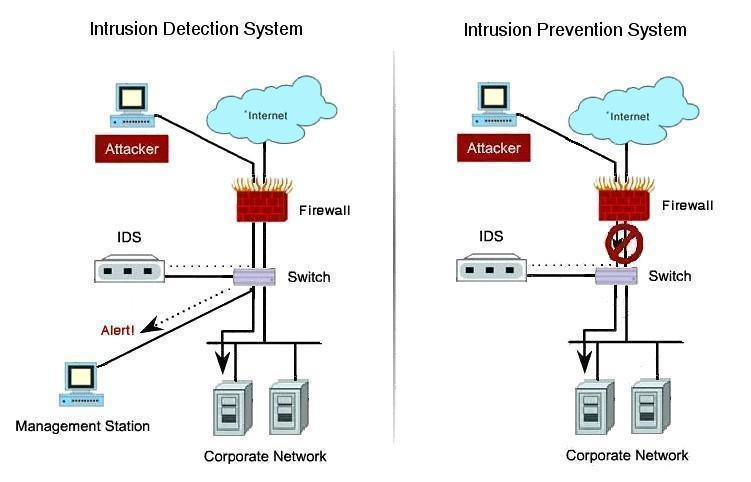
Slika 33: Sistem za zaznavanje vdorov
DS uporablja dva glavna pristopa za odkrivanje zlonamernega vedenja:
Odkrivanje na podlagi značilnosti napada (Signature-based Detection): Primerja opazovane dejavnosti z bazo podatkov značilnosti znanih napadov z uporabo tehnik ujemanja nizov. Ta metoda je zelo učinkovita za prepoznavanje že znanih napadov, vendar ne zazna novih ali razvijajočih se napadov.
Odkrivanje na podlagi vedenja (Behavior-based Detection): Spremlja odstopanja od običajnih vzorcev aktivnosti, kar omogoča prepoznavanje novih ali neznanih groženj. Čeprav je ta metoda bolj prilagodljiva, lahko ustvari več lažno pozitivnih rezultatov.
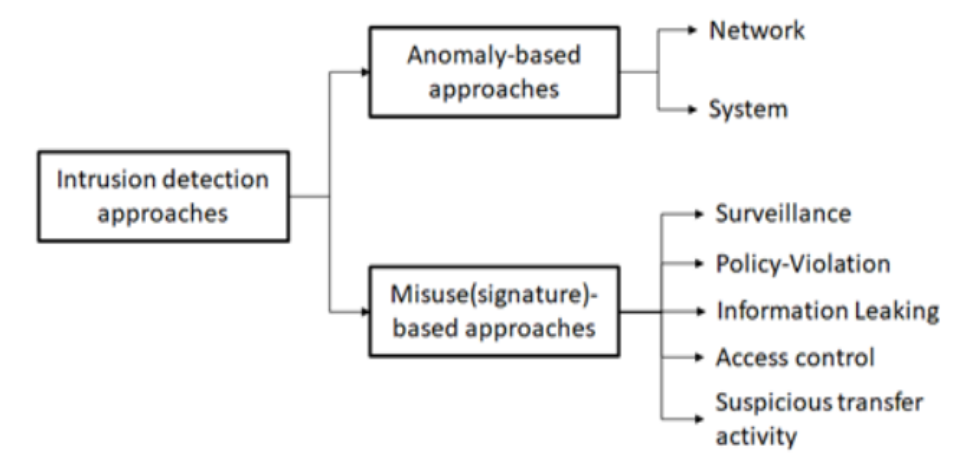
Slika 34: Klasifikacija pristopov za zaznavanje vdorov .
Sistemi za odkrivanje vdorov, ki jih poganja umetna inteligenca, izboljšujejo varnost z analizo podatkov v realnem času, prepoznavanjem anomalij in razlikovanjem tipičnih omrežnih vzorcev od škodljivih vdorov. Z integracijo nadzorovanih metod, ki se zanašajo na značilnosti znanih napadov, in nenadzorovanih metod, ki zaznavajo nenavadna odstopanja od običajne aktivnosti, sistemi za odkrivanje vdorov, ki temeljijo na umetni inteligenci, zmanjšujejo lažne alarme in izboljšujejo natančnost odkrivanja kibernetskih napadov.
Sistemi za odkrivanje groženj, ki jih poganja umetna inteligenca, uporabljajo algoritme strojnega učenja za natančnejše zaznavanje groženj. Ti algoritmi pomagajo sistemom za odkrivanje groženj prepoznati tako znane kot neznane kibernetske napade.
- Nadzorovano učenje: Ta pristop usposablja model umetne inteligence z uporabo podatkov o preteklih napadih, označenih kot "varni" ali "nevarni". Umetna inteligenca se uči iz teh podatkov in nato uporabi svoje znanje za odkrivanje novih groženj.
- Nenadzorovano učenje: Za razliko od nadzorovanega učenja ta metoda ne zahteva označenih podatkov. Namesto tega umetna inteligenca prepozna nenavadne dejavnosti z zaznavanjem vzorcev, ki se ne ujemajo z običajnim vedenjem.
Pogosta težava tradicionalnih sistemov za odkrivanje vdorov so lažno pozitivni rezultati, pri katerih se neškodljiva omrežna aktivnost pomotoma označi kot grožnja. Umetna inteligenca zmanjšuje lažne alarme z učenjem iz prejšnjih napak in sčasoma izboljšuje njihovo natančnost. Umetna inteligenca lahko kombinira tudi več metod zaznavanja za izboljšanje rezultatov. Z združevanjem zaznavanja na podlagi značilnosti napadov in vedenja sistemi za odkrivanje vdorov, ki jih poganja umetna inteligenca, zmanjšujejo napake, hkrati pa ohranjajo močno varnost. Nekateri modeli umetne inteligence celo uporabljajo učenje z okrepitvijo, tehniko, pri kateri umetna inteligenca nenehno prilagaja svoja pravila zaznavanja na podlagi povratnih informacij.
Ker je IDS pasiven sistem, ne ukrepa neposredno proti zaznanim grožnjam. Namesto tega ustvarja opozorila za človeške operaterje ali se integrira s sistemi za upravljanje varnostnih informacij in dogodkov (SIEM) za nadaljnjo analizo in odziv. Vdori lahko izvirajo tako iz zunanjih kot notranjih virov, zaradi česar je IDS bistvena komponenta strategij kibernetske varnosti v vseh panogah.
Sistemi za preprečevanje vdorov (IPS)
Sistem za preprečevanje vdorov (Intrusion Prevention System - IPS) je varnostna tehnologija, zasnovana za odkrivanje in proaktivno preprečevanje zlonamernih dejavnosti v omrežju ali sistemu. Za razliko od sistema za preprečevanje vdorov (IDS), ki pasivno spremlja in opozarja na sumljive dejavnosti, IPS neposredno ukrepa, da bi blokiral, ublažil ali zaustavil napad v realnem času. V bistvu je IDS orodje za spremljanje, medtem ko IPS deluje kot nadzorni sistem, ki aktivno preprečuje grožnje, preden povzročijo škodo pri operacijah, kot so navigacija, ravnanje s tovorom ali komunikacijske povezave (Sowmya in Anita, 2023).
IPS se običajno namesti za požarnim zidom, vendar pred notranjimi sistemi, kar mu omogoča pregled vhodnega in odhodnega prometa, kot je prikazano na sliki 35. Za razliko od požarnega zidu, ki filtrira predvsem na podlagi vnaprej določenih pravil, IPS uporablja napredno analitiko za odkrivanje in blokiranje dinamičnih groženj v realnem času. V nekaterih omrežnih arhitekturah IPS deluje skupaj z IDS, kjer IDS zazna in opozori skrbnike, medtem ko IPS aktivno ukrepa za nevtralizacijo groženj.
Slika 35: Sistem za preprečevanje vdorov
Ključna dejanja, ki jih izvaja IPS:
- pošiljanje opozoril skrbnikom,
- odstranjuje potencialno škodljive pakete,
- blokira povezave iz zlonamernih virov,
- ponovno zažene napadene povezave, da prepreči nadaljnje izkoriščanje vira podatkov,
- IPS uporablja umetno inteligenco za izboljšano varnost.
Sodobne rešitve IPS izkoriščajo analitiko, ki jo poganja umetna inteligenca, in vire podatkov v realnem času za učinkovitejše odkrivanje in blokiranje groženj. Z nenehnim učenjem iz zgodovinskih in nastajajočih vzorcev napadov ti sistemi izboljšujejo svojo natančnost in zmanjšujejo število lažno pozitivnih rezultatov. Z integracijo analitike, ki jo poganja umetna inteligenca, z viri podatkov v realnem času sodobni IPS izboljšujejo varnost z izolacijo okuženih končnih točk, blokiranjem zlonamernih naslovov IP in dinamičnim spreminjanjem pravil požarnega zidu, da preprečijo širjenje groženj iz ozadja po ladijskih in pristaniških omrežjih (Maritime Intelligence, 2025). Pomemben primer tega je Ciscova implementacija omrežnega IPS, ki je učinkovito zaznal in ublažil notranje omrežne grožnje, preden bi lahko povzročile izgubo podatkov ali motnje v storitvah. Z analizo vhodnega in odhodnega prometa znotraj podjetja je Ciscov IPS zagotovil ključno plast obrambe, ki je dokazala učinkovitost IPS, izboljšanega z umetno inteligenco, pri proaktivnem nevtraliziranju kibernetskih groženj, preden so se imele možnost stopnjevati (Contentree, 2025).
Odprtokodni sistemi za zaznavanje in preprečevanje vdorov
Ker se kibernetske grožnje nenehno razvijajo, sta odprtokodna sistema za odkrivanje in preprečevanje groženj (IDS) in sistem za zaščito pred grožnjami (IPS) postala bistveni orodji za spremljanje in zavarovanje omrežij. Dve najpogosteje uporabljeni rešitvi IDS/IPS z odprto kodo sta Snort in Suricata, ki obe zagotavljata zaznavanje in preprečevanje groženj v realnem času, hkrati pa sta prilagodljivi in jih lahko oblikujemo glede na lastne potrebe.
Snort: IDS/IPS, ki temelji na pravilih
Snort, ki ga je leta 1998 prvotno razvil Martin Roesch, je IDS/IPS, ki temelji na značilnostih preteklih napadov in je sposoben izvajati analizo prometa v realnem času ter beležiti pakete v omrežjih IP. Uporablja jezik, ki temelji na pravilih, kar mu omogoča integracijo tehnik zaznavanja na podlagi znanih značilnosti, protokolov in anomalij za prepoznavanje širokega nabora kibernetskih groženj, vključno z napadi za zavrnitev storitve (DoS), prelivanjem medpomnilnika, prikritimi pregledi omrežnih vrat in napadi CGI (Common Gateway Interface).
Snort deluje tako, da pregleda omrežne pakete z uporabo knjižnic, kot sta libpcap in WinPcap, in lahko deluje v treh glavnih načinih:
- Način pregleda paketov – zajame in spremlja surov omrežni promet.
- Način beleženja paketov – beleži omrežne pakete za analizo in odpravljanje napak.
- Način zaznavanja vdorov – primerja omrežno aktivnost z vnaprej določenimi pravili in pošilja opozorila, ko so zaznane grožnje.
Ključna prednost Snorta je njegov prilagodljiv jezik pravil, ki uporabnikom omogoča določanje varnostnih pravilnikov po meri. Dobro se integrira s požarnimi zidovi in zagotavlja dodatno plast obrambe, zaradi česar je dragoceno orodje za nadzor notranjega omrežja.
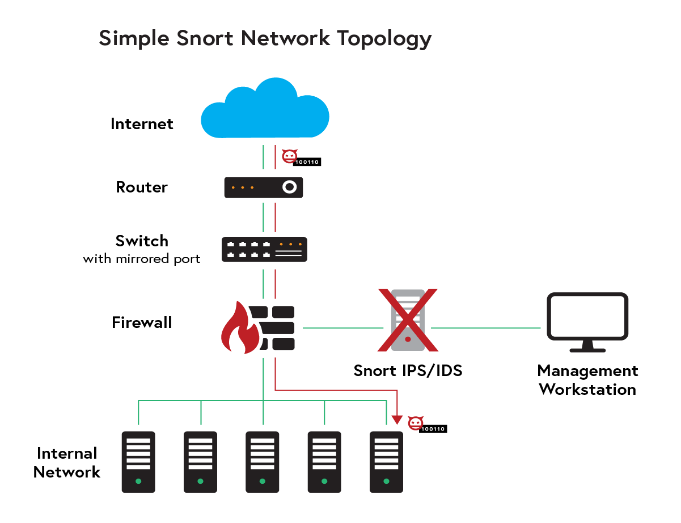
Slika 36: Preprosta topologija omrežja Snort .
Suricata: Visokozmogljiv IDS/IPS in nadzor omrežne varnosti (NSM)
Suricata, ki jo je razvila fundacija Open Information Security Foundation (OISF), je IDS/IPS naslednje generacije, ki nadgrajuje tradicionalno spremljanje omrežne varnosti z globokim pregledovanjem paketov (DPI) in izvorno večnitnostjo. Za razliko od Snorta, ki se osredotoča predvsem na zaznavanje na podlagi znanih značilnosti vdorov, lahko Suricata analizira več protokolnih plasti (vključno s HTTP, TLS, DNS in SMB) za odkrivanje bolj sofisticiranih in izmikajočih se groženj.
Ena njegovih ključnih prednosti je sposobnost obdelave omrežnega prometa z visokimi hitrostmi zaradi večnitne arhitekture, zaradi česar je zelo primeren za uvajanje na ravni podjetij in za varnostna okolja v oblaku. Poleg tega se brezhibno integrira z različnimi orodji za upravljanje varnostnih informacij in dogodkov ter platformami za analizo podatkov, kar omogoča vizualizacijo in analizo potencialnih groženj v realnem času.
Druga edinstvena značilnost Suricate je njena funkcionalnost spremljanja omrežne varnosti (Network Security Monitoring - NSM), ki ji omogoča, da poleg zaznavanja vdorov iz omrežnega prometa pridobiva tudi metapodatke. Ta zmogljivost pomaga ekipam za kibernetsko varnost učinkoviteje preiskovati varnostne napade in zagotavlja globlji vpogled v delovanje omrežja.
Globok pregled paketov za napredno zaznavanje groženj
Globoki pregled paketov (Deep Packet Inspection - DPI) presega pregledovanje glav paketov z analizo metapodatkov prenesenih podatkov, kar zagotavlja natančen vpogled v protokole, vsebino aplikacijske plasti in uporabniško določeno vedenje. Za razliko od tradicionalnega filtriranja paketov, ki pregleduje le glave IP in TCP/UDP, DPI pregleda celoten paket, kar mu omogoča prepoznavanje zlonamernih prenosov, kršitev protokolov ali šifriranih groženj, ki bi jih enostavnejši sistemi za filtriranje pogosto spregledali (Leslie, 2020).
Mehanizem DPI deluje tako, da v realnem času pregleduje vsebino paketov, pri čemer za filtriranje prometa uporablja ujemanje na podlagi znanih značilnosti napadov, hevristiko in zaznavanje anomalij. Pakete lahko razvrsti glede na protokol, vrsto aplikacije in vsebino, kar je bistveno za prepoznavanje groženj, skritih v omrežnem prometu, ki je videti legitimen. DPI lahko na primer loči med običajnim prometom HTTP in napadom, ki je osnovan na http-ju, kot je vbrizgavanje SQL ali komunikacija z zlonamerno programsko opremo za ukaz in nadzor. DPI je zmožen tudi dešifriranja prometa SSL/TLS za varnostno analizo, s čimer zagotavlja, da šifrirani paketi ne zaobidejo varnostnih kontrol. Številni sodobni kibernetski napadi izkoriščajo šifrirane prenesene podatke za skrivanje zlonamerne dejavnosti, vendar lahko DPI, ki ga poganja umetna inteligenca, prepozna vedenjske anomalije tudi v šifriranih prenosih, kot so nenavadni vzorci prenosa podatkov ali promet do znanih zlonamernih domen.
V kombinaciji z algoritmi umetne inteligence ali strojnega učenja DPI izboljša zaznavanje groženj z učenjem iz preteklih omrežnih vzorcev in zaznavanjem napadov ničtega dne ali naprednih vztrajnih napadov, ki se izognejo tradicionalnim varnostnim ukrepom.
Če se zazna anomalija, lahko sistemi DPI izvedejo avtomatizirane odzivne ukrepe, kot so izolacija ogrožene končne točke, prekinitev sumljivih povezav ali dinamično ponovno konfiguriranje pravil požarnega zidu, da preprečijo širjenje zlonamerne programske opreme po pomorskih IT in OT omrežjih (Ipoque, 2025).
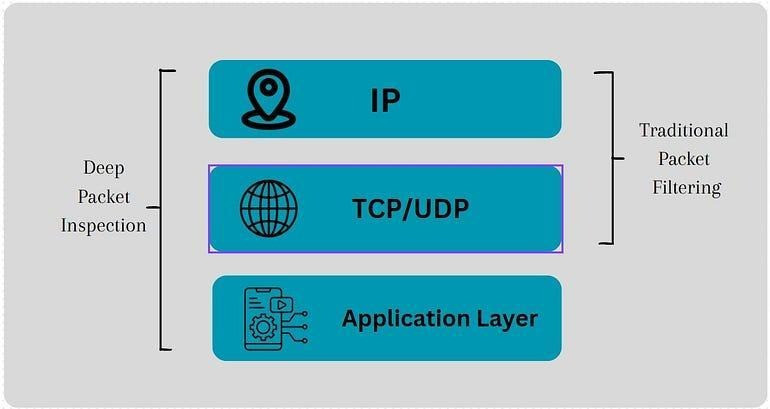
Slika 37: Primerjava tradicionalnega filtriranja paketov in poglobljenega pregleda paketov
(Nethmal, 2025).
Generativna nasprotujoča si omrežja za obogatitev in obrambo podatkov
Generativna nasprotujoča si omrežja (Generative Adversarial Networks - GAN) so sestavljena iz dveh konkurenčnih nevronskih mrež: generatorja, ki ustvarja sintetične podatke, in diskriminatorja, ki ocenjuje njihovo pristnost, kot je prikazano na sliki 38. GAN-i, ki so bili prvotno razviti za sintezo slik in generiranje globokih ponaredkov, so se izkazali za zelo učinkovite v aplikacijah kibernetske varnosti, zlasti pri odkrivanju vdorov, učenju nasprotujočega si vedenja in analizi zlonamerne programske opreme. Z ustvarjanjem zelo realističnih vzorcev napadov GAN-i izboljšujejo varnostne modele, ki temeljijo na strojnem učenju, kar jim omogoča prepoznavanje tako znanih kot prej nevidnih groženj (Zhao, 2024).
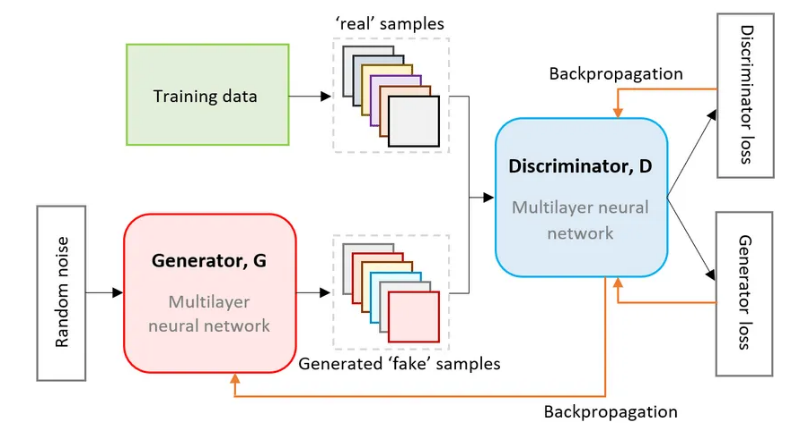
Slika 38: Arhitektura omrežja GAN
(TVS, 2025).
Ena od uporab generativnih nasprotujočih si omrežij (GAN) v kibernetski varnosti je njihova sposobnost ustvarjanja sintetičnih vzorcev zlonamerne programske opreme ali poskusov izkoriščanja, kar učinkovito dopolnjuje učne nabore podatkov za IDS in IPS. Tradicionalne rešitve IDS/IPS se zanašajo na zaznavanje na podlagi znanih značilnosti vdorov, ki se borijo proti napadom ničtega dne in polimorfni zlonamerni programski opremi, ki se nenehno razvija. Z usposabljanjem modelov IDS/IPS na nasprotujočih si vzorcih, ki jih generira GAN, lahko sistemi kibernetske varnosti izboljšajo svojo odpornost proti prej neznanim strategijam napadov. GAN-i se uporabljajo tudi pri avtomatiziranem testiranju penetracije, kjer ustvarjajo različice lažne e-pošte, vsebine napadov z grobo silo ali izkoriščajo skripte za testiranje varnostnega stanja organizacije. S simuliranjem resničnih kibernetskih groženj testiranje penetracije, ki ga poganja GAN, omogoča nenehno ocenjevanje varnosti, ne da bi sisteme izpostavili dejanskim napadom.
Poleg zaznavanja vdorov se GAN-i pogosto uporabljajo tudi pri zaznavanju anomalij. Detektor anomalij, ki temelji na GAN-ih, najprej spozna statistično porazdelitev normalnega vedenja omrežja in nato zazna subtilna odstopanja, ki lahko kažejo na prikrite kibernetske grožnje, prikrito zlonamerno programsko opremo ali poskuse kraje podatkov. Za razliko od tradicionalnega zaznavanja anomalij na podlagi pravil se GAN-i nenehno prilagajajo novim omrežnim pogojem, kar zmanjšuje lažno pozitivne rezultate in hkrati izboljšuje natančnost zaznavanja. Ta sposobnost prepoznavanja anomalij je še posebej uporabna pri odkrivanju naprednih vztrajnih groženj, ki se zlijejo z legitimnim prometom.
Druga inovativna uporaba GAN-ov je v kontradiktornem usposabljanju, ki temelji na nasprotujočih si omrežjih, kjer so modeli kibernetske varnosti utrjeni pred tehnikami izogibanja napadom. Napadalci pogosto uporabljajo kontradiktorne tehnike strojnega učenja za manipulacijo modelov IDS/IPS in ustvarjanje napadov, ki zaobidejo tradicionalne mehanizme zaznavanja. Z usposabljanjem GAN-ov za simulacijo kontradiktornih napadov je mogoče preizkusiti in okrepiti kibernetsko varnostno obrambo, kar zagotavlja robustnost pred kontradiktornimi napadi.
Zaznavanje anomalij
Medtem ko se sistemi za odkrivanje vdorov pogosto osredotočajo na specifične vrste vdorov, je odkrivanje anomalij širša tehnika, ki prepozna vsako netipično ali neprimerno vedenje, ki lahko signalizira sistemsko napako ali kibernetsko grožnjo. Z nadzorom kazalnikov, kot so poraba sistemskih virov, omrežna zakasnitev in poskusi prijave, algoritmi za odkrivanje anomalij zgradijo osnovo za to, kako izgleda »normalna« dejavnost. Vsako večje odstopanje od tega vzorca lahko predstavlja varnostno ali operativno težavo. V mnogih pomorskih aplikacijah lahko sistemi umetne inteligence sprožijo avtomatizirane protiukrepe, kot je izolacija ogroženih omrežij ali prilagajanje pravil požarnega zidu, da hitro zajezijo potencialne grožnje (Ribeiro et al., 2023). Ta hiter, avtonomen odziv je ključnega pomena v pomorskih operacijah, kjer se lahko majhni napadi hitro razvijejo v obsežne logistične ali varnostne izzive, če se jih ne lotimo takoj.
Slika 39: Odkrivanja anomalij v kibernetski varnosti .
Napovedna analiza kibernetskih groženj
Napovedna analiza uporablja zgodovinske podatke in vedenjske vzorce za predvidevanje morebitnih slabosti in prihodnjih strategij napadov, s čimer ponuja proaktivno kibernetsko obrambo. Z analizo velikega števila preteklih napadov lahko modeli umetne inteligence izolirajo dejavnike, ki se pogosto pojavijo pred napadom (Merrick, 2022). V praksi ti algoritmi simulirajo različne scenarije napadov, da bi prepoznali šibke točke, kar varnostnim ekipam zagotavlja jasno sliko o tem, kam naj najprej razporedijo vire. Z dodelitvijo ocen tveganja različnim grožnjam lahko pomorski operaterji določijo prednostne naloge in okrepijo svojo obrambo, da ohranijo kritične sisteme varne. Ta pristop ne le zmanjšuje neposredna tveganja, temveč tudi povečuje dolgoročno odpornost proti razvijajočim se kibernetskim grožnjam (Meijer in Wessels, 2019). Napovedna analitika je pogosto integrirana s sistemi za upravljanje varnostnih informacij in dogodkov, da se povežejo podatki iz več virov v realnem času, kar izboljša natančnost pri predvidevanju groženj. V kombinaciji s sistemi za odkrivanje in preprečevanje vdorov lahko ti modeli sprožijo avtomatizirane obrambne ukrepe za blokiranje groženj, še preden se uresničijo.
Potencialne ranljivosti in napadi nasprotnikov
Čeprav umetna inteligenca znatno krepi pomorsko kibernetsko varnost, uvaja tudi potencialne ranljivosti, ki jih lahko nasprotniki poskušajo izkoristiti. Kontradiktorni napadi vključujejo posredovanje skrbno izdelanih podatkov modelom umetne inteligence, s čimer jih zavedejo, da sprejemajo napačne presoje ali ignorirajo resnične grožnje (Qiu et al., 2019). Zlonamerni akterji lahko na primer prikrijejo zlonamerno programsko opremo tako, da jo sistem za zaznavanje, ki temelji na umetni inteligenci, napačno razvrsti kot neškodljivo. Druga nevarnost je zlonamerna sprememba modela, kjer napadalci v podatke za učenje vnesejo lažne ali zavajajoče informacije, kar postopoma zmanjšuje natančnost modela.
Da bi se zaščitile pred temi taktikami, pomorske organizacije pogosto sprejmejo vrsto zaščitnih ukrepov. Eden od njih je redno ponovno usposabljanje s preverjanjem celovitosti podatkov, kar zagotavlja, da model ostane natančen in posodobljen. Kontradiktorno usposabljanje modela, pri katerem je model med razvojem namerno izpostavljen zavajajočim vnosom, mu pomaga tudi pri učenju prepoznavanja in upiranja manipulativnim napadom. Nenazadnje so robustni podatkovni sistemi in nadzor dostopa bistveni za zaščito tako procesa usposabljanja kot operativne uporabe umetne inteligence, s čimer se ohranijo številne prednosti, ki jih prinaša pomorski varnosti in učinkovitosti.
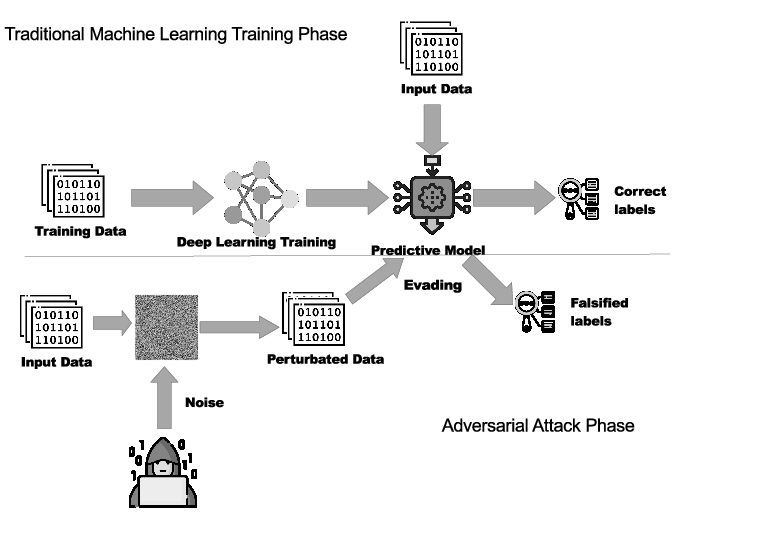
Slika 40: Primer sovražnega napada
(Catak in Šule, (2020).
Izzivi in omejitve umetne inteligence
Sistemi, ki jih poganja umetna inteligenca, ponujajo izboljšane zmogljivosti za prepoznavanje in zmanjševanje kibernetskih groženj, vendar uvajajo vrsto izzivov in omejitev, ki jih morajo organizacije obravnavati, da bi povečale svojo učinkovitost.
Kakovost in razpoložljivost podatkov
Ena od pomembnih težav je kakovost in razpoložljivost podatkov. Ker se ti sistemi za učenje in izboljšanje svojih algoritmov zaznavanja močno zanašajo na velike količine visokokakovostnih podatkov, lahko kakršne koli netočnosti ali vrzeli v teh podatkih vodijo do napačnih napovedi ali spregledanih groženj. Organizacije se pogosto soočajo s težavami pri poskusu integracije podatkov iz več omrežnih segmentov in različnih virov (Palo Alto Networks, 2025). To lahko povzroči nepopolno sliko o dejavnostih uporabnikov in vedenju sistema, kar ustvarja vrzeli pri odkrivanju groženj.
Lažno pozitivni rezultati in utrujenost zaradi opozoril
Drug izziv izhaja iz velikega števila lažno pozitivnih rezultatov. Čeprav si umetna inteligenca prizadeva zmanjšati število teh napačnih opozoril, lahko še vedno ustvari poplavo opozoril, ki preobremenijo varnostne ekipe. Ta situacija lahko povzroči utrujenost in varnostno osebje zaradi nenehnega pritoka obvestil z nizkim tveganjem lahko spregleda potencialno pomembna opozorila (Olateju et al., 2024). Upravljanje in preiskava teh številnih opozoril zahteva precej časa in virov, kar lahko preusmeri pozornost stran od legitimnih groženj.
Kompleksnost in pomanjkanje interpretacije
Kompleksnost in možnosti interpretacije predstavljata dodatne ovire. Sodobne tehnike umetne inteligence, zlasti globoko učenje, lahko prinesejo rezultate prek nepreglednih procesov odločanja. Varnostni analitiki imajo lahko težave z zaupanjem v opozorila ali z ukrepanjem na podlagi njih, če ne morejo razumeti, kako ali zakaj je model umetne inteligence prišel do določenega zaključka (Digital Leaders, 2025). Zato je za izgradnjo zaupanja v varnostna orodja, ki jih poganja umetna inteligenca, ključnega pomena zagotoviti, da sistem ponuja jasne razlage in utemeljitve.
Integracija z obstoječimi sistemi
V mnogih organizacijah je integracija z obstoječimi sistemi vse prej kot gladka. Sistemi, ki jih poganja umetna inteligenca, morajo brezhibno delovati z obstoječo varnostno infrastrukturo organizacije, kar lahko vključuje težave z združljivostjo in zahteva veliko tehničnega znanja. Zastareli sistemi pogosto potrebujejo nadgradnje, preden lahko obvladajo zahteve glede obdelave podatkov in napredne analitike umetne inteligence. Te zahteve ne le povečujejo kompleksnost uvajanja, temveč ustvarjajo tudi dodatne stroške in podaljšujejo roke za implementacijo.
Ranljivost za napade nasprotnikov
Modeli umetne inteligence so lahko sami ranljivi za napade nasprotnikov, pri katerih zlonamerni akterji namerno manipulirajo z vhodnimi podatki, da bi zavedli sistem. To vključuje uvajanje zavajajočih vzorcev ali signalov, zaradi katerih umetna inteligenca napačno razvrsti grožnje ali odobri nepooblaščen dostop. Blaženje teh napadov zahteva stalno spremljanje in posodabljanje, da modeli ostanejo robustni kljub razvijajočim se tehnikam nasprotnikov (MetaCompliance, 2025).
Pristranskost v modelih umetne inteligence
Pristranskost znotraj modelov umetne inteligence je nadaljnja skrb. Če so podatki o učenju izkrivljeni ali odražajo določene predsodke, lahko sistem za odkrivanje vdorov nepravično označi določene skupine, vrste dejavnosti ali vedenje uporabnikov. To lahko vodi ne le do etičnih vprašanj, temveč tudi do neoptimalnih varnostnih rezultatov, saj lahko izkrivljen fokus povzroči, da sistem spregleda večje grožnje (ISC², 2024). Prepoznavanje in zmanjševanje pristranskosti je zato ključnega pomena za zagotavljanje pravičnosti in ohranjanje integritete postopka odkrivanja.
Izzivi glede predpisov in skladnosti
Regulativne zahteve in zahteve glede skladnosti uvajajo še eno plast kompleksnosti. Številne panoge, vključno s pomorskim sektorjem, morajo upoštevati stroge zakone o zasebnosti podatkov in kibernetski varnosti, da zagotovijo varno ravnanje s podatki o uporabnikih, strankah in operativnimi podatki. Rešitve, ki jih poganja umetna inteligenca, morajo ustvariti jasne revizijske sledi in ponuditi zadostno preglednost za dokazovanje skladnosti med revizijami, kar dodaja upravno in tehnično breme procesu izvajanja (Ethico, 2024). Skladnost z okviri, kot so okvir NIST za kibernetsko varnost, ISO 27001 in smernice ENISA, je ključnega pomena za zagotavljanje varne in zakonite uvedbe sistemov kibernetske varnosti, izboljšanih z umetno inteligenco.
Visoki stroški izvedbe in vzdrževanja
Pomemben dejavnik so tudi stroški. Začetni stroški za specializirano strojno opremo, programske licence in profesionalne storitve so lahko visoki, tekoče vzdrževanje, posodobitve in preprogramiranje modelov pa vključujejo nenehne izdatke. Posledično imajo manjše organizacije lahko težave z upravičevanjem oz. si ne morejo privoščiti dolgoročnih naložb, potrebnih za uvajanje in vzdrževanje zmogljivosti, ki jih poganja umetna inteligenca, v tako velikem obsegu (Modern Diplomacy, 2024).
Pomanjkanje usposobljenih strokovnjakov
Poleg tega pogosto primanjkuje potrebnega strokovnega znanja za upravljanje varnostnih sistemov, ki temeljijo na umetni inteligenci. Organizacije imajo lahko težave pri zaposlovanju ali usposabljanju strokovnjakov z znanjem o umetni inteligenci in izkušnjami z varnostjo. Obveščanje osebja o hitro razvijajočih se tehnikah umetne inteligence in grožnjah kibernetske varnosti zahteva zavezanost nenehnim izobraževalnim in programom usposabljanja (Technology Magazine, 2024).
Pomisleki glede zasebnosti
Nenazadnje pri uporabi IDS, ki ga poganja umetna inteligenca, za spremljanje vedenja uporabnikov pridejo v ospredje tudi pomisleki glede zasebnosti. Zbiranje in analiziranje tako podrobnih informacij je lahko v nasprotju z zakoni o varstvu podatkov, če se z njimi ne ravna skrbno. Organizacije morajo zagotoviti, da se uporabniški podatki zbirajo, shranjujejo in obdelujejo na način, ki spoštuje pravice posameznikov do zasebnosti in je skladen s predpisi, kot je GDPR (Stewart, 2024). Za doseganje tega ravnovesja je treba pridobiti soglasje uporabnikov, jasno navesti politike spremljanja in vzdrževati stroge prakse upravljanja podatkov.
Z reševanjem teh izzivov, od kakovosti podatkov in lažno pozitivnih rezultatov do interpretacij, stroškov, pristranskosti, vrzeli v znanju in pomislekov glede zasebnosti, lahko organizacije izkoristijo polni potencial rešitev, ki jih poganja umetna inteligenca, hkrati pa ohranijo robustno varnost in skladnost s predpisi.
Umetna inteligenca spreminja pomorsko kibernetsko varnost z izboljšanjem zaznavanja groženj, preprečevanjem kibernetskih napadov in optimizacijo delovanja plovil. Sistemi, ki jih poganja umetna inteligenca, kot so IDS, IPS in DPI, s strojnim učenjem in globokim učenjem pomagajo spremljati, analizirati in se odzivati na varnostna tveganja v realnem času. Napovedna analitika dodatno krepi kibernetsko obrambo z odkrivanjem ranljivosti, še preden pride do napadov. Vendar pa uvedba umetne inteligence prinaša izzive, vključno z napadi nasprotnikov, pristranskostjo in kompleksnostjo integracije. Za zagotovitev odpornosti je bistvenega pomena nenehen napredek varnostnih strategij umetne inteligence, kot so kontradiktorno usposabljanje, izboljšana skladnost s predpisi in prilagodljivi učni modeli. Z razvojem kibernetskih groženj bo umetna inteligenca igrala vse pomembnejšo vlogo pri varovanju pomorskih operacij, hkrati pa bo izboljševala operativno učinkovitost in varnost.
6. Zaključek
Vzpon novih tehnologij predstavlja tako vznemirljive priložnosti kot tudi pomembne izzive za pomorsko kibernetsko varnost. Čeprav avtonomni sistemi in tehnologije naslednje generacije obljubljajo revolucijo v panogi, uvajajo tudi številne nove ranljivosti in varnostna tveganja, ki jih je treba obravnavati. Povečana integracija naprav interneta stvari v ladijske operacije zahteva celosten pristop k varnosti, s poudarkom na zaščiti tako naprav kot omrežij, s katerimi se povezujejo.
Ko se panoga premika k rešitvam za kibernetsko varnost, ki jih poganja umetna inteligenca, postaja potencial za napovedno analizo in proaktivno odkrivanje groženj vse bolj izrazit, kar ponuja nove načine za preprečevanje napadov, še preden se zgodijo. Vendar pa je treba te tehnologije skrbno vključiti v obstoječo varnostno infrastrukturo, da se prepreči prevelika kompleksnost sistema ali še dodatne slabosti.
Pomorski sektor mora v prihodnje sprejeti napreden pristop h kibernetski varnosti in nenehno razvijati svojo obrambo, da bi sledil tehnološkemu napredku. Z obravnavo tveganj, povezanih z avtomatizacijo, internetom stvari in umetno inteligenco, lahko pomorstvo zgradi odporno kibernetsko varnostno držo, ki ne le ščiti trenutne operacije, temveč zagotavlja tudi varno in zanesljivo uvajanje prihodnjih tehnologij.