
Completion requirements
Tecnologías emergentes y retos futuros
5. IA para ciberseguridad marítima y análisis predictivo
La ciberseguridad se ha convertido en una preocupación crítica para proteger funciones vitales como la navegación, la gestión de carga y las redes de comunicación. La Inteligencia Artificial (IA) ha surgido como una herramienta poderosa para afrontar estos desafíos de seguridad. Al analizar grandes cantidades de datos, los sistemas de IA pueden detectar amenazas con mayor precisión, acelerar las respuestas y mitigar interrupciones operativas (Kaur et al., 2023). Este documento ofrece una visión general de la IA, el Aprendizaje Automático (ML) y el Aprendizaje Profundo (DL), describe el desarrollo de los ciclos de vida de los modelos de aprendizaje automático y analiza cómo estas tecnologías pueden fortalecer la ciberseguridad marítima y la eficiencia operativa.
Más allá de detectar ataques, la IA también mejora el rendimiento y la eficiencia energética de los buques analizando los datos de los sensores de los buques para predecir posibles fallos mecánicos antes de que ocurran (Tu et al., 2018). Esta técnica ayuda a programar las reparaciones en los momentos más rentables y evita averías inesperadas. Además, la IA puede modificar dinámicamente la velocidad y la ruta de un barco en función de las condiciones meteorológicas, la carga o el consumo de combustible, reduciendo así los costes operativos y el impacto medioambiental.
Otra aplicación crítica es la vigilancia visual impulsada por IA, que refuerza la seguridad marítima al monitorizar las actividades a bordo en busca de accesos no autorizados o comportamientos inusuales (Şengönül et al., 2023). Los modelos de aprendizaje profundo, como las redes neuronales convolucionales, pueden reconocer anomalías en la manipulación de carga o detectar cuando el personal entra en zonas restringidas. Por ejemplo, los sistemas robóticos pueden retirar de forma segura y eficiente los productos de los contenedores que llegan en orden aleatorio, reduciendo los riesgos de trabajo manual y mejorando la precisión operativa (Mojtahedzadeh et al., 2015).
2. Fundamentos de IA, ML y DL
La Inteligencia Artificial es un campo amplio de la informática centrado en crear sistemas capaces de realizar tareas que normalmente requieren inteligencia humana, como comprender el lenguaje, reconocer patrones o tomar decisiones. La investigación temprana en IA se basó en gran medida en lo que se llaman sistemas "basados en reglas", donde los expertos anotaban conjuntos detallados de instrucciones IF-THEN como se muestra en la Figura 23. Por ejemplo, una regla de ciberseguridad podría decir: "SI un ordenador registra múltiples intentos fallidos de inicio de sesión, ENTONCES bloquea temporalmente al usuario." Estos sistemas funcionan bien en situaciones donde las reglas pueden definirse claramente, pero pueden tener dificultades cuando se enfrentan a problemas nuevos o inesperados.
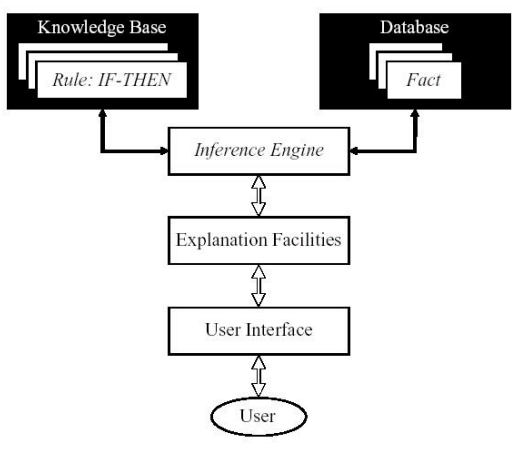
Figura 23: Estructura de sistemas basados en reglas de IA
(Mojtahedzadeh et al., 2015)
La IA moderna va más allá de depender únicamente de reglas escritas manualmente. En su lugar, utiliza técnicas como el Aprendizaje Automático, que permiten a los ordenadores aprender de los datos sin estar programados explícitamente para todos los escenarios posibles. En lugar de especificar instrucciones para cada situación, proporcionamos al sistema grandes cantidades de información, permitiéndole analizar patrones y tomar sus propias decisiones. Este proceso refleja cómo los humanos aprenden a través de la experiencia al observar numerosos ejemplos, reconocer relaciones y mejorar gradualmente su comprensión. En operaciones marítimas, por ejemplo, ML puede analizar datos de sistemas de seguimiento GPS para detectar movimientos inusuales del buque que puedan indicar acceso no autorizado o amenazas de piratería. Al aprender continuamente a partir de datos de localización en tiempo real e incidentes pasados, la IA puede reconocer desviaciones respecto a las rutas o comportamientos normales, activando alertas antes de que los riesgos potenciales de seguridad se agraven. Con el tiempo, los modelos de aprendizaje automático refinan sus predicciones y se adaptan a nuevos casos, haciéndolos más eficaces para manejar problemas complejos y en evolución sin requerir intervención humana directa en cada decisión.
Dentro del aprendizaje automático, hay diferentes formas de aprender. En un enfoque, a menudo llamado aprendizaje supervisado, se muestran al sistema ejemplos que ya tienen respuestas o etiquetas. Con el tiempo, descubre cómo se relacionan esas respuestas con cada ejemplo para poder predecir resultados de datos nuevos y no vistos. Dependiendo del tipo de problema, el aprendizaje supervisado puede utilizarse para la clasificación, donde el objetivo es asignar puntos de datos a categorías específicas, como detectar si la comunicación de un buque es legítima o una posible amenaza cibernética. También puede utilizarse para regresión, donde el modelo predice valores continuos, como estimar el consumo de combustible basado en velocidad, peso de carga y condiciones meteorológicas.
En otro enfoque, conocido como aprendizaje no supervisado, el sistema trabaja con información que no tiene etiquetas, por lo que debe descubrir patrones ocultos por sí mismo, como agrupar elementos similares. Esto es útil en ciberseguridad marítima al analizar el tráfico de red para detectar anomalías que puedan indicar ciberataques, ya que el sistema puede agrupar comportamientos normales y anormales sin conocimiento previo de cómo es un ataque.
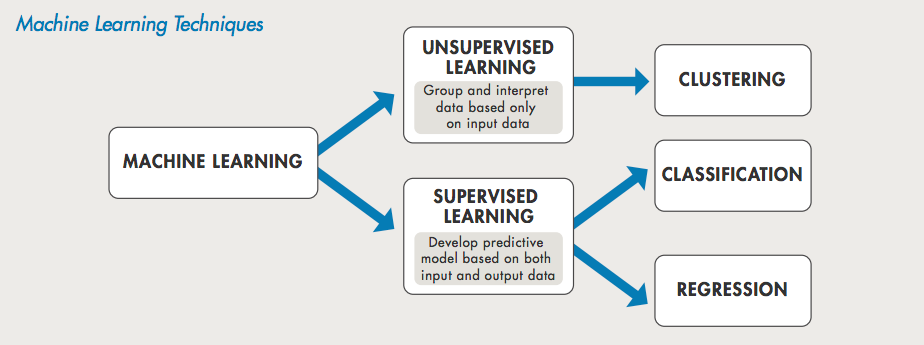
Figura 24: Técnicas de aprendizaje automático
Un tercer enfoque, llamado aprendizaje por refuerzo (RL), consiste en aprender por prueba y error. A diferencia del aprendizaje supervisado, donde el sistema recibe ejemplos etiquetados de respuestas correctas, el aprendizaje por refuerzo opera en un entorno donde debe descubrir el comportamiento óptimo mediante la interacción. El sistema, a menudo llamado "agente", prueba diferentes facciones dentro de este entorno y recibe retroalimentación en forma de recompensas o penalizaciones. Una recompensa indica que una acción era deseable, mientras que una penalización indica una acción indeseable. El objetivo del agente es aprender una "política", que es un mapeo de estados (la situación actual en la que se encuentra el agente) a acciones, lo que maximiza su recompensa acumulada a lo largo del tiempo. Por ejemplo, en el control robótico, el RL puede usarse para enseñar a un robot a caminar. El robot comienza dando pasos aleatorios, recibiendo retroalimentación basada en la estabilidad, la eficiencia energética y el movimiento hacia adelante. A lo largo de múltiples iteraciones, aprende a ajustar los movimientos articulares para caminar de forma más eficiente, mejorando el equilibrio y minimizando el gasto energético (Song et al., 2021).
El Deep Learning lleva a la inteligencia artificial un paso más allá al intentar imitar la forma en que el cerebro humano procesa la información. En esencia, utiliza redes neuronales artificiales, estructuradas de forma similar a las neuronas biológicas, para aprender y reconocer automáticamente patrones en grandes cantidades de datos. A diferencia del aprendizaje automático tradicional, donde los humanos a menudo necesitan seleccionar y definir manualmente las características más relevantes para que un modelo funcione, los modelos de aprendizaje profundo extraen estas características por sí mismos, dando sentido a los datos en bruto sin necesidad de programación explícita. El sistema determina qué aspectos de los datos son más importantes, permitiéndole identificar patrones y tomar decisiones con una intervención humana mínima.
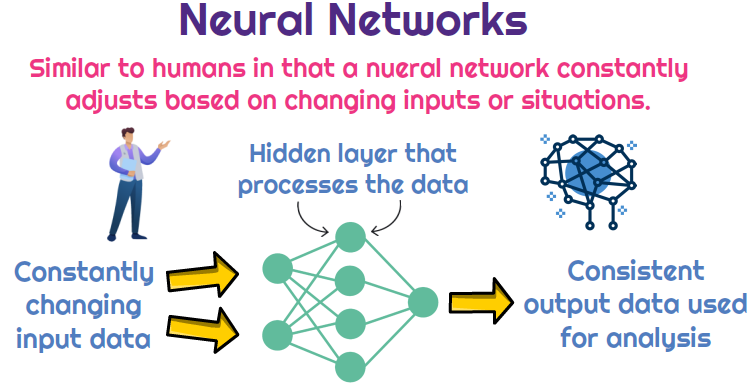
Figura 25: Sistemas de aprendizaje adaptativo que procesan datos de entrada cambiantes para generar una salida consistente para el análisis .
Así como el cerebro humano tiene regiones especializadas para diferentes tareas, los modelos de aprendizaje profundo se diseñan con arquitecturas que se centran en tipos específicos de datos. Por ejemplo, al procesar información visual, la corteza visual del cerebro reconoce objetos detectando bordes, formas y texturas antes de formar una imagen completa. Inspirados en esto, las Redes Neuronales Convolucionales (CNNs) (Jorgecardete, 2025) están diseñadas para gestionar tareas relacionadas con la visión, aprendiendo automáticamente características relevantes a partir de imágenes sin necesidad de entrada manual. Por ejemplo, las CNN pueden usarse para el reconocimiento de expresiones faciales analizando imágenes faciales e identificando emociones como la ira, la felicidad o la sorpresa. En lugar de exigir a los humanos que definan manualmente cómo se ve cada emoción, el modelo aprende patrones examinando miles de imágenes faciales. A través de capas convolucionales y de agrupación, extrae características significativas como movimientos y expresiones de los músculos faciales, que luego se procesan mediante capas totalmente conectadas y se clasifican usando una función SoftMax para determinar la emoción más probable.
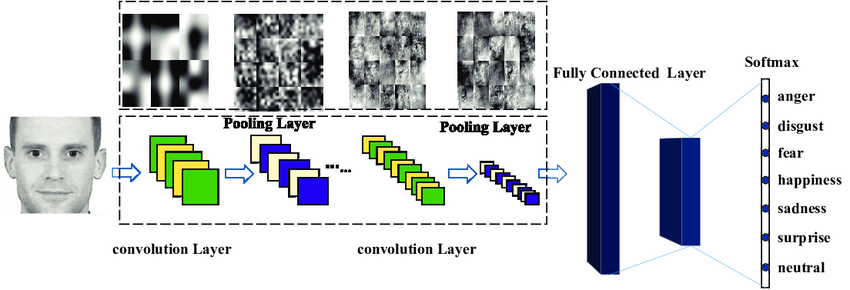
Figura 26: Conductos de reconocimiento facial de emociones basado en aprendizaje profundo.
El procesamiento de memoria y secuencias en el cerebro humano también desempeña un papel crucial en la toma de decisiones y el reconocimiento de patrones, y es ahí donde entran en juego los modelos de aprendizaje profundo como las redes neuronales recurrentes (RNN) y las redes de memoria a corto plazo largo (LSTM). La forma en que los humanos recuerdan experiencias pasadas y las utilizan para influir en las decisiones presentes es lo que estos modelos intentan replicar. Son especialmente eficaces para manejar datos secuenciales, como el lenguaje, las predicciones de series temporales o el análisis del tráfico de red.
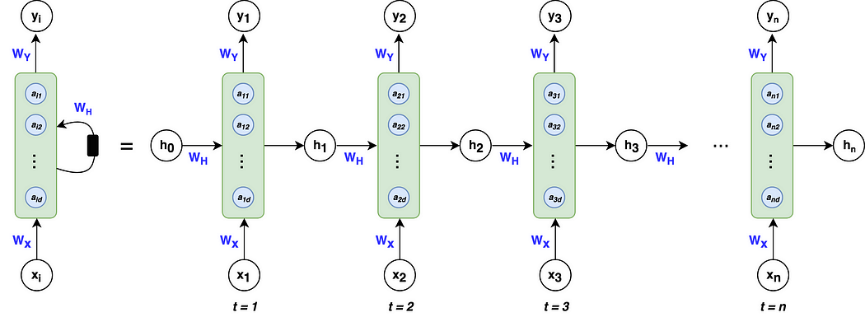
Figura 27: Arquitectura de redes neuronales recurrentes simples
(Khuong, 2025)
El procesamiento del lenguaje es otro ámbito en el que el aprendizaje profundo destaca, imitando la forma en que el cerebro humano interpreta y genera el habla. Modelos basados en transformadores como BERT y GPT analizan grandes cantidades de texto, aprendiendo a entender patrones de lenguaje sin requerir reglas gramaticales predefinidas. En ciberseguridad marítima, estos modelos pueden escanear correos electrónicos, comunicaciones por radio y registros del sistema para detectar intentos de phishing, mensajes fraudulentos o instrucciones no autorizadas disfrazadas de comunicación normal. En lugar de depender de la simple detección de palabras clave, estos modelos entienden el contexto y la intención, lo que los hace muy efectivos para detectar amenazas sutiles que los sistemas tradicionales basados en reglas pasarían por alto.
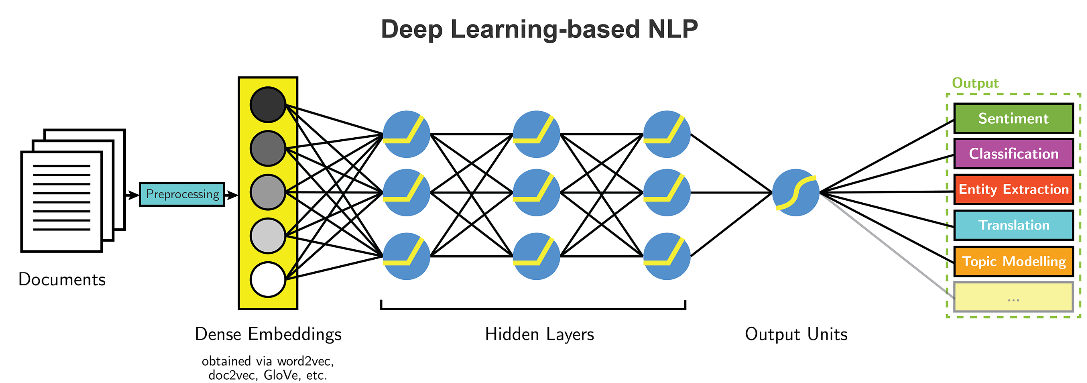
Figura 28: PLN basado en aprendizaje profundo.
La fortaleza principal del aprendizaje profundo radica en su capacidad para aprender automáticamente características relevantes a partir de grandes cantidades de datos no estructurados. A diferencia de los enfoques tradicionales de aprendizaje automático, donde los expertos humanos deben diseñar características (es decir, decidir qué aspectos de los datos son importantes), los modelos de aprendizaje profundo destacan en discernir estas características de forma independiente, como se muestra en la Figura 29. Ya sea que los datos consistan en imágenes, registros de red, lecturas de sensores o texto, el sistema analiza numerosos ejemplos, refinando gradualmente su comprensión e identificando de forma autónoma los patrones más informativos. Esto elimina la necesidad de ingeniería manual de características, un proceso que puede ser laborioso, requiere conocimientos especializados en el dominio y puede no captar todas las sutilezas ocultas en los datos.
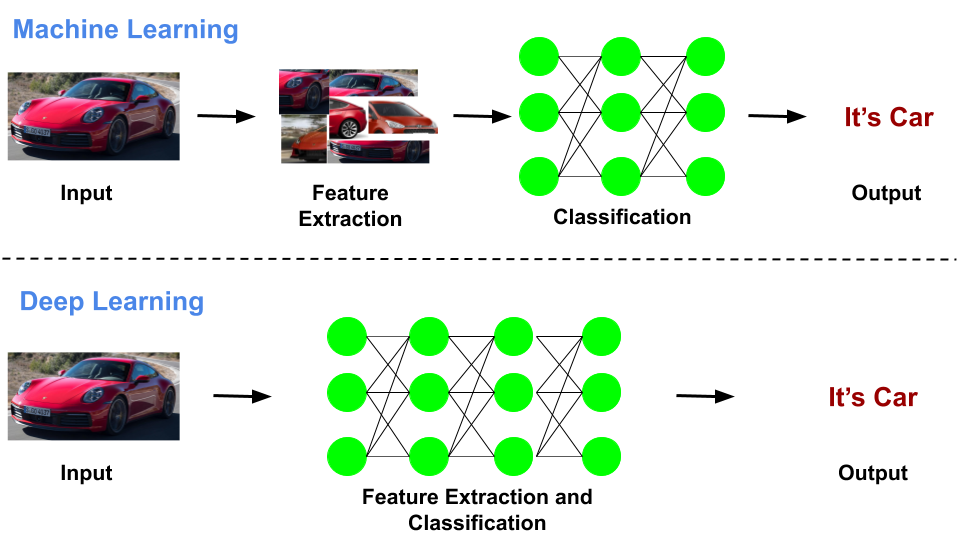
Figura 29: Diferencias entre el aprendizaje automático y el pipeline de aprendizaje profundo.
En la industria marítima, la IA puede integrarse en sistemas de ciberseguridad para procesar la gran cantidad de datos producidos por buques, puertos y enlaces satelitales. A medida que evolucionan las amenazas, los modelos de ML y DL pueden actualizarse continuamente usando nueva información, detectando riesgos o ataques que quizá nunca habrían sido descritos explícitamente por reglas escritas por humanos. Esta capacidad de adaptarse y perfeccionarse con el tiempo es lo que hace que la IA sea tan valiosa para afrontar los retos modernos de ciberseguridad. La Figura 30 ofrece una visión general de alto nivel de las aplicaciones de IA en ciberseguridad.
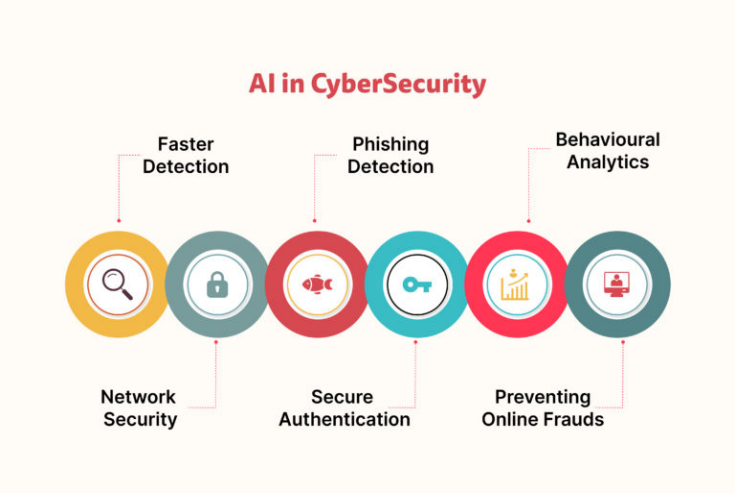
Figure 30: Applications of Ai in Cybersecurity.
Desarrollo de modelos de aprendizaje automático/aprendizaje profundo
El proceso de desarrollo de un modelo de aprendizaje automático o aprendizaje profundo sigue una serie estructurada de pasos, desde la adquisición de datos hasta el despliegue y mantenimiento del modelo. Cada paso desempeña un papel crucial para garantizar que el sistema pueda hacer predicciones precisas y fiables en entornos reales. A continuación se muestra un desglose detallado de toda la cartera, junto con explicaciones para que sea más comprensible para quienes no estén familiarizados con el campo.
Adquisición de datos: recopilación de información relevante
El primer paso en cualquier proyecto de ML o DL es adquirir datos. Sin datos de alta calidad, incluso los mejores algoritmos tendrán dificultades para producir resultados útiles. Los datos pueden provenir de diversas fuentes, dependiendo del problema en cuestión. En el caso de la ciberseguridad marítima, por ejemplo, los datos relevantes pueden incluir registros de tráfico de red, registros de eventos de seguridad y métricas de rendimiento del sistema. Los registros de red capturan la comunicación entre dispositivos, ayudando a identificar patrones inusuales que pueden indicar amenazas cibernéticas. Los registros de eventos de seguridad contienen alertas generadas por los sistemas de ciberseguridad cuando se detecta actividad sospechosa. Los datos de rendimiento del sistema, como el uso de la CPU o la actividad de memoria, pueden proporcionar información sobre posibles brechas o fallos de seguridad. El tipo de datos recogidos depende completamente del problema específico que el modelo pretende resolver. Para la detección de intrusiones, podrían ser necesarios datos de red a nivel de paquete, mientras que para la vigilancia de barcos, sería más relevante el metraje de vídeo en tiempo real.
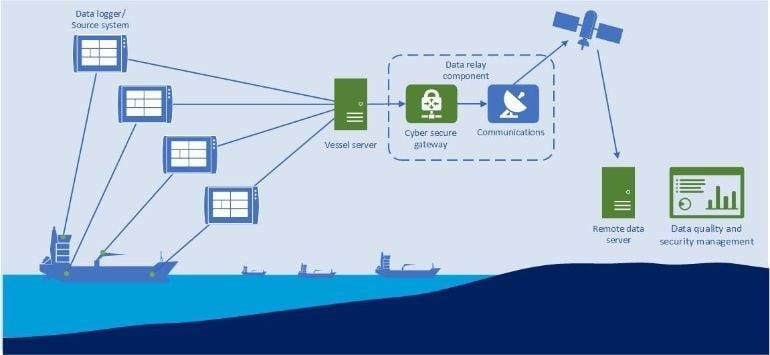
Figura 31: Ejemplo de adquisición de datos en el sector marítimo.
Preparación de datos: limpieza y formato de datos para análisis
Los datos en bruto suelen ser no estructurados, inconsistentes o contienen errores que pueden afectar negativamente al rendimiento del modelo. Para garantizar que los datos sean utilizables, deben pasar por una fase de preparación. Este proceso implica varios pasos clave, como el manejo de valores de menos, la eliminación de ruido y la estandarización de las entradas. Los valores ausentes pueden producirse debido a sensores defectuosos o registros incompletos y deben abordarse completándolos con valores estimados o descartando registros incompletos. El ruido, como puntos de datos corruptos o información irrelevante, debe eliminarse para evitar que el modelo aprenda patrones incorrectos. La estandarización es otro paso crucial, ya que los datos suelen presentarse en diferentes formatos o unidades. Por ejemplo, las marcas de tiempo en los registros de red pueden necesitar convertirse en una zona horaria consistente, o los valores numéricos pueden necesitar normalizarse para asegurar que estén en una escala comparable. En conjuntos de datos estructurados, como tablas de actividad de red, esta fase también puede incluir la eliminación de entradas duplicadas. Para datos no estructurados como imágenes o texto, el preprocesamiento puede implicar redimensionar imágenes, reducir el ruido de fondo o convertir palabras en representaciones numéricas que el modelo pueda procesar.
Ingeniería de características: Identificación o creación de patrones significativos
En el aprendizaje automático tradicional, los modelos no comprenden inherentemente qué aspectos de los datos son relevantes. En su lugar, los expertos deben definir manualmente las características más útiles para resolver el problema. Este proceso, conocido como ingeniería de características, consiste en seleccionar, transformar o crear nuevas variables a partir de datos en bruto para mejorar el rendimiento del modelo. Una ingeniería de características eficaz puede mejorar significativamente la precisión de un modelo al proporcionarle información significativa. Por ejemplo, en un sistema de detección de intrusiones, los registros de tráfico de red en bruto pueden contener detalles como direcciones IP, marcas de tiempo, tamaños de paquetes y estados de conexión. Sin embargo, estos valores en bruto por sí solos pueden no ser lo suficientemente informativos para el modelo. Para mejorar la detección, un experto podría crear nuevas características basadas en patrones estadísticos o tendencias de comportamiento. Una de estas características podría ser la tasa de intento de conexión, donde el número de solicitudes de conexión desde una dirección IP específica se mide dentro de una ventana temporal dada, como 10 segundos. Un pico repentino en los intentos de conexión podría indicar un ataque de fuerza bruta.
Sin embargo, el aprendizaje profundo elimina gran parte de la necesidad de ingeniería de características. En lugar de depender de la intuición humana para definir características importantes, las redes neuronales profundas aprenden patrones automáticamente directamente a partir de datos en bruto. Esta es una de las principales ventajas de DL sobre el aprendizaje automático tradicional. Puede procesar datos no estructurados, como imágenes, audio y texto, sin requerir reglas explícitas para la extracción de características. Por ejemplo, en reconocimiento de imágenes, una red neuronal convolucional puede aprender a detectar bordes, texturas y objetos complejos sin intervención humana, lo que la hace muy eficaz para aplicaciones como el análisis de imágenes de vigilancia en tiempo real en barcos.
Selección de modelo: Elegir el algoritmo adecuado
Una vez que los datos han sido preparados, el siguiente paso es seleccionar el mejor modelo para el problema. La elección del algoritmo depende de factores como el tipo de datos, la complejidad de la tarea y los recursos computacionales disponibles. En el aprendizaje automático tradicional, se utilizan comúnmente modelos como árboles de decisión, máquinas de vectores de soporte (SVMs) o bosques aleatorios, especialmente al trabajar con conjuntos de datos estructurados. Estos modelos requieren características definidas manualmente, pero pueden funcionar bien con conjuntos de datos relativamente pequeños.
Los modelos de aprendizaje profundo, en cambio, son más potentes pero requieren grandes cantidades de datos y recursos computacionales. Las CNN son especialmente eficaces para tareas relacionadas con la imagen, como la detección de objetos en imágenes de vigilancia marítima. Las redes neuronales recurrentes o transformadores son más adecuadas para datos secuenciales, como analizar registros de comunicación a lo largo del tiempo para detectar patrones de ciberamenazas. Elegir el modelo adecuado es un paso crucial, ya que una elección incorrecta puede llevar a un bajo rendimiento o a un cálculo ineficiente.
Entrenamiento de modelos: Aprendiendo a partir de los datos
Después de seleccionar un modelo, el siguiente paso es entrenarlo para hacer predicciones. El entrenamiento consiste en introducir datos en el modelo, permitiéndole aprender patrones y ajustando sus parámetros internos para mejorar la precisión. El modelo realiza predicciones iniciales, y una función de pérdida mide lo lejos que están estas predicciones de las respuestas correctas. Si la pérdida es alta, significa que el modelo está haciendo predicciones erróneas. Para mejorar, un proceso de optimización, como el descenso de gradiente, actualiza los parámetros del modelo (conocidos como pesos) para reducir gradualmente la pérdida. Este proceso iterativo continúa hasta que el modelo alcanza un nivel aceptable de precisión.
En el aprendizaje supervisado, el modelo se entrena con datos etiquetados, lo que significa que cada entrada tiene una salida correcta conocida (por ejemplo, etiquetas de clase en clasificación o valores objetivo en regresión). El objetivo es minimizar la diferencia entre predicciones y etiquetas verdaderas, normalmente utilizando funciones de pérdida como la entropía cruzada (para clasificación) o el error cuadrático medio (para regresión).
En el aprendizaje profundo, este proceso es computacionalmente intensivo y requiere grandes conjuntos de datos. A diferencia del aprendizaje automático tradicional, donde el entrenamiento puede completarse en minutos u horas, entrenar redes neuronales profundas puede llevar días o incluso semanas, dependiendo de la complejidad de la arquitectura y el tamaño de los datos. Para manejar esta complejidad, frameworks de aprendizaje profundo como TensorFlow y PyTorch proporcionan herramientas eficientes para la construcción de modelos, la diferenciación automática y la aceleración por hardware. Estas librerías soportan grafos de cómputo dinámico y ofrecen una amplia gama de funciones preconstruidas para optimizar modelos. El ajuste de hiperparámetros, ajustando parámetros como la tasa de aprendizaje, el tamaño del lote y el número de épocas de entrenamiento, es esencial para asegurar que el modelo converge eficazmente.
En el aprendizaje no supervisado, el modelo se entrena con datos no etiquetados, es decir, no tiene categorías predefinidas ni respuestas correctas. En lugar de predecir resultados específicos, el modelo identifica patrones, estructuras o agrupaciones en los datos.
Los algoritmos de agrupamiento agrupan puntos de datos similares basándose en medidas de distancia.
Las técnicas de reducción de dimensionalidad pueden comprimir datos de alta dimensión en una forma de menor dimensional, preservando la información esencial.
Los modelos generativos aprenden a generar nuevas muestras de datos que se asemejan a la distribución de entrenamiento.
Dado que ninguna función de pérdida explícita compara las predicciones con la verdad fundamental, el entrenamiento a menudo implica objetivos no supervisados, como minimizar errores de reconstrucción o maximizar la variación entre conglomerados.
Validación y pruebas de modelos: Evaluación del rendimiento
Una vez completado el entrenamiento, es esencial comprobar qué tan bien se generaliza el modelo a datos nuevos y no vistos. Esto se hace mediante validación y pruebas, utilizando conjuntos de datos separados que no formaban parte del proceso de entrenamiento. Si un modelo funciona bien durante el entrenamiento pero no hace predicciones precisas sobre nuevos datos, es probable que esté sobreajustado, es decir, que ha aprendido patrones demasiado específicos para el conjunto de entrenamiento y no generaliza bien a datos no vistos. Se utilizan métricas de rendimiento como la precisión, la exactitud, la recuperación y la puntuación F1 para evaluar la efectividad del modelo. La precisión mide la proporción de predicciones correctas, mientras que la precisión y el recuerdo proporcionan información sobre la fiabilidad del modelo para detectar categorías específicas, como las amenazas cibernéticas. La puntuación F1 equilibra precisión y recuerdo, ofreciendo una evaluación más completa. Si el rendimiento del modelo no es satisfactorio, se pueden realizar ajustes recogiendo más datos, refinando la selección de características (en ML) o ajustando hiperparámetros.
Despliegue y monitorización continua: Uso del modelo en el mundo real
Una vez que el modelo alcanza una precisión y robustez satisfactorias, se despliega en un entorno real donde comienza a hacer predicciones basadas en datos en vivo. Sin embargo, el despliegue no es el paso final; es necesario un seguimiento y mantenimiento continuos para garantizar un rendimiento continuo. En ciberseguridad marítima, por ejemplo, surgen constantemente nuevas amenazas cibernéticas, y un modelo entrenado con patrones de ataque pasados puede quedar obsoleto con el tiempo. Para evitar la degradación del rendimiento, los modelos necesitan reentrenamiento periódico con datos actualizados, monitorización continua en busca de errores y mejoras para adaptarse a condiciones cambiantes. No hacerlo puede dar lugar a predicciones obsoletas, vulnerabilidades de seguridad o una disminución de la precisión.
Una visión general de alto nivel de la cadena de entrenamiento para un modelo de aprendizaje automático supervisado se muestra en la Figura 32.
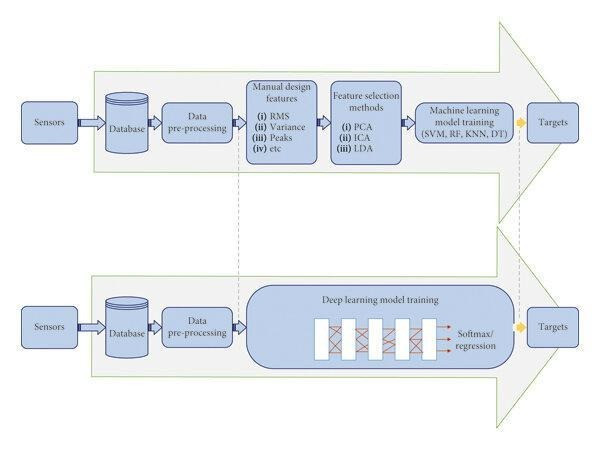
Figura 32: Visión general de las canalizaciones de entrenamiento para modelos ML/DL.
Applications of Ai in Maritime Cybersecurity
Sistemas de detección de intrusiones (IDS)
Un Sistema de Detección de Intrusiones (IDS) es una solución de seguridad diseñada para detectar accesos no autorizados, actividades maliciosas y amenazas potenciales mediante la monitorización continua del tráfico de red, el comportamiento de los usuarios y los registros del sistema. La ubicación de un IDS depende de su tipo. Un IDS basado en red (NIDS) suele colocarse entre el cortafuegos y la red interna, como se muestra en la Figura 33, donde inspecciona todo el tráfico entrante y saliente en busca de patrones sospechosos antes de que lleguen a sistemas críticos. Si un atacante evita el cortafuegos, el IDS detecta anomalías y genera una alerta para una investigación adicional. Por otro lado, un IDS basado en host (HIDS) se instala directamente en dispositivos individuales, como el sistema de navegación de un barco, servidores o estaciones de trabajo, donde monitoriza los registros del sistema, la integridad de los archivos y la actividad del usuario para detectar cambios maliciosos. En contextos marítimos, los IDS desempeñan un papel crucial en la protección de operaciones críticas como la gestión de carga, la navegación y las redes de comunicación (MarPoint, 2025).
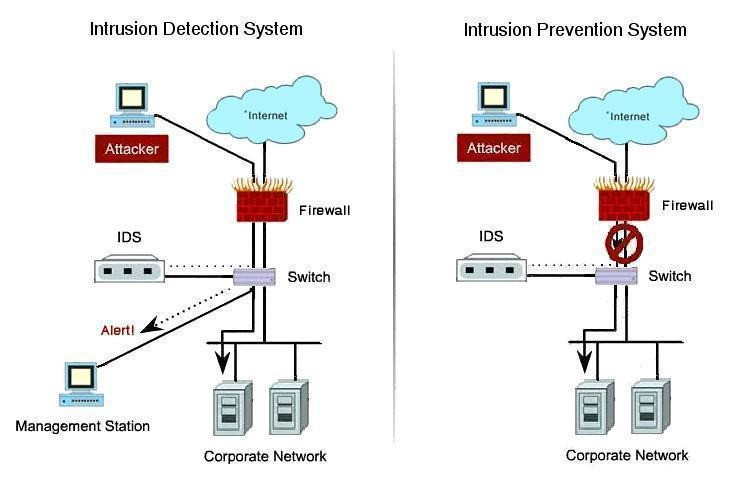
Figura 33: Sistema de detección de intrusiones
La ciencia de datos utiliza dos enfoques principales para detectar comportamientos maliciosos:
- Detección basada en firmas: Compara actividades observadas con una base de datos de firmas de ataque conocidas utilizando técnicas de coincidencia de cadenas. Este método es muy eficaz para identificar amenazas previamente conocidas, pero no detecta ataques nuevos o en evolución.
- Detección basada en el comportamiento: Monitoriza desviaciones respecto a los patrones normales de actividad, permitiéndole identificar amenazas nuevas o desconocidas. Aunque es más adaptativo, este método puede generar más falsos positivos.
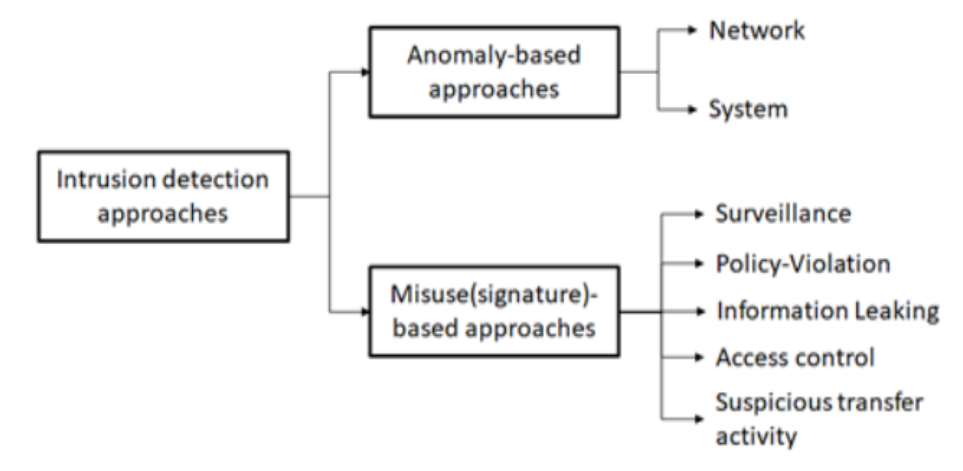
Figura 34: Clasificación de enfoques de detección de intrusiones.
El IDS impulsado por IA mejora la seguridad analizando los datos en tiempo real, identificando anomalías y distinguiendo patrones típicos de red de intrusiones dañinas. Al integrar tanto métodos supervisados, que dependen de firmas de ataque conocidas, como métodos no supervisados, que detectan desviaciones inusuales respecto a la actividad normal, los IDS basados en IA reducen las falsas alarmas y mejoran la precisión de la detección.
Los IDS impulsados por IA utilizan algoritmos de aprendizaje automático para detectar amenazas con mayor precisión. Estos algoritmos ayudan a IDS a reconocer tanto ciberataques conocidos como desconocidos.
- Aprendizaje supervisado: Este enfoque entrena un modelo de IA utilizando datos de ataques pasados etiquetados como "seguros" o "peligrosos". La IA aprende de estos datos y luego aplica sus conocimientos para detectar nuevas amenazas.
- Aprendizaje no supervisado: A diferencia del aprendizaje supervisado, este método no requiere datos etiquetados. En cambio, la IA identifica actividades inusuales detectando patrones que no coinciden con el comportamiento normal.
Un problema común con el IDS tradicional son los falsos positivos, donde la actividad de red inofensiva se marca erróneamente como amenaza. La IA reduce las falsas alarmas aprendiendo de errores anteriores y mejorando su precisión con el tiempo. La IA también puede combinar múltiples métodos de detección para mejorar los resultados. Al combinar detección basada en firmas y en comportamiento, el IDS impulsado por IA minimiza errores manteniendo una fuerte seguridad. Algunos modelos de IA incluso utilizan aprendizaje por refuerzo, una técnica en la que la IA ajusta continuamente sus reglas de detección basándose en la retroalimentación.
Dado que un IDS es un sistema pasivo, no toma acción directa contra amenazas detectadas. En su lugar, genera alertas para operadores humanos o se integra con sistemas de gestión de información y eventos de seguridad (SIEM) para un análisis y respuesta adicionales. Las intrusiones pueden originarse tanto de fuentes externas como internas, lo que convierte a la IDS en un componente esencial de las estrategias de ciberseguridad en distintos sectores.
Sistemas de Prevención de Intrusiones (IPS)
Un Sistema de Prevención de Intrusiones (IPS) es una tecnología de seguridad diseñada para detectar y prevenir de forma proactiva actividades maliciosas dentro de una red o sistema. A diferencia de un IDS, que monitoriza y alerta pasivamente cualquier actividad sospechosa, un IPS toma medidas directas para bloquear, mitigar o detener ataques en tiempo real. Esencialmente, aunque el IDS es una herramienta de monitorización, el IPS funciona como un sistema de control que previene activamente amenazas antes de que causen daño en operaciones como la navegación, la manipulación de carga o los enlaces de comunicación (Sowmya y Anita, 2023).
IPS suele desplegarse detrás de un cortafuegos pero antes de los sistemas internos, permitiéndole inspeccionar tanto el tráfico entrante como el saliente, como se muestra en la Figura 35. A diferencia de un cortafuegos, que filtra principalmente en función de reglas predefinidas, un IPS utiliza análisis avanzados para detectar y bloquear amenazas dinámicas en tiempo real. En algunas arquitecturas de red, IPS trabaja junto con IDS, donde IDS detecta y alerta a los administradores, mientras que IPS toma medidas activas para neutralizar amenazas.
Figura 35: Sistema de Prevención de Intrusiones
Acciones clave realizadas por un IPS:
- Enviando alertas a los administradores.
- Dejar caer paquetes potencialmente dañinos.
- Bloquear conexiones desde fuentes maliciosas.
- Reiniciar conexiones comprometidas para evitar una mayor explotación.
- IPS impulsado por IA para mejorar la seguridad
Las soluciones modernas de IPS aprovechan análisis impulsados por IA y fuentes de datos en tiempo real para detectar y bloquear amenazas de forma más eficaz. Al aprender continuamente de patrones de ataque históricos y emergentes, estos sistemas mejoran su precisión y reducen los falsos positivos. Al integrar análisis impulsados por IA con fuentes de datos en tiempo real, el IPS moderno mejora la seguridad al aislar los puntos finales infectados, bloquear direcciones IP maliciosas y modificar dinámicamente las reglas del firewall para evitar la propagación lateral de amenazas a través de las redes de buques y puertos (Maritime Intelligence, 2025). Un ejemplo notable de esto es la implementación de Cisco de un IPS basado en red, que detectó y mitigó eficazmente amenazas internas de red antes de que pudieran causar pérdida de datos o interrupciones en el servicio. Al analizar tanto el tráfico entrante como el saliente dentro de la empresa, el IPS de Cisco proporcionó una capa crítica de defensa, demostrando la eficacia del IPS mejorado por IA para neutralizar proactivamente las amenazas cibernéticas antes de que se intensificen (Contentree, 2025).
Sistemas de Detección y Prevención de Intrusiones de Código Abierto
A medida que las amenazas cibernéticas siguen evolucionando, los IDS y IPS de código abierto se han convertido en herramientas esenciales para monitorizar y proteger redes. Dos de las soluciones IDS/IPS de código abierto más utilizadas son Snort y Suricata, ambas ofrecen detección y prevención de amenazas en tiempo real, además de flexibilidad y personalización.
Snort: Un IDS/IPS basado en reglas
Snort, desarrollado originalmente por Martin Roesch en 1998, es un IDS/IPS basado en firmas capaz de realizar análisis de tráfico en tiempo real y registro de paquetes en redes IP. Utiliza un lenguaje basado en reglas que le permite integrar firmas, protocolos y técnicas de detección basadas en anomalías para identificar una amplia gama de amenazas cibernéticas, incluyendo ataques de denegación de servicio (DoS), desbordamientos de búfer, escaneos de puertos sigilosos y ataques CGI.
Snort funciona detectando paquetes de red usando librerías como libpcap y WinPcap y puede funcionar en tres modos principales:
- Modo de detección de paquetes – Captura y monitoriza el tráfico de red en bruto.
- Modo de registro de paquetes – Registra paquetes de red para su análisis y depuración.
- Modo de detección de intrusiones – Compara la actividad de la red con reglas predefinidas y envía alertas cuando se detectan amenazas.
Una ventaja clave de Snort es su lenguaje de reglas adaptable, que permite a los usuarios definir políticas de seguridad personalizadas. Se integra bien con cortafuegos para proporcionar una capa adicional de defensa, lo que lo convierte en una herramienta valiosa para la monitorización interna de la red.
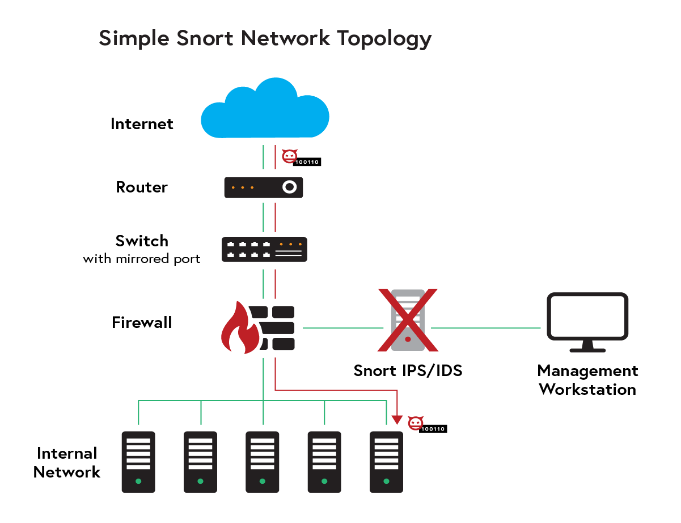
Figura 36: Topología simple de la red Snort.
Suricata: Monitorización de Seguridad de Redes (NSM) de Alto Rendimiento IDS/IPS
Suricata, desarrollado por la Open Information Security Foundation (OISF), es un IDS/IPS de nueva generación que amplía la monitorización tradicional de seguridad de red con inspección profunda de paquetes (DPI) y multihilo nativo. A diferencia de Snort, que se centra principalmente en la detección basada en firmas, Suricata puede analizar múltiples capas de protocolo (incluyendo HTTP, TLS, DNS y SMB) para detectar amenazas más sofisticadas y evasivas.
Una de sus principales ventajas es su capacidad para procesar tráfico de red a altas velocidades gracias a su arquitectura multihilo, lo que la hace muy adecuada para despliegues a nivel empresarial y entornos de seguridad en la nube. Además, se integra perfectamente con diversas herramientas de gestión de información y eventos de seguridad y plataformas de análisis de datos, permitiendo la visualización y análisis en tiempo real de posibles amenazas.
Otra característica única de Suricata es su funcionalidad de Monitorización de Seguridad de Red (NSM), que le permite extraer metadatos del tráfico de red además de detectar intrusiones. Esta capacidad ayuda a los equipos de ciberseguridad a investigar incidentes de seguridad de forma más eficaz, proporcionando una visión más profunda del comportamiento de la red.
Inspección profunda de paquetes para detección avanzada de amenazas
La Inspección Profunda de Paquetes (DPI) va más allá de examinar cabeceras de paquetes, analizando la carga útil y los metadatos de los datos transmitidos, proporcionando una visibilidad granular de los protocolos, el contenido de la capa de aplicación y el comportamiento definido por el usuario. A diferencia del filtrado tradicional de paquetes, que solo inspecciona las cabeceras IP y TCP/UDP, DPI examina todo el paquete, permitiéndole identificar cargas útiles maliciosas, violaciones de políticas o amenazas cifradas que los sistemas de filtrado más simples y solo de encabezado suelen pasar por alto (Leslie, 2020).
Un motor DPI opera inspeccionando el contenido de los paquetes en tiempo real, utilizando coincidencia basada en firmas, heurísticas y detección de anomalías para filtrar el tráfico. Puede clasificar paquetes según el protocolo, el tipo de aplicación y el contenido, lo cual es esencial para identificar amenazas ocultas en tráfico de red que parece legítimo. Por ejemplo, el DPI puede diferenciar entre tráfico HTTP normal y un ataque basado en HTTP, como la inyección SQL o la comunicación de malware por comandos y controles. DPI también es capaz de descifrar tráfico SSL/TLS para análisis de seguridad, asegurando que los paquetes cifrados no eludan los controles de seguridad. Muchos ciberataques modernos aprovechan cargas útiles cifradas para ocultar actividades maliciosas, pero el DPI impulsado por IA puede identificar anomalías de comportamiento incluso en sesiones cifradas, como patrones inusuales de transferencia de datos o tráfico a dominios maliciosos conocidos.
Cuando se combina con algoritmos de IA o aprendizaje automático, el DPI mejora la detección de amenazas aprendiendo de patrones de red pasados y detectando ataques de día cero o amenazas persistentes avanzadas que evaden las medidas de seguridad tradicionales.
Si se detecta una anomalía, los sistemas DPI pueden tomar acciones de respuesta automática, como aislar un punto final comprometido, terminar conexiones sospechosas o reconfigurar dinámicamente las reglas del firewall para evitar la propagación de malware a través de redes marítimas de TI y OT (Ipoque, 2025).
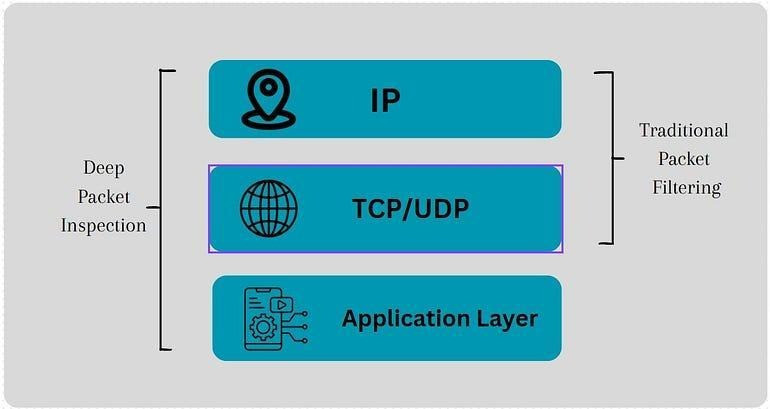
Figura 37: Comparación entre el filtrado tradicional de paquetes y la inspección profunda de paquetes
(Nethmal, 2025).
Redes Generativas Adversariales para la Ampliación de Datos y la Defensa
Las Redes Generativas Adversariales (GANs) consisten en dos redes neuronales en competencia: un generador que crea datos sintéticos y un discriminador que evalúa su autenticidad, como se muestra en la Figura 38. Originalmente desarrolladas para la síntesis de imágenes y la generación de deepfake, las GAN han demostrado ser muy efectivas en aplicaciones de ciberseguridad, especialmente en la detección de intrusiones, entrenamiento adversarial y análisis de malware. Al generar muestras de ataque altamente realistas, las GAN mejoran los modelos de seguridad basados en aprendizaje automático, permitiéndoles reconocer tanto amenazas conocidas como inéditas (Zhao, 2024).
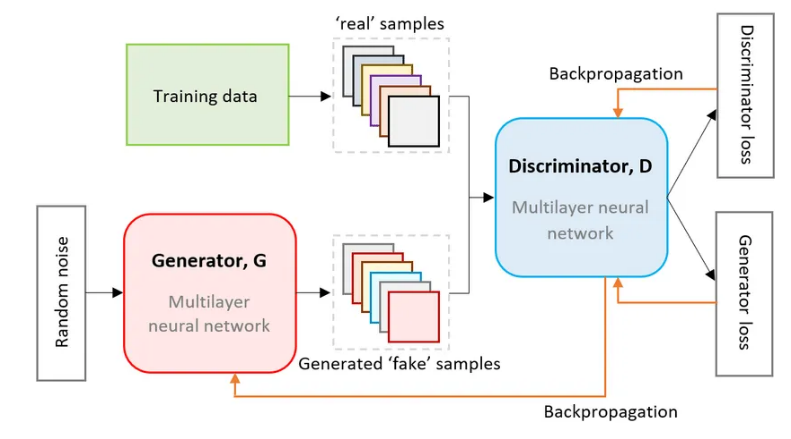
Figura 38: Arquitectura de una red GAN
(TVS, 2025).
Una de las aplicaciones de las Redes Generativas Antagónicas (GANs) en ciberseguridad es su capacidad para producir patrones de malware sintéticos o intentos de explotación, aumentando efectivamente los conjuntos de datos de entrenamiento para IDS e IPS. Las soluciones tradicionales IDS/IPS se basan en la detección basada en firmas, que luchan contra amenazas de día cero y malware polimórfico que evoluciona continuamente. Entrenando modelos IDS/IPS en muestras adversariales generadas por GAN, los sistemas de ciberseguridad pueden mejorar su resiliencia frente a estrategias de ataque previamente desconocidas. Las GAN también se han aplicado en pruebas de penetración automatizadas, donde generan variaciones de correos electrónicos de phishing, cargas útiles de ataque de fuerza bruta o scripts de exploit para probar la postura de seguridad de una organización. Al simular amenazas cibernéticas reales, las pruebas de penetración impulsadas por GAN permiten una evaluación continua de la seguridad sin exponer los sistemas a ataques reales.
Más allá de la detección de intrusiones, las GAN se utilizan ampliamente en la detección de anomalías. Un detector de anomalías basado en GAN primero aprende la distribución estadística del comportamiento normal de la red y luego detecta desviaciones sutiles que podrían indicar amenazas cibernéticas furtivas, malware ofuscado o intentos de exfiltración de datos. A diferencia de la detección tradicional de anomalías basada en reglas, las GAN se adaptan continuamente a nuevas condiciones de red, reduciendo los falsos positivos y mejorando la precisión de la detección. Esta capacidad para reconocer comportamientos anómalos es especialmente útil para detectar amenazas persistentes avanzadas que se mezclan con el tráfico legítimo.
Otro uso innovador de las GAN es en el entrenamiento adversarial, donde los modelos de ciberseguridad se fortalecen contra técnicas de ataques evasivos. Los atacantes suelen utilizar técnicas de aprendizaje automático adversarial para manipular modelos IDS/IPS, creando cargas útiles de ataque que eluden los mecanismos tradicionales de detección. Al entrenar a las GAN para simular ataques adversariales, las defensas de ciberseguridad pueden ser sometidas a pruebas de estrés y reforzadas, asegurando la robustez frente a ataques adversarios.
Detección de anomalías
Aunque los IDS suelen centrarse en tipos específicos de intrusiones, la detección de anomalías es una técnica más amplia que identifica cualquier comportamiento atípico o fuera de lugar, lo que podría señalar un fallo del sistema o una amenaza cibernética. Al monitorizar indicadores como el uso de recursos del sistema, la latencia de la red y los intentos de inicio de sesión, los algoritmos de detección de anomalías construyen una base de cómo es la actividad "normal". Cualquier variación importante de este patrón puede representar un problema de seguridad u operativo. En muchas aplicaciones marítimas, los sistemas de IA pueden iniciar contramedidas automatizadas, como aislar redes comprometidas o ajustar las reglas del cortafuegos para contener rápidamente amenazas potenciales (Ribeiro et al., 2023). Esta respuesta rápida y autónoma es vital en operaciones marítimas, donde pequeños incidentes pueden escalar rápidamente hasta convertirse en desafíos logísticos o de seguridad a gran escala si no se abordan de inmediato.
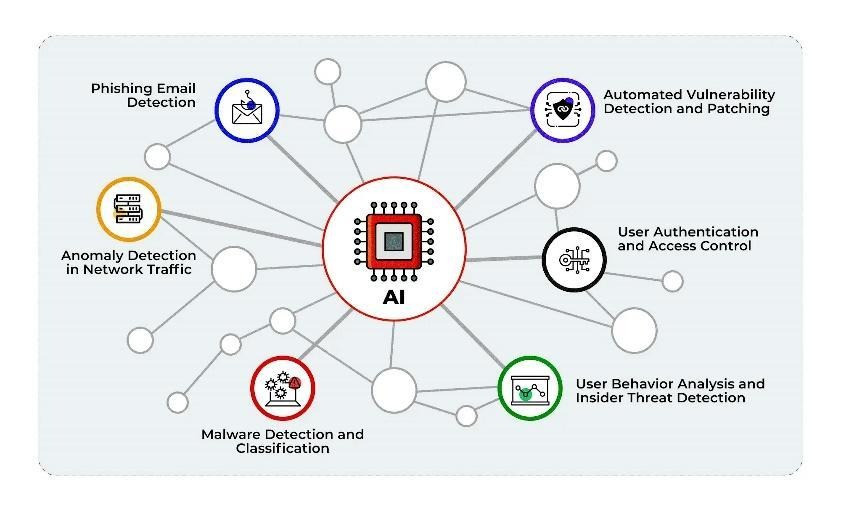
Figura 39: Aplicaciones de la detección de anomalías en ciberseguridad.
Análisis predictivo para amenazas cibernéticas
El análisis predictivo utiliza datos históricos y patrones de comportamiento para anticipar posibles debilidades y futuras estrategias de ataque, ofreciendo así una defensa cibernética proactiva. Al examinar grandes volúmenes de incidentes pasados, los modelos de IA pueden aislar factores que frecuentemente preceden a los ataques (Merrick, 2022). En la práctica, estos algoritmos simulan diversos escenarios de asalto para identificar puntos débiles, proporcionando a los equipos de seguridad una imagen clara de dónde deben asignar los recursos primero. Al asignar puntuaciones de riesgo a diferentes amenazas, los operadores marítimos pueden priorizar y fortalecer sus defensas para mantener seguros los sistemas críticos. Este enfoque no solo reduce los riesgos inmediatos, sino que también mejora la resiliencia a largo plazo frente a las amenazas cibernéticas en evolución (Meijer y Wessels, 2019). La analítica predictiva suele integrarse con sistemas de Información de Seguridad y Gestión de Eventos para correlacionar datos en tiempo real de múltiples fuentes, mejorando la precisión en la anticipación de amenazas. Cuando se combinan con Sistemas de Detección y Prevención de Intrusiones, estos modelos pueden activar medidas defensivas automatizadas para bloquear amenazas antes de que se materialicen.
Vulnerabilidades potenciales y ataques adversariales
Aunque la IA refuerza significativamente la ciberseguridad marítima, también introduce vulnerabilidades potenciales que los adversarios podrían intentar explotar. Los ataques adversariales consisten en alimentar datos cuidadosamente elaborados a modelos de IA, engañándolos para que hagan juicios incorrectos o ignoren amenazas reales (Qiu et al., 2019). Por ejemplo, los actores maliciosos podrían camuflar el malware para que un sistema de detección basado en IA lo clasifique erróneamente como benigno. Otro peligro es el envenenamiento por modelos, donde los atacantes inyectan información falsa o engañosa en los datos de entrenamiento, degradando gradualmente la precisión del modelo.
Para protegerse contra estas tácticas, las organizaciones marítimas suelen adoptar una serie de medidas de protección. Una es el reentrenamiento regular con datos verificados para garantizar su integridad, asegurando que el modelo siga siendo preciso y actualizado. El entrenamiento adversarial, en el que el modelo es expuesto deliberadamente a entradas engañosas durante el desarrollo, también le ayuda a aprender, identificar y resistir ataques manipulativos. Por último, canalizaciones de datos robustas y controles de acceso son esenciales para salvaguardar tanto el proceso de formación como el uso operativo de la IA, preservando las numerosas ventajas que aporta a la seguridad y eficiencia marítimas.
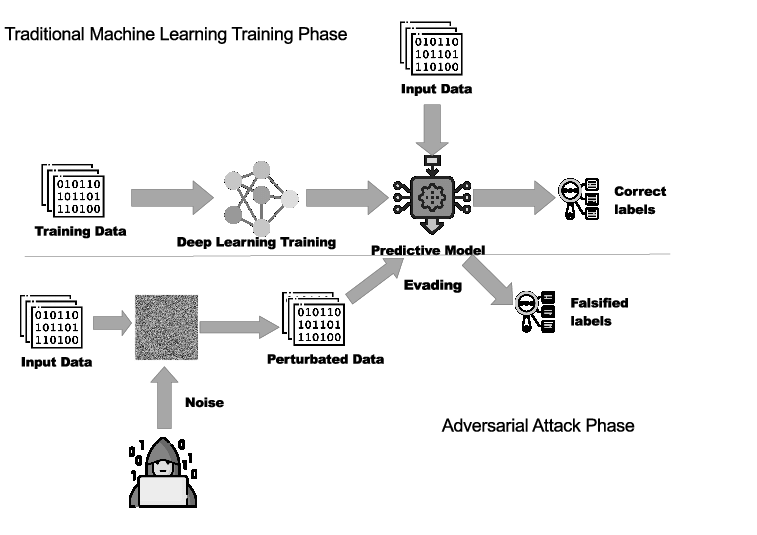
Figura 40: Ejemplo de un ataque adversarial
(Catak & Sule, (2020).
Retos y limitaciones de la IA
Los sistemas impulsados por IA ofrecen capacidades mejoradas para identificar y mitigar las amenazas cibernéticas, pero introducen una serie de desafíos y limitaciones que las organizaciones deben abordar para maximizar su eficacia.
Calidad y disponibilidad de los datos
Un problema importante tiene que ver con la calidad y disponibilidad de los datos. Dado que estos sistemas dependen en gran medida de grandes volúmenes de datos de alta calidad para entrenar y mejorar sus algoritmos de detección, cualquier inexactitud o carencia en esos datos puede llevar a predicciones erróneas o amenazas perdidas. Las organizaciones a menudo enfrentan dificultades al intentar integrar datos de múltiples segmentos de red y fuentes dispares (Palo Alto Networks, 2025). Esto puede resultar en una visión incompleta de las actividades del usuario y del comportamiento del sistema, creando lagunas en la detección de amenazas.
Falsos positivos y fatiga por alerta
Otro desafío surge del alto volumen de falsos positivos. Aunque la IA pretende reducir estas alertas erróneas, aún puede generar una avalancha de avisos que saturan a los equipos de seguridad. Esta situación puede causar fatiga de alertas, donde el personal de seguridad comienza a pasar por alto alertas potencialmente significativas debido al constante flujo de notificaciones de bajo riesgo (Olateju et al., 2024). Gestionar e investigar estas numerosas alertas requiere un tiempo y recursos considerables, lo que podría desviar la atención de amenazas legítimas.
Complejidad y falta de interpretabilidad
La complejidad y la interpretabilidad suponen obstáculos adicionales. Las técnicas modernas de IA, especialmente el deep learning, pueden producir resultados mediante procesos de toma de decisiones opacos. A los analistas de seguridad les puede resultar difícil confiar o actuar ante las alertas cuando no pueden entender cómo o por qué el modelo de IA llegó a una conclusión concreta (Digital Leaders, 2025). Por ello, garantizar que el sistema proporcione explicaciones y justificaciones claras es fundamental para generar confianza en las herramientas de seguridad impulsadas por IA.
Integración con sistemas existentes
En muchas organizaciones, la integración con los sistemas existentes es todo menos fluida. Los sistemas impulsados por IA deben funcionar perfectamente con la infraestructura de seguridad existente de una organización, lo que puede implicar problemas de compatibilidad y requerir una amplia experiencia técnica. Los sistemas heredados a menudo necesitan actualizaciones antes de poder manejar las demandas de procesamiento de datos y análisis avanzados de la IA. Estos requisitos no solo aumentan la complejidad del despliegue, sino que también generan costes adicionales y plazos adicionales para su implementación.
Vulnerabilidad a ataques adversariales
Los propios modelos de IA pueden ser vulnerables a ataques adversariales, donde actores maliciosos manipulan deliberadamente las entradas para engañar al sistema. Esto incluye introducir patrones o señales engañosas que hacen que la IA clasifique erróneamente amenazas o conceda accesos no autorizados. Mitigar estos ataques requiere una monitorización y actualizaciones constantes para garantizar que los modelos sigan siendo robustos frente a la evolución de las técnicas adversariales (MetaCompliance, 2025).
Sesgo en los modelos de IA
El sesgo dentro de los modelos de IA es otra preocupación. Si los datos de entrenamiento están sesgados o reflejan ciertos prejuicios, el IDS podría señalar injustamente grupos específicos, tipos de actividades o comportamientos de los usuarios. Esto puede conducir no solo a problemas éticos, sino también a resultados de seguridad subóptimos, ya que un enfoque sesgado puede hacer que el sistema pase por alto amenazas más amplias (ISC², 2024). Por ello, identificar y mitigar el sesgo es crucial para garantizar la equidad y mantener la integridad del proceso de detección.
Desafíos regulatorios y de cumplimiento
Los requisitos regulatorios y de cumplimiento introducen otra capa de complejidad. Muchas industrias, incluido el sector marítimo, deben cumplir estrictas leyes de privacidad de datos y ciberseguridad para garantizar un manejo seguro de los datos de usuarios, clientes y operativos. Las soluciones impulsadas por IA deben generar pistas de auditoría claras y ofrecer suficiente transparencia para demostrar el cumplimiento durante las auditorías, añadiendo cargas administrativas y técnicas al proceso de implementación (Ethico, 2024). El cumplimiento de marcos como el Marco de Ciberseguridad del NIST, ISO 27001 y las directrices de ENTISA, entre otros, es fundamental para garantizar un despliegue seguro y legal de sistemas de ciberseguridad mejorados con IA.
Altos costes de implementación y mantenimiento
El coste también es una consideración importante. Los gastos iniciales para hardware especializado, licencias de software y servicios profesionales pueden ser elevados, y el mantenimiento, las actualizaciones y la reformación de modelos continuos implican un gasto continuo. Como resultado, las organizaciones más pequeñas pueden tener dificultades para justificar o costear la inversión a largo plazo necesaria para desplegar y mantener capacidades impulsadas por IA a gran escala (Modern Diplomacy, 2024).
Escasez de profesionales cualificados
Además, a menudo existe una carencia notable en la experiencia necesaria para gestionar sistemas de seguridad basados en IA. A las organizaciones puede resultar difícil reclutar o formar suficientes profesionales con conocimientos de IA y experiencia en seguridad. Mantener al personal informado sobre las técnicas de IA en rápida evolución y las amenazas de ciberseguridad exige un compromiso con programas continuos de educación y formación (Technology Magazine, 2024).
Preocupaciones sobre la privacidad
Por último, las preocupaciones sobre la privacidad cobran protagonismo al utilizar IDS impulsado por IA para monitorizar el comportamiento de los usuarios. Recopilar y analizar información tan detallada puede entrar en conflicto con las leyes de protección de datos si no se maneja con cuidado. Las organizaciones deben asegurarse de que los datos de los usuarios se recopilen, almacenen y procesen de manera que respeten los derechos de privacidad de las personas y cumplan con normativas como el RGPD (Stewart, 2024). Lograr este equilibrio requiere obtener el consentimiento del usuario, establecer claramente las políticas de monitorización y mantener prácticas rigurosas de gobernanza de datos.
Al abordar estos desafíos, desde la calidad de los datos y los falsos positivos hasta la interpretabilidad, el coste, el sesgo, las carencias de habilidades y las preocupaciones sobre la privacidad, las organizaciones pueden aprovechar todo el potencial de las soluciones impulsadas por IA, manteniendo al mismo tiempo un sólido cumplimiento de seguridad y normativas.
En resumen, la IA está transformando la ciberseguridad marítima mejorando la detección de amenazas, previniendo ciberataques y optimizando las operaciones de los buques. A través del aprendizaje automático y el deep learning, sistemas impulsados por IA como IDS, IPS y DPI ayudan a monitorizar, analizar y responder a riesgos de seguridad en tiempo real. El análisis predictivo refuerza aún más las defensas cibernéticas al identificar vulnerabilidades antes de que ocurran los ataques. Sin embargo, la adopción de la IA conlleva desafíos, incluyendo ataques adversariales, sesgos y complejidades de integración. Para garantizar la resiliencia, son esenciales los avances continuos en estrategias de seguridad de IA, como el entrenamiento adversarial, la mejora del cumplimiento normativo y los modelos de aprendizaje adaptativo. A medida que evolucionan las amenazas cibernéticas, la IA desempeñará un papel cada vez más vital en la protección de las operaciones marítimas mientras mejora la eficiencia y seguridad operativa.


