
Completion requirements
Nowe technologie i przyszłe wyzwania
5. AI w cyberbezpieczeństwie morskim i analizie predykcyjnej
Cyberbezpieczeństwo stało się kluczowym zagadnieniem dla ochrony istotnych funkcji, takich jak nawigacja, zarządzanie ładunkiem oraz sieci komunikacyjne. Sztuczna inteligencja (AI) wyłoniła się jako potężne narzędzie do sprostania tym wyzwaniom bezpieczeństwa. Analizując ogromne ilości danych, systemy AI mogą dokładniej wykrywać zagrożenia, przyspieszać reakcje oraz ograniczać zakłócenia operacyjne (Kaur i in., 2023). Niniejszy dokument przedstawia przegląd sztucznej inteligencji, uczenia maszynowego (ML) oraz uczenia głębokiego (DL), omawia cykle życia modeli uczenia maszynowego oraz wskazuje, w jaki sposób technologie te mogą wzmocnić cyberbezpieczeństwo morskie i efektywność operacyjną.
Poza wykrywaniem ataków, AI poprawia również wydajność statków i efektywność energetyczną poprzez analizę danych z czujników okrętowych w celu przewidywania potencjalnych awarii mechanicznych, zanim one wystąpią (Tu i in., 2018). Technika ta pomaga planować naprawy w najbardziej opłacalnych momentach i zapobiega nieoczekiwanym awariom. Ponadto AI może dynamicznie modyfikować prędkość i trasę statku w zależności od warunków pogodowych, obciążenia ładunkiem lub zużycia paliwa, co ostatecznie obniża koszty operacyjne i zmniejsza wpływ na środowisko.
Kolejnym kluczowym zastosowaniem jest nadzór wizualny oparty na AI, który wzmacnia bezpieczeństwo morskie poprzez monitorowanie działań na pokładzie pod kątem nieautoryzowanego dostępu lub nietypowych zachowań (Şengönül i in., 2023). Modele uczenia głębokiego, takie jak konwolucyjne sieci neuronowe, mogą rozpoznawać anomalie w obsłudze ładunku lub wykrywać wejścia personelu do stref o ograniczonym dostępie. Przykładowo, systemy robotyczne mogą bezpiecznie i efektywnie usuwać towary z kontenerów, które docierają w losowej kolejności, zmniejszając ryzyko pracy ręcznej i poprawiając dokładność operacyjną (Mojtahedzadeh i in., 2015).
Podstawy AI, ML i DL
Sztuczna inteligencja (Artificial Intelligence, AI) jest szeroką dziedziną informatyki, skoncentrowaną na tworzeniu systemów zdolnych do wykonywania zadań, które zwykle wymagają ludzkiej inteligencji, takich jak rozumienie języka, rozpoznawanie wzorców czy podejmowanie decyzji. Wczesne badania nad AI w dużym stopniu opierały się na tzw. systemach opartych na regułach („rule-based”), w których eksperci zapisywali szczegółowe zestawy instrukcji typu JEŻELI–WÓWCZAS, jak pokazano na rysunku 22. Na przykład reguła cyberbezpieczeństwa mogła brzmieć: „JEŻELI komputer zarejestruje wiele nieudanych prób logowania, WÓWCZAS tymczasowo zablokuj użytkownika”. Takie systemy sprawdzają się dobrze w sytuacjach, w których reguły można jasno zdefiniować, jednak mogą mieć trudności w obliczu nowych lub nieoczekiwanych problemów.
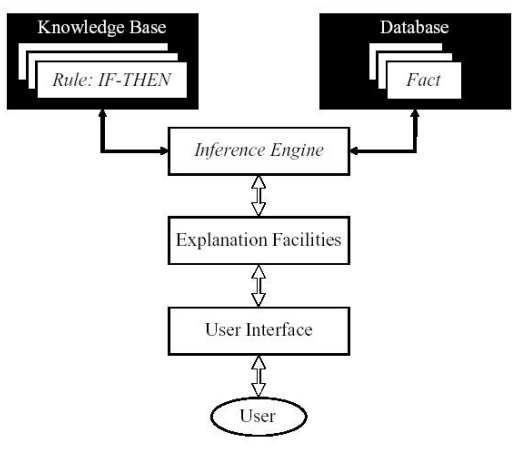
Rysunek 23: Struktura systemów sztucznej inteligencji opartych na regułach
(Mojtahedzadeh et al., 2015)
Współczesna sztuczna inteligencja wykracza poza poleganie wyłącznie na ręcznie tworzonych regułach. Zamiast tego wykorzystuje techniki takie jak uczenie maszynowe (Machine Learning, ML), które umożliwiają komputerom uczenie się na podstawie danych bez konieczności jawnego programowania każdego możliwego scenariusza. Zamiast definiować instrukcje dla każdej sytuacji, dostarcza się systemowi ogromne ilości informacji, pozwalając mu analizować wzorce i podejmować własne decyzje. Proces ten odzwierciedla sposób, w jaki ludzie uczą się poprzez doświadczenie – obserwując liczne przykłady, rozpoznając zależności i stopniowo doskonaląc swoje rozumienie.
W operacjach morskich, na przykład, ML może analizować dane z systemów śledzenia GPS w celu wykrywania nietypowych ruchów statków, które mogą wskazywać na nieautoryzowany dostęp lub zagrożenia piractwem. Dzięki ciągłemu uczeniu się na podstawie danych lokalizacyjnych w czasie rzeczywistym oraz wcześniejszych incydentów, AI może rozpoznawać odchylenia od normalnych tras lub zachowań, uruchamiając alerty, zanim potencjalne zagrożenia bezpieczeństwa eskalują. Z czasem modele ML udoskonalają swoje prognozy i dostosowują się do nowych przypadków, stając się coraz skuteczniejsze w radzeniu sobie ze złożonymi i dynamicznie zmieniającymi się problemami bez konieczności bezpośredniej ingerencji człowieka przy każdej decyzji.
W ramach uczenia maszynowego istnieją różne sposoby uczenia się. W jednym z podejść, często określanym jako uczenie nadzorowane (supervised learning), systemowi prezentuje się przykłady, które mają już przypisane odpowiedzi lub etykiety. Z czasem system uczy się, jak te odpowiedzi odnoszą się do poszczególnych przykładów, tak aby móc przewidywać wyniki dla nowych, wcześniej niewidzianych danych. W zależności od rodzaju problemu, uczenie nadzorowane może być wykorzystywane do klasyfikacji, gdzie celem jest przypisanie punktów danych do określonych kategorii, na przykład rozpoznanie, czy komunikacja statku jest legalna, czy stanowi potencjalne zagrożenie cybernetyczne. Może być ono również stosowane do regresji, w której model przewiduje wartości ciągłe, takie jak szacowanie zużycia paliwa na podstawie prędkości, masy ładunku i warunków pogodowych.
W innym podejściu, znanym jako uczenie nienadzorowane (unsupervised learning), system pracuje z danymi nieposiadającymi etykiet, dlatego musi samodzielnie odkrywać ukryte wzorce, na przykład poprzez grupowanie podobnych elementów. Jest to szczególnie przydatne w cyberbezpieczeństwie morskim podczas analizy ruchu sieciowego w celu wykrywania anomalii, które mogą wskazywać na cyberataki, ponieważ system może klastrować normalne i nienormalne zachowania bez wcześniejszej wiedzy o tym, jak wygląda atak.
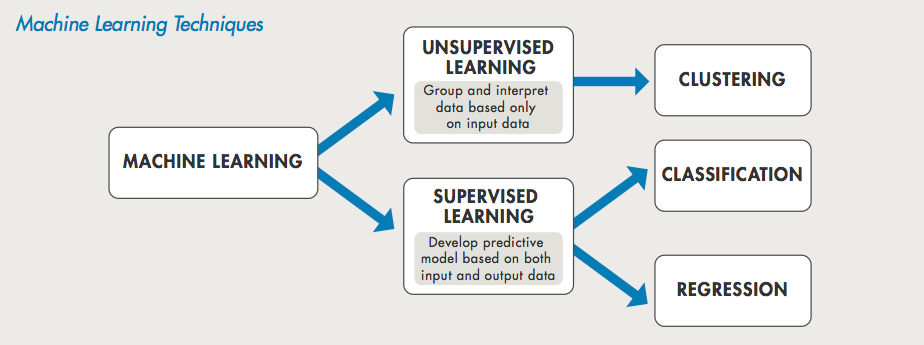
Rysunek 24: Techniki uczenia maszynowego
Trzecie podejście, nazywane uczeniem ze wzmocnieniem (reinforcement learning, RL), polega na uczeniu się metodą prób i błędów. W przeciwieństwie do uczenia nadzorowanego, w którym system otrzymuje oznaczone przykłady poprawnych odpowiedzi, uczenie ze wzmocnieniem działa w środowisku, w którym system musi samodzielnie odkryć optymalne zachowanie poprzez interakcję. System, często określany jako „agent”, podejmuje różne działania w danym środowisku i otrzymuje informację zwrotną w postaci nagród lub kar. Nagroda sygnalizuje, że dana akcja była pożądana, natomiast kara wskazuje na działanie niepożądane. Celem agenta jest nauczenie się „polityki”, czyli odwzorowania stanów (aktualnej sytuacji, w której znajduje się agent) na działania, które maksymalizują skumulowaną nagrodę w czasie.
Przykładowo, w sterowaniu robotami RL może być wykorzystane do nauczenia robota chodzenia. Robot rozpoczyna od wykonywania losowych kroków, otrzymując informację zwrotną na podstawie stabilności, efektywności energetycznej oraz ruchu do przodu. W trakcie wielu iteracji uczy się dostosowywać ruchy swoich stawów tak, aby chodzić coraz efektywniej, poprawiając równowagę i minimalizując zużycie energii (Song et al., 2021).
Uczenie głębokie (Deep Learning) stanowi kolejny krok w rozwoju sztucznej inteligencji, próbując naśladować sposób, w jaki ludzki mózg przetwarza informacje. U jego podstaw leżą sztuczne sieci neuronowe, które są strukturalnie podobne do neuronów biologicznych i umożliwiają automatyczne uczenie się oraz rozpoznawanie wzorców w ogromnych zbiorach danych. W przeciwieństwie do tradycyjnego uczenia maszynowego, w którym człowiek często musi ręcznie wybierać i definiować najbardziej istotne cechy dla działania modelu, modele uczenia głębokiego samodzielnie wydobywają te cechy, interpretując surowe dane bez jawnego programowania. System sam określa, które aspekty danych są najważniejsze, co pozwala mu identyfikować wzorce i podejmować decyzje przy minimalnej ingerencji człowieka.
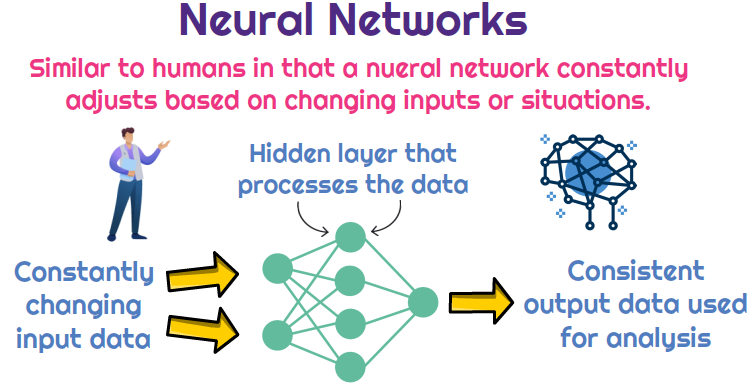
Rysunek 25: Adaptacyjne systemy uczące się przetwarzające zmienne dane wejściowe w celu generowania spójnych danych wyjściowych do analizy .
Podobnie jak ludzki mózg posiada wyspecjalizowane obszary odpowiedzialne za różne zadania, modele uczenia głębokiego są projektowane z architekturami skoncentrowanymi na określonych typach danych. Na przykład podczas przetwarzania informacji wizualnych kora wzrokowa mózgu rozpoznaje obiekty poprzez wykrywanie krawędzi, kształtów i tekstur, zanim powstanie pełny obraz. Inspirowane tym podejściem, konwolucyjne sieci neuronowe (Convolutional Neural Networks, CNN) (Jorgecardete, 2025) są zaprojektowane do realizacji zadań związanych z analizą obrazu, automatycznie ucząc się istotnych cech z obrazów bez potrzeby ręcznego wprowadzania danych. Na przykład CNN mogą być wykorzystywane do rozpoznawania mimiki twarzy poprzez analizę obrazów twarzy i identyfikowanie emocji takich jak złość, radość czy zaskoczenie. Zamiast wymagać od człowieka ręcznego definiowania, jak wygląda każda emocja, model uczy się wzorców na podstawie analizy tysięcy obrazów twarzy. Poprzez warstwy konwolucyjne i warstwy próbkowania (pooling) wydobywa on istotne cechy, takie jak ruchy mięśni twarzy i ekspresje, które następnie są przetwarzane przez warstwy w pełni połączone i klasyfikowane za pomocą funkcji SoftMax w celu określenia najbardziej prawdopodobnej emocji.
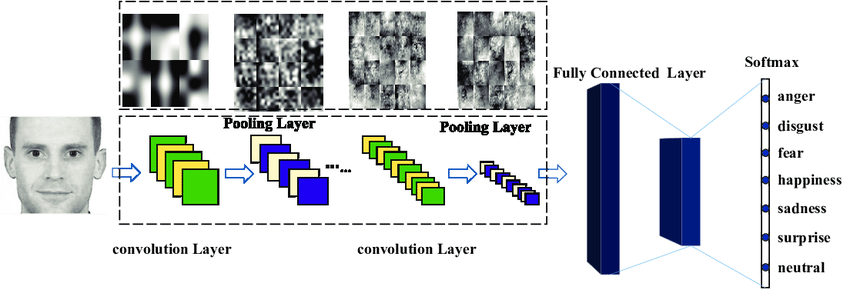
Rysunek 26: Schemat rozpoznawania emocji twarzy oparty na uczeniu głębokim.
Pamięć oraz przetwarzanie sekwencji w ludzkim mózgu odgrywają kluczową rolę w podejmowaniu decyzji i rozpoznawaniu wzorców, co znajduje odzwierciedlenie w modelach uczenia głębokiego takich jak rekurencyjne sieci neuronowe (Recurrent Neural Networks, RNN) oraz sieci Long Short-Term Memory (LSTM). Sposób, w jaki ludzie zapamiętują wcześniejsze doświadczenia i wykorzystują je do wpływania na bieżące decyzje, jest tym, co modele te starają się odtworzyć. Są one szczególnie skuteczne w pracy z danymi sekwencyjnymi, takimi jak język naturalny, prognozowanie szeregów czasowych czy analiza ruchu sieciowego.
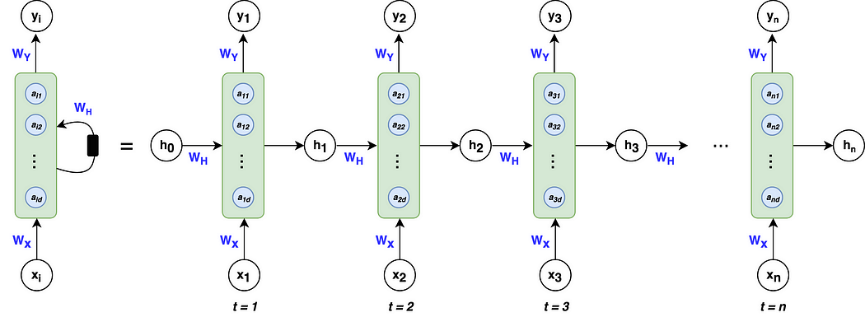
Rysunek 27: Architektura prostej rekurencyjnej sieci neuronowej
(Khuong, 2025)
Przetwarzanie języka jest kolejną dziedziną, w której uczenie głębokie osiąga znakomite wyniki, naśladując sposób, w jaki ludzki mózg interpretuje i generuje mowę. Modele oparte na architekturze transformerów, takie jak BERT i GPT, analizują ogromne ilości tekstu, ucząc się rozumienia wzorców językowych bez konieczności definiowania z góry reguł gramatycznych. W kontekście cyberbezpieczeństwa morskiego modele takie mogą skanować wiadomości e-mail, komunikację radiową oraz logi systemowe w celu wykrywania prób phishingu, fałszywych komunikatów lub nieautoryzowanych poleceń podszywających się pod normalną komunikację. Zamiast opierać się na prostym wykrywaniu słów kluczowych, modele te rozumieją kontekst i intencję, co czyni je bardzo skutecznymi w identyfikowaniu subtelnych zagrożeń, które tradycyjne systemy oparte na regułach mogłyby przeoczyć.
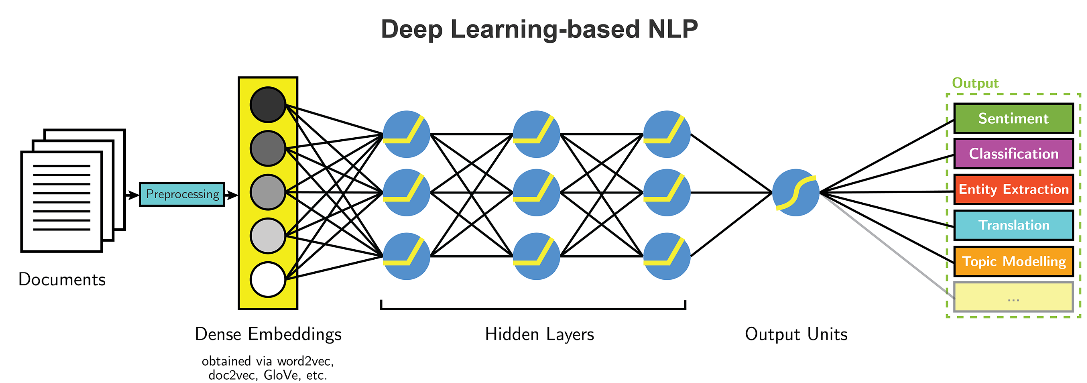
Rysunek 28: Przetwarzanie języka naturalnego oparte na uczeniu głębokim.
Podstawową siłą uczenia głębokiego jest jego zdolność do automatycznego uczenia się istotnych cech z ogromnych ilości nieustrukturyzowanych danych. W przeciwieństwie do tradycyjnych podejść uczenia maszynowego, w których eksperci muszą ręcznie projektować cechy (czyli decydować, które aspekty danych są istotne), modele uczenia głębokiego potrafią samodzielnie identyfikować te cechy, jak pokazano na Rysunku 28. Niezależnie od tego, czy dane obejmują obrazy, logi sieciowe, odczyty sensorów czy tekst, system analizuje liczne przykłady, stopniowo udoskonalając swoje rozumienie i autonomicznie identyfikując najbardziej informacyjne wzorce. Eliminuje to potrzebę ręcznego projektowania cech – procesu, który jest czasochłonny, wymaga specjalistycznej wiedzy dziedzinowej i może nie wychwycić wszystkich niuansów ukrytych w danych.
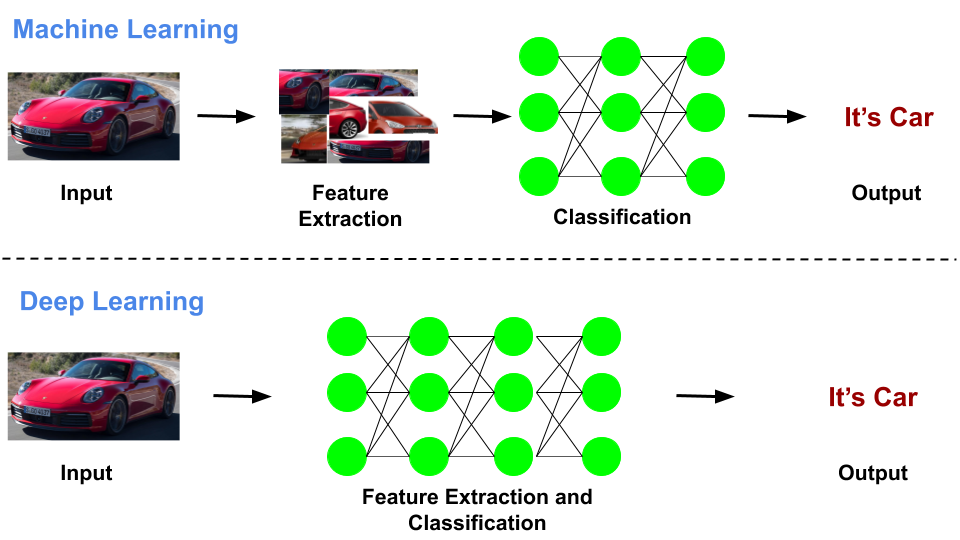
Rysunek 29: Różnice między potokiem uczenia maszynowego a głębokiego uczenia.
W przemyśle morskim sztuczna inteligencja może być integrowana z systemami cyberbezpieczeństwa w celu przetwarzania ogromnych ilości danych generowanych przez statki, porty oraz łącza satelitarne. W miarę jak zagrożenia ewoluują, modele uczenia maszynowego (ML) i uczenia głębokiego (DL) mogą na bieżąco aktualizować się w oparciu o nowe informacje, identyfikując ryzyka lub ataki, które nigdy nie zostałyby jednoznacznie opisane przez reguły zapisane przez człowieka. Ta zdolność do adaptacji i ciągłego doskonalenia w czasie jest tym, co czyni AI tak wartościowym narzędziem w radzeniu sobie ze współczesnymi wyzwaniami cyberbezpieczeństwa. Rysunek 29 przedstawia wysokopoziomowy przegląd zastosowań sztucznej inteligencji w cyberbezpieczeństwie.
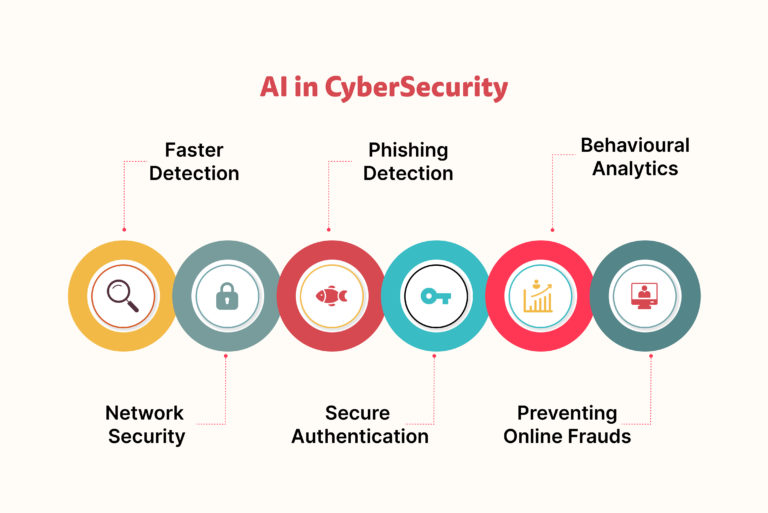
Rysunek 30: Zastosowania sztucznej inteligencji w cyberbezpieczeństwie.
Rozwój modeli uczenia maszynowego i uczenia głębokiego
Proces tworzenia modelu uczenia maszynowego lub uczenia głębokiego przebiega według uporządkowanej sekwencji etapów – od pozyskania danych aż po wdrożenie i utrzymanie modelu. Każdy z tych etapów odgrywa kluczową rolę w zapewnieniu, że system będzie w stanie generować dokładne i wiarygodne predykcje w rzeczywistych warunkach operacyjnych. Poniżej przedstawiono szczegółowy opis całego potoku procesu, wraz z wyjaśnieniami ułatwiającymi zrozumienie osobom niezaznajomionym z tą dziedziną.
Pozyskiwanie danych: gromadzenie istotnych informacji
Pierwszym krokiem w każdym projekcie uczenia maszynowego (ML) lub uczenia głębokiego (DL) jest pozyskanie danych. Bez danych wysokiej jakości nawet najlepsze algorytmy będą miały trudności z uzyskaniem użytecznych wyników. Dane mogą pochodzić z różnych źródeł, w zależności od rozwiązywanego problemu. W przypadku cyberbezpieczeństwa morskiego istotne dane mogą obejmować na przykład logi ruchu sieciowego, rejestry zdarzeń bezpieczeństwa oraz metryki wydajności systemów. Logi sieciowe rejestrują komunikację pomiędzy urządzeniami, pomagając identyfikować nietypowe wzorce, które mogą wskazywać na zagrożenia cybernetyczne. Logi zdarzeń bezpieczeństwa zawierają alerty generowane przez systemy cyberbezpieczeństwa w momencie wykrycia podejrzanej aktywności. Dane dotyczące wydajności systemu, takie jak wykorzystanie procesora (CPU) czy pamięci, mogą dostarczyć informacji o potencjalnych naruszeniach bezpieczeństwa lub awariach. Rodzaj zbieranych danych zależy całkowicie od konkretnego problemu, który model ma rozwiązywać. Na przykład do wykrywania włamań mogą być potrzebne dane sieciowe na poziomie pakietów, natomiast do nadzoru statków bardziej odpowiednie będzie wideo w czasie rzeczywistym.
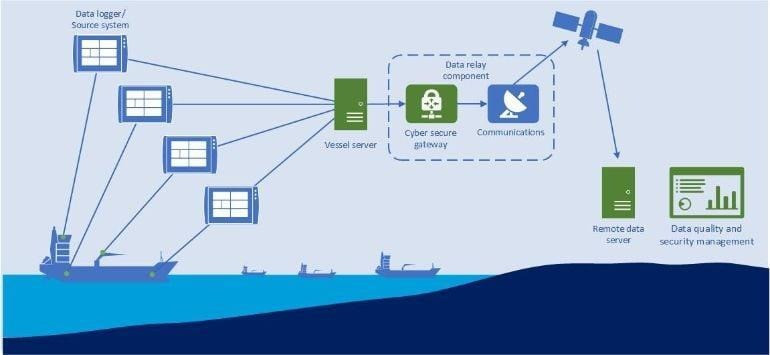
Rysunek 31: Przykład pozyskiwania danych w sektorze morskim.
Przygotowanie danych: czyszczenie i formatowanie danych do analizy
Surowe dane są często nieustrukturyzowane, niespójne lub zawierają błędy, które mogą negatywnie wpłynąć na wydajność modelu. Aby dane nadawały się do użycia, muszą przejść przez etap przygotowania. Proces ten obejmuje kilka kluczowych kroków, w tym obsługę brakujących wartości, usuwanie szumów oraz standaryzację danych wejściowych. Brakujące wartości mogą występować z powodu wadliwych czujników lub niekompletnych logów i muszą zostać obsłużone poprzez ich uzupełnienie wartościami szacowanymi lub usunięcie niekompletnych rekordów. Szumy, takie jak uszkodzone punkty danych lub informacje nieistotne, muszą zostać usunięte, aby zapobiec uczeniu się przez model błędnych wzorców. Standaryzacja jest kolejnym kluczowym krokiem, ponieważ dane często występują w różnych formatach lub jednostkach. Na przykład znaczniki czasu w logach sieciowych mogą wymagać konwersji do jednej strefy czasowej, a wartości liczbowe mogą wymagać normalizacji, aby znalazły się na porównywalnej skali. W przypadku danych strukturalnych, takich jak tabele aktywności sieciowej, etap ten może również obejmować usuwanie zduplikowanych wpisów. Dla danych nieustrukturyzowanych, takich jak obrazy czy tekst, wstępne przetwarzanie może obejmować zmianę rozmiaru obrazów, redukcję szumów tła lub konwersję słów na reprezentacje numeryczne, które model jest w stanie przetwarzać.
Inżynieria cech: identyfikowanie lub tworzenie znaczących wzorców
W tradycyjnym uczeniu maszynowym modele nie „wiedzą” same z siebie, które aspekty danych są istotne. Zamiast tego eksperci muszą ręcznie zdefiniować cechy najbardziej użyteczne do rozwiązania danego problemu. Proces ten, znany jako inżynieria cech, polega na wyborze, transformacji lub tworzeniu nowych zmiennych na podstawie surowych danych w celu poprawy wydajności modelu. Skuteczna inżynieria cech może znacząco zwiększyć dokładność modelu poprzez dostarczenie mu istotnych informacji. Na przykład w systemie wykrywania włamań surowe logi ruchu sieciowego mogą zawierać takie dane jak adresy IP, znaczniki czasu, rozmiary pakietów czy statusy połączeń. Same te wartości mogą jednak nie być wystarczająco informacyjne. Aby poprawić skuteczność wykrywania, ekspert może stworzyć nowe cechy oparte na wzorcach statystycznych lub trendach behawioralnych. Jedną z takich cech może być tempo prób połączeń, mierzące liczbę żądań połączenia z określonego adresu IP w danym oknie czasowym, na przykład 10 sekund. Nagły wzrost liczby prób połączeń może wskazywać na atak typu brute force.
Uczenie głębokie w dużej mierze eliminuje potrzebę inżynierii cech. Zamiast polegać na ludzkiej intuicji przy definiowaniu istotnych cech, głębokie sieci neuronowe automatycznie uczą się wzorców bezpośrednio z surowych danych. Jest to jedna z głównych zalet DL w porównaniu z tradycyjnym ML. Umożliwia ono przetwarzanie danych nieustrukturyzowanych, takich jak obrazy, dźwięk czy tekst, bez konieczności jawnego definiowania reguł ekstrakcji cech. Przykładowo, w rozpoznawaniu obrazów konwolucyjna sieć neuronowa może nauczyć się wykrywać krawędzie, tekstury i złożone obiekty bez ingerencji człowieka, co czyni ją bardzo skuteczną w analizie obrazu z monitoringu statków w czasie rzeczywistym.
Wybór modelu: dobór odpowiedniego algorytmu
Po przygotowaniu danych kolejnym krokiem jest wybór najlepszego modelu do danego problemu. Wybór algorytmu zależy od takich czynników jak typ danych, złożoność zadania oraz dostępne zasoby obliczeniowe. W tradycyjnym uczeniu maszynowym często stosuje się modele takie jak drzewa decyzyjne, maszyny wektorów nośnych (SVM) czy lasy losowe, szczególnie przy pracy z danymi strukturalnymi. Modele te wymagają ręcznie zdefiniowanych cech, ale mogą działać skutecznie nawet przy stosunkowo niewielkich zbiorach danych.
Modele uczenia głębokiego są z kolei bardziej zaawansowane, ale wymagają dużych ilości danych i znacznych zasobów obliczeniowych. Sieci CNN są szczególnie skuteczne w zadaniach związanych z obrazami, takich jak wykrywanie obiektów w morskich nagraniach nadzoru. Rekurencyjne sieci neuronowe lub modele typu transformer lepiej nadają się do danych sekwencyjnych, takich jak analiza logów komunikacyjnych w czasie w celu wykrywania wzorców zagrożeń cybernetycznych. Wybór odpowiedniego modelu jest kluczowy, ponieważ niewłaściwa decyzja może prowadzić do słabych wyników lub nieefektywnego wykorzystania zasobów.
Trenowanie modelu: uczenie się na podstawie danych
Po wyborze modelu kolejnym krokiem jest jego trenowanie, czyli nauczenie go generowania predykcji. Proces trenowania polega na dostarczaniu danych do modelu, umożliwieniu mu uczenia się wzorców oraz dostrajaniu jego parametrów wewnętrznych w celu poprawy dokładności. Model generuje początkowe predykcje, a funkcja straty mierzy, jak bardzo odbiegają one od poprawnych odpowiedzi. Wysoka wartość straty oznacza słabe predykcje. Aby je poprawić, proces optymalizacji, taki jak spadek gradientowy, aktualizuje parametry modelu (wagi), stopniowo redukując wartość straty. Ten iteracyjny proces trwa, aż model osiągnie akceptowalny poziom dokładności.
W uczeniu nadzorowanym model trenowany jest na danych oznaczonych etykietami, co oznacza, że każde wejście ma znaną poprawną odpowiedź (np. etykiety klas w klasyfikacji lub wartości docelowe w regresji). Celem jest minimalizacja różnicy pomiędzy predykcjami a rzeczywistymi etykietami, zazwyczaj przy użyciu funkcji straty takich jak entropia krzyżowa (dla klasyfikacji) lub średni błąd kwadratowy (dla regresji).
W uczeniu głębokim proces ten jest bardzo zasobożerny obliczeniowo i wymaga dużych zbiorów danych. W przeciwieństwie do tradycyjnego ML, gdzie trening może trwać minuty lub godziny, trenowanie głębokich sieci neuronowych może trwać dni, a nawet tygodnie, w zależności od złożoności architektury i wielkości danych. Aby poradzić sobie z tą złożonością, frameworki takie jak TensorFlow i PyTorch oferują wydajne narzędzia do budowy modeli, automatycznego różniczkowania i akceleracji sprzętowej. Biblioteki te obsługują dynamiczne grafy obliczeniowe i oferują szeroki zakres gotowych funkcji do optymalizacji modeli. Strojenie hiperparametrów, takich jak współczynnik uczenia, rozmiar partii danych czy liczba epok treningowych, jest niezbędne do zapewnienia skutecznej konwergencji modelu.
W uczeniu nienadzorowanym model trenowany jest na danych nieoznaczonych, co oznacza brak z góry zdefiniowanych kategorii lub poprawnych odpowiedzi. Zamiast przewidywać konkretne wyniki, model identyfikuje wzorce, struktury lub klastry w danych.
• Algorytmy klasteryzacji grupują podobne punkty danych na podstawie miar odległości.
• Techniki redukcji wymiarowości kompresują dane o wysokim wymiarze do postaci o mniejszej liczbie wymiarów, zachowując kluczowe informacje.
• Modele generatywne uczą się generować nowe próbki danych, które przypominają rozkład danych treningowych.
Ponieważ nie istnieje jawna funkcja straty porównująca predykcje z prawdą, trening często polega na optymalizacji celów nienadzorowanych, takich jak minimalizacja błędu rekonstrukcji lub maksymalizacja separacji klastrów.
Walidacja i testowanie modelu: ocena wydajności
Po zakończeniu trenowania kluczowe jest sprawdzenie, jak dobrze model generalizuje na nowe, niewidziane wcześniej dane. Odbywa się to poprzez walidację i testowanie, z wykorzystaniem oddzielnych zbiorów danych, które nie były używane podczas treningu. Jeżeli model osiąga dobre wyniki na danych treningowych, ale zawodzi na nowych danych, mamy do czynienia z przeuczeniem (overfitting), czyli nauczeniem się wzorców zbyt specyficznych dla zbioru treningowego. Do oceny skuteczności modelu stosuje się miary takie jak dokładność, precyzja, czułość (recall) oraz wynik F1. Dokładność mierzy odsetek poprawnych predykcji, natomiast precyzja i czułość dostarczają informacji o niezawodności modelu w wykrywaniu określonych kategorii, takich jak zagrożenia cybernetyczne. Wynik F1 stanowi kompromis pomiędzy precyzją a czułością, oferując bardziej kompleksową ocenę. Jeżeli wydajność modelu jest niezadowalająca, możliwe są korekty poprzez zebranie większej ilości danych, dopracowanie doboru cech (w ML) lub dostrojenie hiperparametrów.
Wdrożenie i ciągłe monitorowanie: wykorzystanie modelu w rzeczywistych warunkach
Gdy model osiągnie satysfakcjonującą dokładność i odporność, jest wdrażany do środowiska rzeczywistego, gdzie zaczyna generować predykcje na podstawie danych na żywo. Wdrożenie nie jest jednak etapem końcowym – niezbędne jest ciągłe monitorowanie i utrzymanie, aby zapewnić trwałą skuteczność. W cyberbezpieczeństwie morskim nowe zagrożenia pojawiają się nieustannie, a model wytrenowany na historycznych wzorcach ataków może z czasem stać się nieaktualny. Aby zapobiec spadkowi wydajności, modele muszą być okresowo ponownie trenowane na zaktualizowanych danych, stale monitorowane pod kątem błędów oraz ulepszane w celu dostosowania do zmieniających się warunków. Zaniedbanie tych działań może prowadzić do nieaktualnych predykcji, luk w zabezpieczeniach lub spadku dokładności.
Wysokopoziomowy przegląd potoku treningowego dla nadzorowanego modelu uczenia maszynowego przedstawiono na rysunku 31.
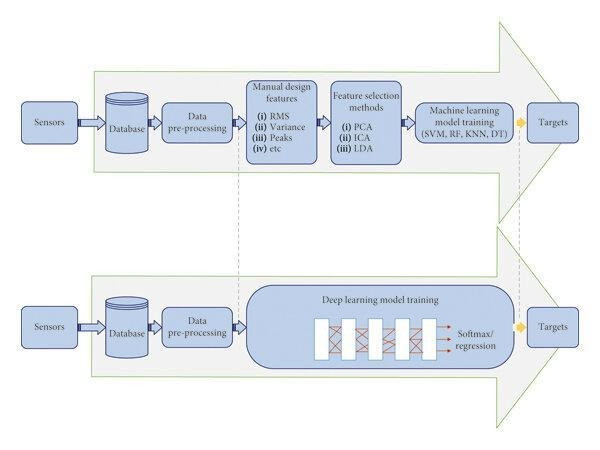
Rysunek 32: Przegląd potoków trenowania modeli ML/DL.
Zastosowania sztucznej inteligencji w cyberbezpieczeństwie morskim
Systemy wykrywania włamań (Intrusion Detection Systems – IDS)
System wykrywania włamań (IDS) jest rozwiązaniem bezpieczeństwa zaprojektowanym do wykrywania nieautoryzowanego dostępu, złośliwej aktywności oraz potencjalnych zagrożeń poprzez ciągłe monitorowanie ruchu sieciowego, zachowań użytkowników oraz logów systemowych. Umiejscowienie IDS zależy od jego rodzaju. Sieciowy system wykrywania włamań (Network-Based IDS – NIDS) jest zazwyczaj umieszczany pomiędzy zaporą sieciową a siecią wewnętrzną, jak pokazano na rysunku 32, gdzie analizuje cały ruch przychodzący i wychodzący pod kątem podejrzanych wzorców, zanim dotrze on do systemów krytycznych. Jeżeli atakujący ominie zaporę sieciową, IDS wykrywa anomalie i generuje alert do dalszej analizy. Z kolei hostowy system wykrywania włamań (Host-Based IDS – HIDS) jest instalowany bezpośrednio na poszczególnych urządzeniach, takich jak systemy nawigacyjne statku, serwery lub stacje robocze, gdzie monitoruje logi systemowe, integralność plików oraz aktywność użytkowników w celu wykrycia złośliwych zmian. W kontekście morskim systemy IDS odgrywają kluczową rolę w ochronie operacji krytycznych, takich jak zarządzanie ładunkiem, nawigacja oraz sieci komunikacyjne (MarPoint, 2025).
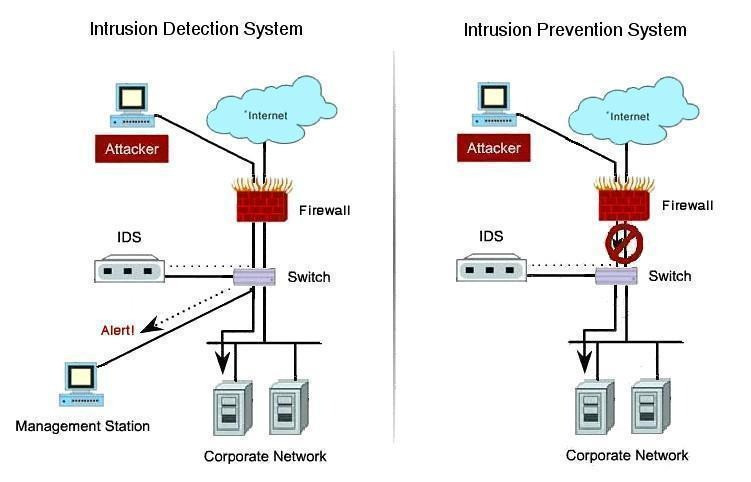
Rysunek 33: System wykrywania włamań (IDS)
System IDS wykorzystuje dwa podstawowe podejścia do wykrywania złośliwych zachowań:
Wykrywanie oparte na sygnaturach (signature-based detection) – polega na porównywaniu obserwowanej aktywności z bazą znanych sygnatur ataków przy użyciu technik dopasowywania ciągów znaków. Metoda ta jest bardzo skuteczna w identyfikowaniu wcześniej znanych zagrożeń, jednak nie radzi sobie z nowymi lub ewoluującymi atakami.
Wykrywanie oparte na zachowaniu (behavior-based detection) – monitoruje odchylenia od normalnych wzorców aktywności, co umożliwia identyfikację nowych lub nieznanych zagrożeń. Metoda ta jest bardziej adaptacyjna, ale może generować większą liczbę fałszywych alarmów.
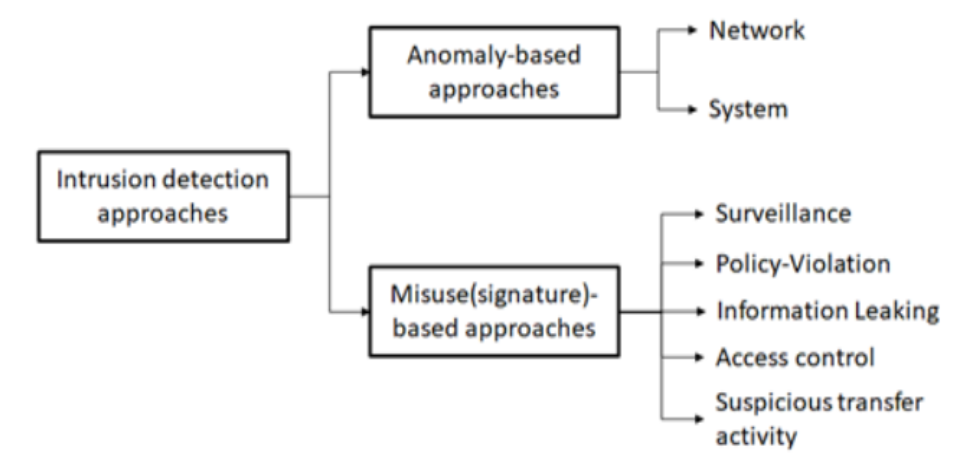
Rysunek 34: Klasyfikacja podejść do wykrywania włamań.
Systemy IDS oparte na sztucznej inteligencji zwiększają poziom bezpieczeństwa poprzez analizę danych w czasie rzeczywistym, identyfikowanie anomalii oraz rozróżnianie typowych wzorców ruchu sieciowego od szkodliwych intruzji. Integrując zarówno metody nadzorowane, które bazują na znanych sygnaturach ataków, jak i metody nienadzorowane, które wykrywają nietypowe odchylenia od normalnej aktywności, systemy IDS oparte na AI redukują liczbę fałszywych alarmów i poprawiają skuteczność detekcji.
Systemy IDS wykorzystujące sztuczną inteligencję stosują algorytmy uczenia maszynowego, aby dokładniej wykrywać zagrożenia. Algorytmy te pomagają rozpoznawać zarówno znane, jak i nieznane cyberataki.
Uczenie nadzorowane (supervised learning) – podejście to polega na trenowaniu modelu AI na podstawie historycznych danych o atakach oznaczonych jako „bezpieczne” lub „niebezpieczne”. Na tej podstawie AI uczy się rozpoznawać zagrożenia i stosuje zdobytą wiedzę do wykrywania nowych ataków.
Uczenie nienadzorowane (unsupervised learning) – w przeciwieństwie do uczenia nadzorowanego nie wymaga danych oznaczonych etykietami. AI identyfikuje nietypową aktywność, wykrywając wzorce, które nie odpowiadają normalnemu zachowaniu.
Jednym z częstych problemów tradycyjnych systemów IDS są fałszywe alarmy, czyli sytuacje, w których nieszkodliwa aktywność sieciowa zostaje błędnie uznana za zagrożenie. Sztuczna inteligencja ogranicza liczbę fałszywych alarmów, ucząc się na podstawie wcześniejszych błędów i stopniowo poprawiając swoją dokładność. AI może również łączyć różne metody detekcji w celu uzyskania lepszych wyników. Poprzez połączenie wykrywania opartego na sygnaturach i zachowaniu, systemy IDS oparte na AI minimalizują błędy przy jednoczesnym utrzymaniu wysokiego poziomu bezpieczeństwa. Niektóre modele AI wykorzystują także uczenie ze wzmocnieniem (reinforcement learning), czyli technikę, w której system stale dostosowuje swoje reguły detekcji na podstawie informacji zwrotnej.
Ponieważ IDS jest systemem pasywnym, nie podejmuje on bezpośrednich działań wobec wykrytych zagrożeń. Zamiast tego generuje alerty dla operatorów lub integruje się z systemami zarządzania informacjami i zdarzeniami bezpieczeństwa (SIEM) w celu dalszej analizy i reakcji. Włamania mogą pochodzić zarówno ze źródeł zewnętrznych, jak i wewnętrznych, co czyni IDS kluczowym elementem strategii cyberbezpieczeństwa w różnych sektorach.
Systemy zapobiegania włamaniom (Intrusion Prevention Systems – IPS)
System zapobiegania włamaniom (IPS) jest technologią bezpieczeństwa zaprojektowaną do wykrywania i aktywnego zapobiegania złośliwej aktywności w sieci lub systemie. W przeciwieństwie do IDS, który jedynie monitoruje i alarmuje o podejrzanej aktywności, IPS podejmuje bezpośrednie działania w czasie rzeczywistym w celu blokowania, łagodzenia lub zatrzymywania ataków. O ile IDS pełni rolę narzędzia monitorującego, IPS działa jako system kontrolny, który aktywnie zapobiega zagrożeniom, zanim spowodują one szkody w operacjach takich jak nawigacja, obsługa ładunku czy łącza komunikacyjne (Sowmya i Anita, 2023).
IPS jest zazwyczaj wdrażany za zaporą sieciową, lecz przed systemami wewnętrznymi, co umożliwia analizę zarówno ruchu przychodzącego, jak i wychodzącego, jak pokazano na rysunku 34. W przeciwieństwie do zapory sieciowej, która filtruje ruch głównie na podstawie zdefiniowanych reguł, IPS wykorzystuje zaawansowaną analizę do wykrywania i blokowania dynamicznych zagrożeń w czasie rzeczywistym. W niektórych architekturach sieciowych IPS działa równolegle z IDS, gdzie IDS wykrywa zagrożenia i alarmuje administratorów, natomiast IPS podejmuje aktywne działania neutralizujące atak.
Rysunek 35: System zapobiegania włamaniom (IPS)
Kluczowe działania wykonywane przez IPS:
• wysyłanie alertów do administratorów,
• odrzucanie potencjalnie szkodliwych pakietów,
• blokowanie połączeń złośliwych źródeł,
• restartowanie skompromitowanych połączeń w celu zapobieżenia dalszej eksploatacji.
Nowoczesne rozwiązania IPS wykorzystują analitykę opartą na sztucznej inteligencji oraz strumienie danych w czasie rzeczywistym, aby skuteczniej wykrywać i blokować zagrożenia. Dzięki ciągłemu uczeniu się na podstawie historycznych i pojawiających się wzorców ataków systemy te zwiększają swoją dokładność i redukują liczbę fałszywych alarmów. Integracja analityki AI z danymi czasu rzeczywistego pozwala nowoczesnym IPS zwiększać bezpieczeństwo poprzez izolowanie zainfekowanych punktów końcowych, blokowanie złośliwych adresów IP oraz dynamiczną modyfikację reguł zapory sieciowej w celu zapobiegania bocznemu rozprzestrzenianiu się zagrożeń w sieciach statków i portów (Maritime Intelligence, 2025). Znaczącym przykładem jest implementacja sieciowego IPS przez firmę Cisco, która skutecznie wykrywała i neutralizowała wewnętrzne zagrożenia sieciowe, zanim doprowadziły one do utraty danych lub zakłóceń usług. Analizując zarówno ruch przychodzący, jak i wychodzący w obrębie organizacji, IPS Cisco zapewnił kluczową warstwę ochrony, demonstrując skuteczność systemów IPS wspomaganych przez AI w proaktywnym neutralizowaniu cyberzagrożeń, zanim dojdzie do ich eskalacji (Contentree, 2025).
Otwartoźródłowe systemy wykrywania i zapobiegania włamaniom
Wraz z ewolucją zagrożeń cybernetycznych otwartoźródłowe systemy IDS i IPS stały się kluczowymi narzędziami do monitorowania i zabezpieczania sieci. Dwa najczęściej stosowane rozwiązania open source to Snort i Suricata, które oferują detekcję i zapobieganie zagrożeniom w czasie rzeczywistym, zapewniając jednocześnie elastyczność i możliwość dostosowania.
Snort: system IDS/IPS oparty na regułach
Snort, opracowany pierwotnie przez Martina Roescha w 1998 roku, jest systemem IDS/IPS opartym na sygnaturach, zdolnym do analizy ruchu sieciowego w czasie rzeczywistym oraz rejestrowania pakietów w sieciach IP. Wykorzystuje język reguł, który umożliwia łączenie sygnatur, protokołów oraz technik wykrywania anomalii w celu identyfikacji szerokiego spektrum zagrożeń cybernetycznych, takich jak ataki typu denial-of-service (DoS), przepełnienia bufora, ukryte skanowanie portów czy ataki CGI.
Snort działa poprzez przechwytywanie pakietów sieciowych przy użyciu bibliotek takich jak libpcap i WinPcap oraz może funkcjonować w trzech podstawowych trybach:
- Tryb podsłuchiwania pakietów – przechwytuje i monitoruje surowy ruch sieciowy.
- Tryb rejestrowania pakietów – zapisuje pakiety sieciowe do analizy i debugowania.
- Tryb wykrywania włamań – porównuje aktywność sieciową z wcześniej zdefiniowanymi regułami i generuje alerty w przypadku wykrycia zagrożeń.
Jedną z głównych zalet Snorta jest elastyczny język reguł, który pozwala użytkownikom definiować własne polityki bezpieczeństwa. System ten dobrze integruje się z zaporami sieciowymi, zapewniając dodatkową warstwę ochrony, co czyni go wartościowym narzędziem do monitorowania sieci wewnętrznych.
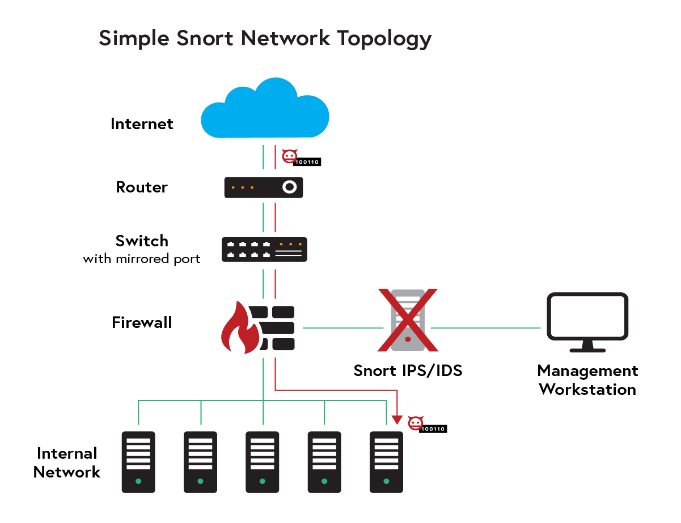
Rysunek 36: Prosta topologia sieci z systemem Snort.
Suricata: wysokowydajny IDS/IPS i monitorowanie bezpieczeństwa sieci (NSM)
Suricata, rozwijana przez Open Information Security Foundation (OISF), jest systemem IDS/IPS nowej generacji, który rozszerza tradycyjne monitorowanie bezpieczeństwa sieci o głęboką inspekcję pakietów (DPI) oraz natywne przetwarzanie wielowątkowe. W przeciwieństwie do Snorta, który koncentruje się głównie na detekcji opartej na sygnaturach, Suricata analizuje wiele warstw protokołów (w tym HTTP, TLS, DNS i SMB), umożliwiając wykrywanie bardziej zaawansowanych i trudnych do zidentyfikowania zagrożeń.
Jedną z kluczowych zalet Suricaty jest zdolność przetwarzania ruchu sieciowego z dużą prędkością dzięki architekturze wielowątkowej, co czyni ją odpowiednią dla wdrożeń korporacyjnych oraz środowisk chmurowych. Dodatkowo integruje się ona z narzędziami SIEM i platformami analitycznymi, umożliwiając wizualizację i analizę zagrożeń w czasie rzeczywistym.
Unikalną cechą Suricaty jest funkcjonalność Network Security Monitoring (NSM), która umożliwia ekstrakcję metadanych z ruchu sieciowego, oprócz samego wykrywania włamań. Funkcja ta wspiera zespoły cyberbezpieczeństwa w skuteczniejszym badaniu incydentów, zapewniając głębszy wgląd w zachowanie sieci.
Głęboka inspekcja pakietów (Deep Packet Inspection – DPI) w zaawansowanej detekcji zagrożeń
Głęboka inspekcja pakietów (DPI) wykracza poza analizę nagłówków pakietów, badając również ich ładunek i metadane, co zapewnia szczegółową widoczność protokołów, treści warstwy aplikacyjnej oraz zachowań zdefiniowanych przez użytkownika. W przeciwieństwie do tradycyjnego filtrowania pakietów, które ogranicza się do analizy nagłówków IP oraz TCP/UDP, DPI analizuje cały pakiet, umożliwiając identyfikację złośliwych ładunków, naruszeń polityk bezpieczeństwa lub zagrożeń ukrytych w ruchu wyglądającym na legalny (Leslie, 2020).
Silnik DPI działa poprzez inspekcję zawartości pakietów w czasie rzeczywistym, wykorzystując dopasowanie sygnatur, heurystyki oraz wykrywanie anomalii. Pozwala to na klasyfikację pakietów według protokołu, typu aplikacji oraz treści, co jest kluczowe dla identyfikacji zagrożeń ukrytych w pozornie prawidłowym ruchu sieciowym. Przykładowo DPI potrafi rozróżnić zwykły ruch HTTP od ataku realizowanego przez HTTP, takiego jak wstrzyknięcie SQL lub komunikacja malware typu command-and-control. DPI jest również zdolne do odszyfrowywania ruchu SSL/TLS w celach analizy bezpieczeństwa, co zapobiega omijaniu mechanizmów ochronnych przez zaszyfrowane pakiety. Wiele współczesnych ataków cybernetycznych wykorzystuje szyfrowanie do ukrywania złośliwej aktywności, jednak systemy DPI wspomagane przez AI potrafią identyfikować anomalie behawioralne nawet w zaszyfrowanych sesjach, takie jak nietypowe wzorce transferu danych czy komunikacja z domenami znanymi z działalności złośliwej. W połączeniu z algorytmami sztucznej inteligencji lub uczenia maszynowego, DPI znacząco zwiększa skuteczność detekcji, ucząc się na podstawie wcześniejszych wzorców ruchu i identyfikując ataki typu zero-day oraz zaawansowane trwałe zagrożenia (APT), które omijają tradycyjne mechanizmy bezpieczeństwa.
W przypadku wykrycia anomalii systemy DPI mogą podejmować zautomatyzowane działania, takie jak izolowanie skompromitowanego punktu końcowego, przerywanie podejrzanych połączeń lub dynamiczne rekonfigurowanie reguł zapory sieciowej w celu zapobiegania rozprzestrzenianiu się złośliwego oprogramowania w morskich sieciach IT i OT (Ipoque, 2025).
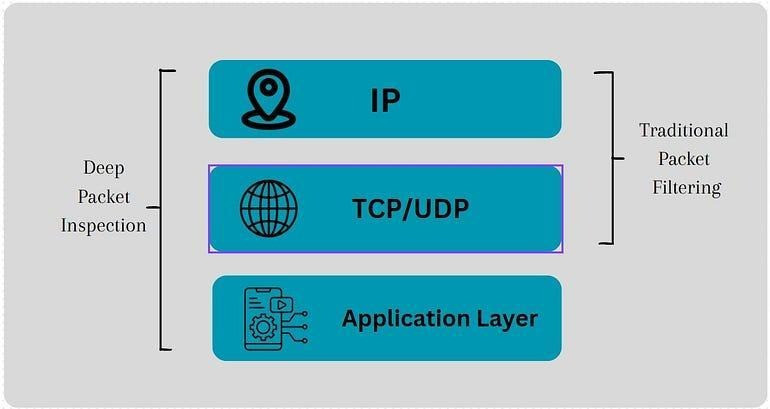
Rysunek 37: Porównanie tradycyjnej filtracji pakietów i głębokiej inspekcji pakietów
(Nethmal, 2025).
Generatywne sieci przeciwstawne (GAN) do augmentacji danych i obrony
Generatywne sieci przeciwstawne (Generative Adversarial Networks – GAN) składają się z dwóch konkurujących ze sobą sieci neuronowych: generatora, który tworzy dane syntetyczne, oraz dyskryminatora, który ocenia ich autentyczność, jak pokazano na rysunku 37. Pierwotnie opracowane do syntezy obrazów i generowania deepfake’ów, GAN-y okazały się wysoce skuteczne w zastosowaniach z zakresu cyberbezpieczeństwa, w szczególności w wykrywaniu włamań, trenowaniu odpornym na ataki (adversarial training) oraz analizie złośliwego oprogramowania. Dzięki generowaniu bardzo realistycznych próbek ataków, GAN-y wzmacniają modele bezpieczeństwa oparte na uczeniu maszynowym, umożliwiając im rozpoznawanie zarówno znanych, jak i wcześniej niewidzianych zagrożeń (Zhao, 2024).
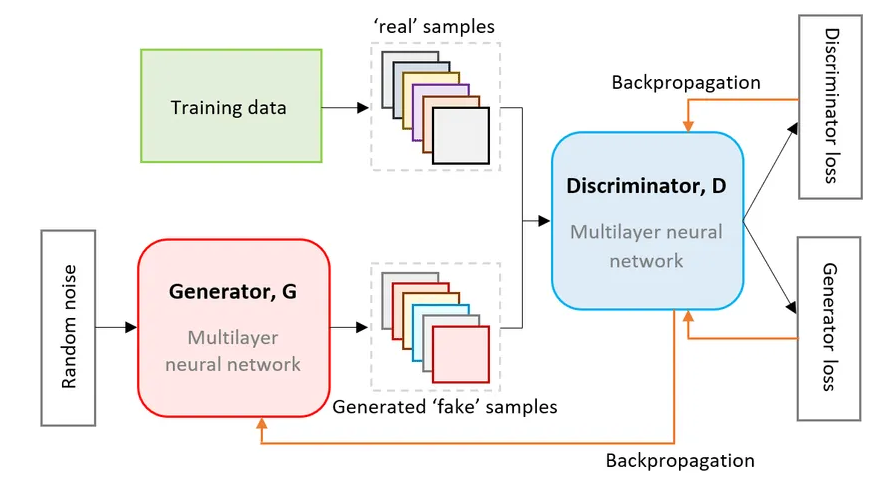
Rysunek 38: Architektura sieci GAN
(TVS, 2025).
Jednym z zastosowań generatywnych sieci przeciwstawnych (GAN) w cyberbezpieczeństwie jest ich zdolność do tworzenia syntetycznych wzorców złośliwego oprogramowania lub prób wykorzystania podatności, co skutecznie rozszerza zbiory danych treningowych dla systemów IDS i IPS. Tradycyjne rozwiązania IDS/IPS opierają się na detekcji sygnaturowej, która ma trudności z wykrywaniem zagrożeń typu zero-day oraz polimorficznego malware, które stale ewoluuje. Trenując modele IDS/IPS na próbkach adwersarialnych generowanych przez GAN-y, systemy cyberbezpieczeństwa mogą zwiększyć swoją odporność na wcześniej nieznane strategie ataków. GAN-y znalazły również zastosowanie w zautomatyzowanych testach penetracyjnych, gdzie generują warianty e-maili phishingowych, ładunki ataków brute-force lub skrypty exploitów w celu testowania poziomu bezpieczeństwa organizacji. Poprzez symulowanie rzeczywistych zagrożeń cybernetycznych, testy penetracyjne oparte na GAN-ach umożliwiają ciągłą ocenę bezpieczeństwa bez narażania systemów na rzeczywiste ataki.
Poza wykrywaniem włamań, GAN-y są szeroko wykorzystywane w detekcji anomalii. Detektor anomalii oparty na GAN-ach najpierw uczy się statystycznego rozkładu normalnego zachowania sieci, a następnie identyfikuje subtelne odchylenia, które mogą wskazywać na ukryte zagrożenia cybernetyczne, zamaskowane złośliwe oprogramowanie lub próby eksfiltracji danych. W przeciwieństwie do tradycyjnych metod detekcji anomalii opartych na regułach, GAN-y stale adaptują się do nowych warunków sieciowych, redukując liczbę fałszywych alarmów i jednocześnie zwiększając dokładność detekcji. Zdolność ta jest szczególnie przydatna w wykrywaniu zaawansowanych trwałych zagrożeń (APT), które wtapiają się w legalny ruch sieciowy.
Innym innowacyjnym zastosowaniem GAN-ów jest trenowanie adwersarialne, w którym modele cyberbezpieczeństwa są wzmacniane przeciwko technikom unikania detekcji. Atakujący często wykorzystują metody adwersarialnego uczenia maszynowego, manipulując modelami IDS/IPS poprzez tworzenie ładunków ataków omijających tradycyjne mechanizmy detekcji. Trenując GAN-y do symulowania takich ataków adwersarialnych, systemy obronne mogą być testowane obciążeniowo i wzmacniane, co zapewnia ich odporność na tego typu zagrożenia.
Detekcja anomalii
Podczas gdy systemy IDS często koncentrują się na określonych typach włamań, detekcja anomalii jest szerszą techniką identyfikującą wszelkie nietypowe lub niepasujące zachowania, które mogą sygnalizować awarię systemu lub zagrożenie cybernetyczne. Monitorując wskaźniki takie jak wykorzystanie zasobów systemowych, opóźnienia sieciowe czy próby logowania, algorytmy detekcji anomalii budują punkt odniesienia tego, jak wygląda „normalna” aktywność. Każde istotne odchylenie od tego wzorca może oznaczać problem bezpieczeństwa lub operacyjny. W wielu zastosowaniach morskich systemy AI mogą inicjować automatyczne środki zaradcze, takie jak izolowanie skompromitowanych sieci lub dynamiczna modyfikacja reguł zapory sieciowej w celu szybkiego ograniczenia potencjalnych zagrożeń (Ribeiro et al., 2023). Taka szybka, autonomiczna reakcja ma kluczowe znaczenie w operacjach morskich, gdzie nawet niewielkie incydenty mogą szybko eskalować do poważnych wyzwań logistycznych lub zagrożeń bezpieczeństwa, jeśli nie zostaną natychmiast opanowane.
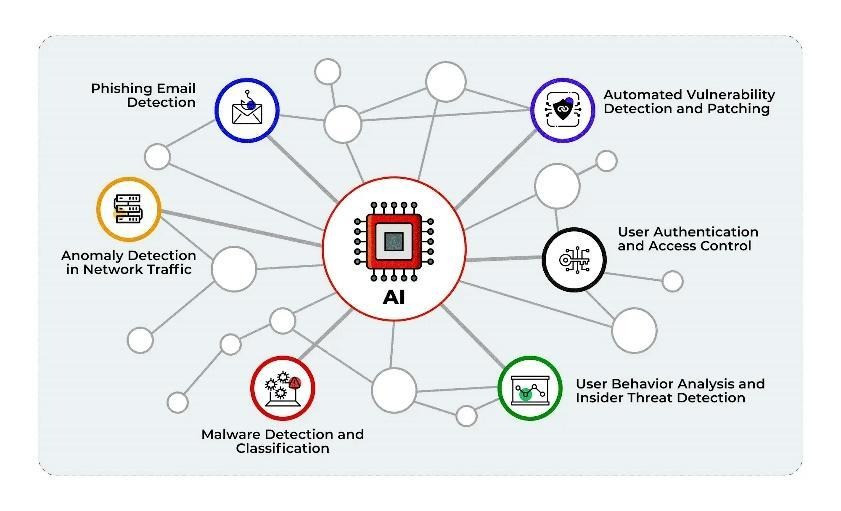
Rysunek 39: Zastosowania detekcji anomalii w cyberbezpieczeństwie.
Analiza predykcyjna zagrożeń cybernetycznych
Analiza predykcyjna wykorzystuje dane historyczne oraz wzorce zachowań do przewidywania potencjalnych słabości i przyszłych strategii ataków, oferując tym samym proaktywną obronę cybernetyczną. Analizując duże zbiory danych z wcześniejszych incydentów, modele AI mogą identyfikować czynniki, które często poprzedzają ataki (Merrick, 2022). W praktyce algorytmy te symulują różne scenariusze ataków w celu wskazania słabych punktów, dostarczając zespołom bezpieczeństwa jasnych informacji o tym, gdzie należy w pierwszej kolejności alokować zasoby. Poprzez przypisywanie punktacji ryzyka do różnych zagrożeń operatorzy morscy mogą ustalać priorytety i wzmacniać swoje zabezpieczenia w celu ochrony systemów krytycznych. Podejście to nie tylko redukuje bieżące ryzyko, ale również zwiększa długoterminową odporność na ewoluujące zagrożenia cybernetyczne (Meijer i Wessels, 2019). Analiza predykcyjna jest często integrowana z systemami zarządzania informacjami i zdarzeniami bezpieczeństwa (SIEM), aby korelować dane w czasie rzeczywistym z wielu źródeł i zwiększać dokładność prognozowania zagrożeń. W połączeniu z systemami IDS i IPS modele te mogą uruchamiać zautomatyzowane mechanizmy obronne, blokując zagrożenia zanim się zmaterializują.
Potencjalne podatności i ataki adwersarialne
Chociaż AI znacząco wzmacnia cyberbezpieczeństwo morskie, wprowadza również potencjalne podatności, które przeciwnicy mogą próbować wykorzystać. Ataki adwersarialne polegają na dostarczaniu starannie spreparowanych danych do modeli AI w celu skłonienia ich do błędnych decyzji lub ignorowania rzeczywistych zagrożeń (Qiu et al., 2019). Na przykład złośliwi aktorzy mogą maskować malware w taki sposób, aby system detekcji oparty na AI zaklasyfikował go jako nieszkodliwy. Innym zagrożeniem jest zatruwanie modelu (model poisoning), polegające na wprowadzaniu fałszywych lub mylących danych do zbioru treningowego, co stopniowo obniża dokładność modelu.
Aby chronić się przed takimi technikami, organizacje morskie stosują szereg środków ochronnych. Jednym z nich jest regularne ponowne trenowanie modeli na danych o potwierdzonej integralności, co zapewnia ich aktualność i dokładność. Trening adwersarialny, w którym model jest celowo wystawiany na manipulacyjne dane wejściowe podczas fazy rozwoju, pomaga mu rozpoznawać i odpierać tego typu ataki. Kluczowe znaczenie mają również solidne potoki danych oraz mechanizmy kontroli dostępu, które zabezpieczają zarówno proces trenowania, jak i operacyjne wykorzystanie AI, pozwalając zachować liczne korzyści płynące z jej zastosowania w bezpieczeństwie morskim i efektywności operacyjnej.
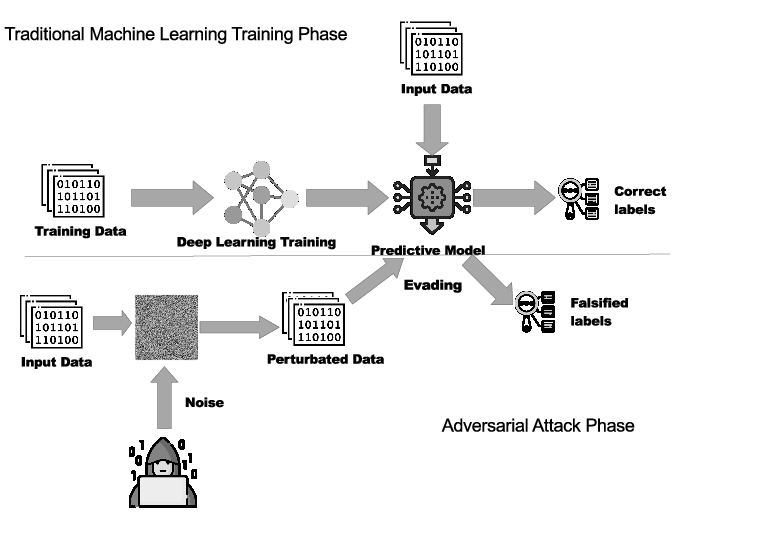
Rysunek 40: Przykład ataku adwersarialnego
(Catak & Sule, (2020)).
Wyzwania i ograniczenia AI
Systemy oparte na AI oferują zwiększone możliwości identyfikacji i ograniczania zagrożeń cybernetycznych, jednak wprowadzają również szereg wyzwań i ograniczeń, którym organizacje muszą sprostać, aby maksymalnie wykorzystać ich potencjał.
Jakość i dostępność danych
Jednym z kluczowych problemów jest jakość i dostępność danych. Ponieważ systemy te w dużym stopniu polegają na dużych wolumenach danych wysokiej jakości do trenowania i doskonalenia algorytmów detekcji, wszelkie nieścisłości lub luki w danych mogą prowadzić do błędnych predykcji lub pominięcia zagrożeń. Organizacje często napotykają trudności przy integrowaniu danych z wielu segmentów sieci i rozproszonych źródeł (Palo Alto Networks, 2025), co skutkuje niepełnym obrazem aktywności użytkowników i zachowania systemów oraz lukami w detekcji zagrożeń.
Fałszywe alarmy i zmęczenie alertami
Kolejne wyzwanie wynika z dużej liczby fałszywych alarmów. Chociaż AI ma na celu ograniczenie tych błędnych alertów, nadal może generować lawinę ostrzeżeń, która przytłacza zespoły bezpieczeństwa. Taka sytuacja może powodować zmęczenie alertami, gdy personel bezpieczeństwa zaczyna pomijać potencjalnie istotne ostrzeżenia z powodu stałego napływu powiadomień o niskim ryzyku (Olateju et al., 2024). Zarządzanie i badanie tych licznych alertów wymaga znacznego czasu i zasobów, potencjalnie odciągając uwagę od rzeczywistych zagrożeń.
Złożoność i brak interpretowalności
Złożoność i interpretowalność stanowią dodatkowe przeszkody. Nowoczesne techniki AI, szczególnie uczenie głębokie, mogą generować wyniki poprzez nieprzejrzyste procesy decyzyjne. Analitykom bezpieczeństwa może być trudno zaufać alertom lub podjąć działania, gdy nie potrafią zrozumieć, jak lub dlaczego model AI doszedł do konkretnego wniosku (Digital Leaders, 2025). W rezultacie zapewnienie, że system dostarcza jasne wyjaśnienia i uzasadnienia, jest kluczowe dla budowania zaufania do narzędzi bezpieczeństwa opartych na AI.
Integracja z istniejącymi systemami
W wielu organizacjach integracja z istniejącymi systemami jest daleka od płynnej. Systemy oparte na AI muszą działać bezproblemowo z istniejącą infrastrukturą bezpieczeństwa organizacji, co może wiązać się z problemami kompatybilności i wymagać znacznej wiedzy technicznej. Systemy starszego typu (legacy) często wymagają modernizacji, zanim będą w stanie sprostać wymaganiom AI w zakresie przetwarzania danych i zaawansowanej analityki. Wymagania te nie tylko zwiększają złożoność wdrożenia, ale także generują dodatkowe koszty i wydłużają harmonogramy implementacji.
Podatność na ataki adwersarialne
Same modele AI mogą być podatne na ataki adwersarialne, w których złośliwi aktorzy celowo manipulują danymi wejściowymi, aby oszukać system. Obejmuje to wprowadzanie mylących wzorców lub sygnałów, które powodują, że AI błędnie klasyfikuje zagrożenia lub przyznaje nieautoryzowany dostęp. Ograniczanie takich ataków wymaga stałego monitorowania i aktualizacji, aby zapewnić, że modele pozostają odporne w obliczu ewoluujących technik adwersarialnych (MetaCompliance, 2025).
Stronniczość w modelach AI
Stronniczość w modelach AI stanowi kolejną obawę. Jeśli dane treningowe są przekrzywione lub odzwierciedlają określone uprzedzenia, IDS może niesprawiedliwie oznaczać konkretne grupy, typy aktywności lub zachowania użytkowników. Może to prowadzić nie tylko do problemów etycznych, ale także do suboptymalnych wyników bezpieczeństwa, ponieważ zawężone ukierunkowanie może sprawić, że system pominie szersze zagrożenia (ISC², 2024). Identyfikowanie i ograniczanie stronniczości jest zatem kluczowe dla zapewnienia sprawiedliwości i utrzymania integralności procesu detekcji.
Wyzwania regulacyjne i zgodności
Wymagania regulacyjne i zgodności wprowadzają kolejną warstwę złożoności. Wiele branż, w tym sektor morski, musi przestrzegać rygorystycznych przepisów dotyczących prywatności danych i cyberbezpieczeństwa, aby zapewnić bezpieczne przetwarzanie danych użytkowników, klientów i danych operacyjnych. Rozwiązania oparte na AI muszą generować jasne ścieżki audytowe i oferować wystarczającą przejrzystość, aby wykazać zgodność podczas audytów, co zwiększa obciążenia administracyjne i techniczne procesu wdrożenia (Ethico, 2024). Zgodność z ramami takimi jak NIST Cybersecurity Framework, ISO 27001 oraz wytyczne ENISA, między innymi, jest kluczowa dla zapewnienia bezpiecznego i zgodnego z prawem wdrażania systemów cyberbezpieczeństwa wzmocnionych AI.
Wysokie koszty wdrożenia i utrzymania
Koszt jest również istotnym czynnikiem. Początkowe wydatki na specjalistyczny sprzęt, licencje oprogramowania i usługi profesjonalne mogą być wysokie, a bieżące utrzymanie, aktualizacje i ponowne trenowanie modeli wiążą się ze stałymi kosztami. W rezultacie mniejsze organizacje mogą mieć trudności z uzasadnieniem lub sfinansowaniem długoterminowej inwestycji wymaganej do wdrożenia i utrzymania możliwości AI na dużą skalę (Modern Diplomacy, 2024).
Niedobór wykwalifikowanych specjalistów
Dodatkowo często występuje wyraźna luka w niezbędnej wiedzy do zarządzania systemami bezpieczeństwa opartymi na AI. Organizacje mogą mieć trudności z rekrutacją lub przeszkoleniem wystarczającej liczby specjalistów posiadających jednocześnie wiedzę z zakresu AI i doświadczenie w bezpieczeństwie. Utrzymywanie personelu na bieżąco z szybko rozwijającymi się technikami AI i zagrożeniami cybernetycznymi wymaga zaangażowania w ciągłe programy edukacyjne i szkoleniowe (Technology Magazine, 2024).
Kwestie prywatności
Wreszcie, kwestie prywatności wysuwają się na pierwszy plan, gdy wykorzystuje się IDS oparte na AI do monitorowania zachowań użytkowników. Zbieranie i analizowanie tak szczegółowych informacji może pozostawać w konflikcie z przepisami o ochronie danych, jeśli nie jest prowadzone ostrożnie. Organizacje muszą zapewnić, że dane użytkowników są zbierane, przechowywane i przetwarzane w sposób, który respektuje prawa jednostek do prywatności i jest zgodny z regulacjami takimi jak RODO (Stewart, 2024). Osiągnięcie tej równowagi wymaga uzyskania zgody użytkowników, jasnego określenia polityk monitorowania oraz utrzymania rygorystycznych praktyk zarządzania danymi.
Uwzględniając te wyzwania — od jakości danych i fałszywych alarmów, przez interpretowalność, koszty, stronniczość, braki kompetencyjne i kwestie prywatności — organizacje mogą wykorzystać pełen potencjał rozwiązań opartych na AI, jednocześnie utrzymując solidne bezpieczeństwo i zgodność regulacyjną.
Podsumowując, AI przekształca cyberbezpieczeństwo morskie poprzez zwiększenie skuteczności wykrywania zagrożeń, zapobieganie cyberatakom oraz optymalizację operacji statków. Dzięki uczeniu maszynowemu i uczeniu głębokiemu systemy oparte na AI, takie jak IDS, IPS i DPI, pomagają monitorować, analizować i reagować na ryzyka bezpieczeństwa w czasie rzeczywistym. Analiza predykcyjna dodatkowo wzmacnia obronę cybernetyczną, identyfikując podatności zanim dojdzie do ataku. Jednak wdrażanie AI wiąże się z wyzwaniami, w tym atakami adwersarialnymi, stronniczością oraz złożonością integracji. Aby zapewnić odporność, niezbędne są ciągłe postępy w strategiach bezpieczeństwa AI, takie jak trening adwersarialny, poprawa zgodności regulacyjnej oraz adaptacyjne modele uczące się. W miarę ewolucji zagrożeń cybernetycznych AI będzie odgrywać coraz bardziej kluczową rolę w zabezpieczaniu operacji morskich, jednocześnie zwiększając efektywność operacyjną i bezpieczeństwo.


