
Completion requirements
Framväxande teknologier och framtida utmaningar
5. AI för maritim cybersäkerhet och prediktiv analys
Cybersäkerhet har blivit en avgörande fråga för att skydda viktiga funktioner som navigering, lasthantering och kommunikationsnätverk. Artificiell intelligens (AI) har framstått som ett kraftfullt verktyg för att hantera dessa säkerhetsutmaningar. Genom att analysera stora mängder data kan AI-system upptäcka hot mer exakt, påskynda svar och mildra driftstörningar (Kaur et al., 2023). Detta dokument ger en översikt över AI, maskininlärning (ML) och djupinlärning (DL), beskriver utvecklingen av livscykler för maskininlärningsmodeller och diskuterar hur dessa tekniker kan stärka maritim cybersäkerhet och operativ effektivitet.
Utöver att upptäcka attacker förbättrar AI även fartygens prestanda och energieffektivitet genom att analysera fartygets sensordata för att förutsäga eventuella mekaniska fel innan de inträffar (Tu et al., 2018). Denna teknik hjälper till att schemalägga reparationer vid de mest kostnadseffektiva tidpunkterna och förhindrar oväntade haverier. Dessutom kan AI dynamiskt modifiera ett fartygs hastighet och rutt baserat på väderförhållanden, last eller bränsleförbrukning, vilket i slutändan sänker driftskostnaderna och minskar miljöpåverkan.
En annan kritisk tillämpning är AI-driven visuell övervakning, som stärker sjösäkerheten genom att övervaka aktiviteter ombord för obehörig åtkomst eller ovanligt beteende (Şengönül et al., 2023). Djupinlärningsmodeller, såsom faltningsneurala nätverk, kan känna igen avvikelser i lasthantering eller upptäcka när personal går in i restriktionszoner. Till exempel kan robotsystem säkert och effektivt ta bort varor från containrar som anländer i slumpmässig ordning, vilket minskar riskerna för manuellt arbete och förbättrar operationell noggrannhet (Mojtahedzadeh et al., 2015).
2. Grunderna i AI, ML och DL
Artificiell intelligens är ett brett område inom datavetenskap som fokuserar på att skapa system som kan utföra uppgifter som normalt kräver mänsklig intelligens, såsom att förstå språk, känna igen mönster eller fatta beslut. Tidig AI-forskning förlitade sig i hög grad på vad som kallas "regelbaserade" system, där experter skrev ner detaljerade uppsättningar OM-SÅ-instruktioner som visas i figur 23. Till exempel kan en cybersäkerhetsregel säga: "OM en dator registrerar flera misslyckade inloggningsförsök, SÅ blockera användaren tillfälligt." Sådana system fungerar bra i situationer där regler kan definieras tydligt, men de kan ha svårt när de stöter på nya eller oväntade problem.
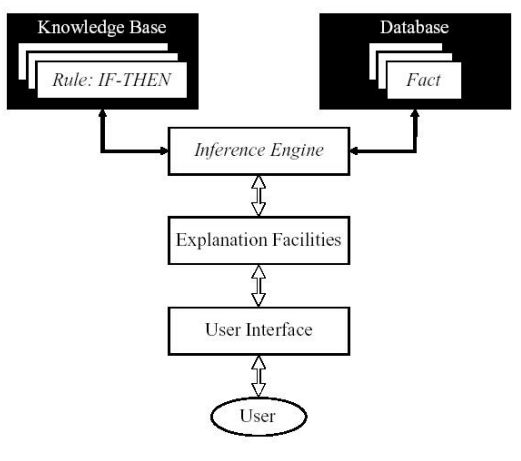
Figur 23: Struktur för regelbaserade system för AI
(Mojtahedzadeh m.fl., 2015)
Modern AI går bortom att enbart förlita sig på manuellt skrivna regler. Istället använder den tekniker som maskininlärning, vilket gör det möjligt för datorer att lära sig av data utan att vara explicit programmerade för varje möjligt scenario. Istället för att specificera instruktioner för varje situation förser vi systemet med stora mängder information, vilket gör att det kan analysera mönster och fatta sina egna beslut. Denna process speglar hur människor lär sig genom erfarenhet genom att observera många exempel, känna igen samband och gradvis förbättra sin förståelse. Inom sjöfartsoperationer kan till exempel maskininlärning analysera data från GPS-spårningssystem för att upptäcka ovanliga fartygsrörelser som kan tyda på obehörig åtkomst eller pirathot. Genom att kontinuerligt lära sig av positionsdata i realtid och tidigare incidenter kan AI känna igen avvikelser från normala rutter eller beteenden, vilket utlöser varningar innan potentiella säkerhetsrisker eskalerar. Med tiden förfinar maskininlärningsmodeller sina förutsägelser och anpassar sig till nya fall, vilket gör dem mer effektiva på att hantera komplexa och föränderliga problem utan att kräva direkt mänsklig intervention för varje beslut.
Inom maskininlärning finns det olika sätt att lära sig. I ett tillvägagångssätt, ofta kallat övervakat lärande, visas exempel som redan har svar eller etiketter. Med tiden listar det ut hur dessa svar relaterar till varje exempel så att det kan förutsäga resultat för ny, osedd data. Beroende på problemtyp kan övervakat lärande användas för klassificering, där målet är att tilldela datapunkter till specifika kategorier, till exempel att upptäcka om ett fartygs kommunikation är legitim eller ett potentiellt cyberhot. Det kan också användas för regression, där modellen förutsäger kontinuerliga värden, till exempel att uppskatta bränsleförbrukning baserat på hastighet, lastvikt och väderförhållanden.
I ett annat tillvägagångssätt, känt som oövervakat lärande, arbetar systemet med information som inte har några etiketter, så det måste upptäcka dolda mönster på egen hand, som att gruppera liknande objekt. Detta är användbart inom maritim cybersäkerhet när man analyserar nätverkstrafik för att upptäcka avvikelser som kan tyda på cyberattacker, eftersom systemet kan klustra normalt och onormalt beteende utan förkunskap om hur en attack ser ut.
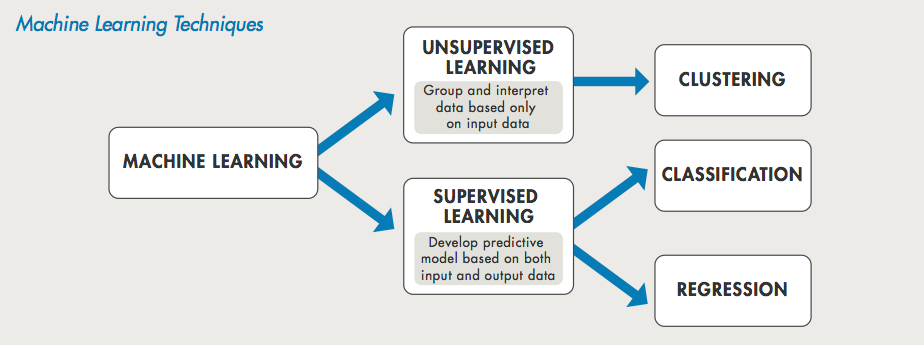
Figur 24: Maskininlärningstekniker
Ett tredje tillvägagångssätt, kallat förstärkningsinlärning (RL), involverar inlärning genom trial and error. Till skillnad från övervakat lärande, där systemet får märkta exempel på korrekta svar, fungerar förstärkningsinlärning i en miljö där det måste upptäcka det optimala beteendet genom interaktion. Systemet, ofta kallat en "agent", testar olika grupper inom denna miljö och får feedback i form av belöningar eller straff. En belöning signalerar att en handling var önskvärd, medan en straff indikerar en oönskad handling. Agentens mål är att lära sig en "policy", som är en mappning från tillstånd (den nuvarande situationen agenten befinner sig i) till handlingar, vilket maximerar dess kumulativa belöning över tid. Till exempel, inom robotstyrning kan RL användas för att lära en robot att gå. Roboten börjar med att ta slumpmässiga steg och får feedback baserat på stabilitet, energieffektivitet och framåtrörelse. Över flera iterationer lär den sig att justera sina ledrörelser för att gå mer effektivt, förbättra balansen och minimera energiförbrukningen (Song et al., 2021).
Djupinlärning tar artificiell intelligens ett steg längre genom att försöka efterlikna hur den mänskliga hjärnan bearbetar information. I grund och botten använder den artificiella neurala nätverk, som är strukturerade på liknande sätt som biologiska neuroner, för att automatiskt lära sig och känna igen mönster i stora mängder data. Till skillnad från traditionell maskininlärning, där människor ofta manuellt behöver välja och definiera de mest relevanta funktionerna för att en modell ska fungera, extraherar djupinlärningsmodeller dessa funktioner på egen hand och förstår rådata utan explicit programmering. Systemet avgör vilka aspekter av data som är viktigast, vilket gör det möjligt att identifiera mönster och fatta beslut med minimal mänsklig intervention.
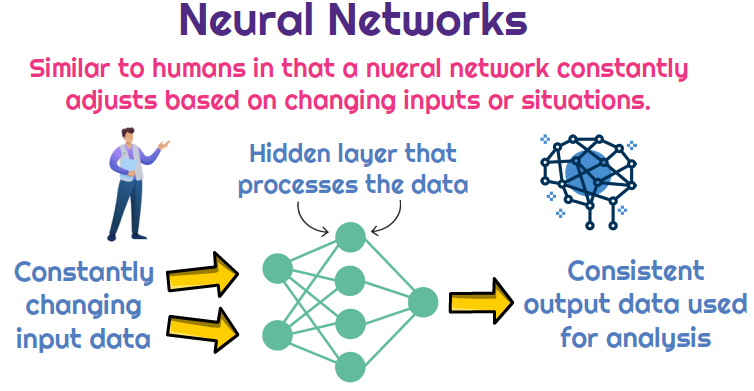
Figur 25: Adaptiva inlärningssystem som bearbetar förändrade indata för att generera konsekvent utdata för analys .
Precis som den mänskliga hjärnan har specialiserade regioner för olika uppgifter, är djupinlärningsmodeller utformade med arkitekturer som fokuserar på specifika typer av data. Vid bearbetning av visuell information, till exempel, känner hjärnans visuella cortex igen objekt genom att upptäcka kanter, former och texturer innan en komplett bild bildas. Inspirerade av detta är faltningsneurala nätverk (CNN) (Jorgecardete, 2025) byggda för att hantera synrelaterade uppgifter och automatiskt lära sig relevanta funktioner från bilder utan behov av manuell inmatning. Till exempel kan CNN användas för ansiktsuttrycksigenkänning genom att analysera ansiktsbilder och identifiera känslor som ilska, lycka eller förvåning. Istället för att kräva att människor manuellt definierar hur varje känsla ser ut, lär sig modellen mönster genom att undersöka tusentals ansiktsbilder. Genom faltnings- och poolningslager extraherar den meningsfulla funktioner som ansiktsmuskelrörelser och uttryck, som sedan bearbetas av helt sammankopplade lager och klassificeras med hjälp av en SoftMax-funktion för att bestämma den mest sannolika känslan.
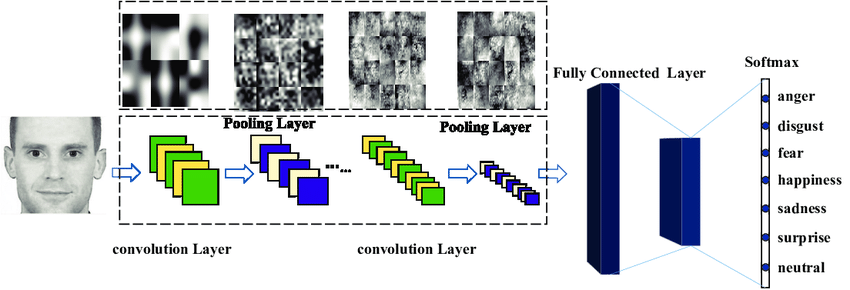
Figur 26: Djupinlärningsbaserad pipeline för ansiktskänsloigenkänning.
Minne och sekvensbearbetning i den mänskliga hjärnan spelar också en avgörande roll i beslutsfattande och mönsterigenkänning, och det är där djupinlärningsmodeller som återkommande neurala nätverk (RNN) och långtidsminnesnätverk (LSTM) kommer in i bilden. Det sätt på vilket människor minns tidigare erfarenheter och använder dem för att påverka nuvarande beslut är vad dessa modeller försöker replikera. De är särskilt effektiva för att hantera sekventiella data, såsom språk, tidsserieförutsägelser eller nätverkstrafikanalys.
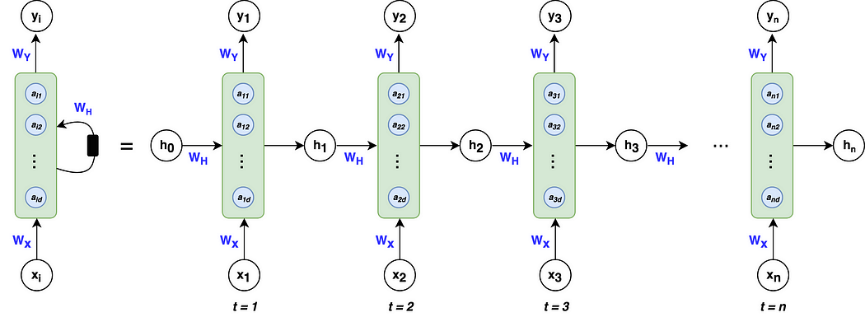
Figur 27: Enkel arkitektur för återkommande neurala nätverk
(Khuong, 2025)
Språkbehandling är ett annat område där djupinlärning utmärker sig, genom att efterlikna hur den mänskliga hjärnan tolkar och genererar tal. Transformatorbaserade modeller som BERT och GPT analyserar stora mängder text och lär sig att förstå språkmönster utan att kräva fördefinierade grammatikregler. Inom maritim cybersäkerhet kan sådana modeller skanna e-postmeddelanden, radiokommunikation och systemloggar för att upptäcka nätfiskeförsök, bedrägliga meddelanden eller obehöriga instruktioner förklädda till normal kommunikation. Istället för att förlita sig på enkel nyckelordsdetektering förstår dessa modeller sammanhang och avsikt, vilket gör dem mycket effektiva för att flagga subtila hot som traditionella regelbaserade system skulle missa.
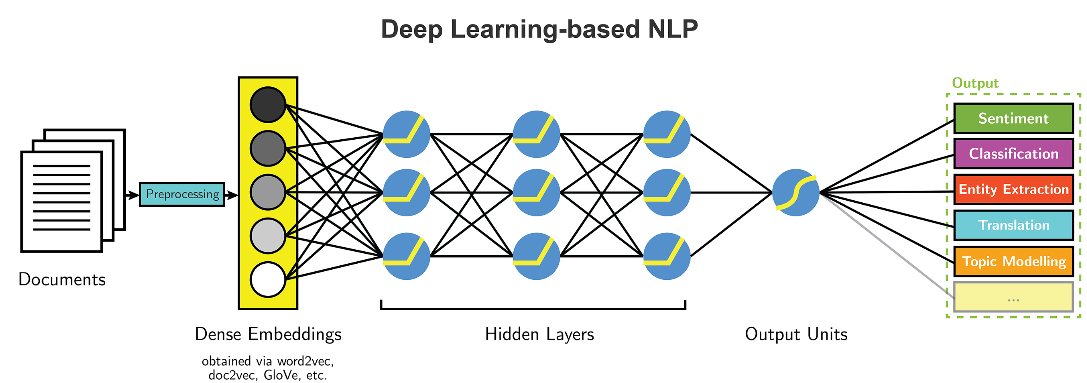
Figur 28: NLP baserad på djupinlärning .
Djupinlärningens kärnstyrka ligger i dess förmåga att automatiskt lära sig relevanta funktioner från stora mängder ostrukturerade data. Till skillnad från traditionella maskininlärningsmetoder, där mänskliga experter måste konstruera funktioner (dvs. bestämma vilka aspekter av data som är viktiga), utmärker sig djupinlärningsmodeller på att urskilja dessa funktioner oberoende av varandra, vilket visas i figur 29. Oavsett om data består av bilder, nätverksloggar, sensoravläsningar eller text, analyserar systemet ett flertal exempel, förfinar gradvis sin förståelse och identifierar autonomt de mest informativa mönstren. Detta eliminerar behovet av manuell funktionsutveckling, en process som kan vara tidskrävande, kräver specialiserad domänexpertis och kanske inte fångar alla nyanser som är gömda i data.
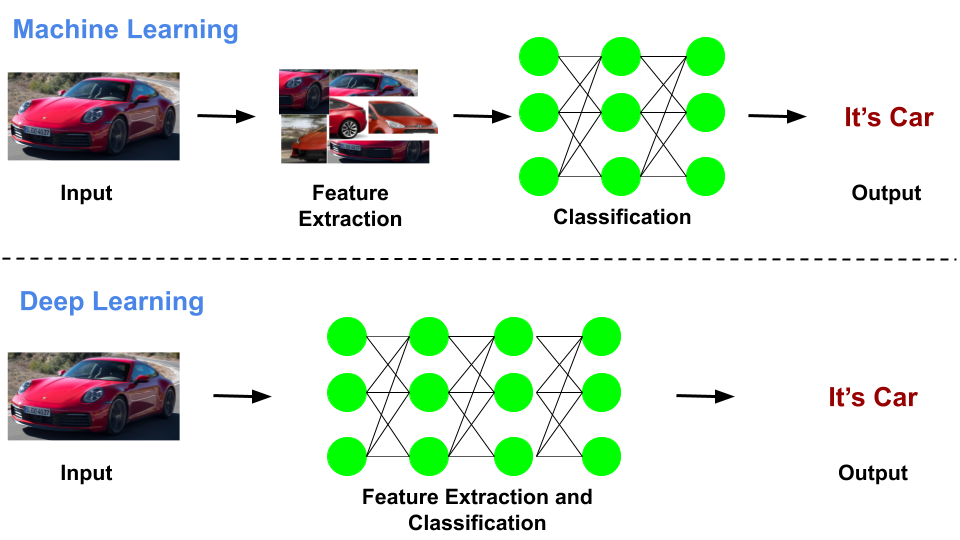
Figur 29: Skillnader mellan maskininlärning och djupinlärning .
Inom sjöfartsindustrin kan AI integreras i cybersäkerhetssystem för att bearbeta de stora mängder data som produceras av fartyg, hamnar och satellitlänkar. Allt eftersom hoten utvecklas kan maskininlärnings- och dumpningsmodeller kontinuerligt uppdatera sig själva med hjälp av ny information och upptäcka risker eller attacker som kanske aldrig uttryckligen har beskrivits av mänskligt skrivna regler. Denna förmåga att anpassa och förfina över tid är det som gör AI så värdefull för att hantera moderna cybersäkerhetsutmaningar. Figur 30 ger en översikt över AI-tillämpningar inom cybersäkerhet.
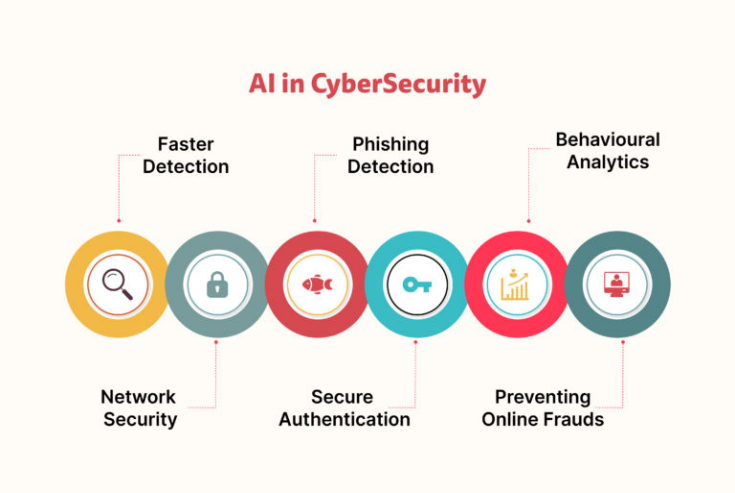
Figur 30: Tillämpningar av AI inom cybersäkerhet .
Modellutveckling för maskininlärning/djupinlärning
Processen att utveckla en maskininlärnings- eller djupinlärningsmodell följer en strukturerad serie steg, från att samla in data till att driftsätta och underhålla modellen. Varje steg spelar en avgörande roll för att säkerställa att systemet kan göra korrekta och tillförlitliga förutsägelser i verkliga miljöer. Nedan följer en detaljerad uppdelning av hela processen, tillsammans med förklaringar för att göra den mer begriplig för de som inte är bekanta med området.
Datainsamling: Insamling av relevant information
Det första steget i alla ML- eller DL-projekt är att samla in data. Utan högkvalitativa data kommer även de bästa algoritmerna att ha svårt att producera användbara resultat. Data kan komma från olika källor, beroende på det aktuella problemet. När det gäller maritim cybersäkerhet kan relevant data till exempel inkludera nätverkstrafikloggar, säkerhetshändelseregister och systemprestandamått. Nätverksloggar fångar kommunikation mellan enheter och hjälper till att identifiera ovanliga mönster som kan tyda på cyberhot. Säkerhetshändelseloggar innehåller varningar som genereras av cybersäkerhetssystem när misstänkt aktivitet upptäcks. Systemprestandadata, såsom CPU-användning eller minnesaktivitet, kan ge insikt i potentiella säkerhetsöverträdelser eller fel. Vilken typ av data som samlas in beror helt på det specifika problem som modellen är avsedd att lösa. För intrångsdetektering kan nätverksdata på paketnivå krävas, medan videofilmer i realtid skulle vara mer relevanta för fartygsövervakning.
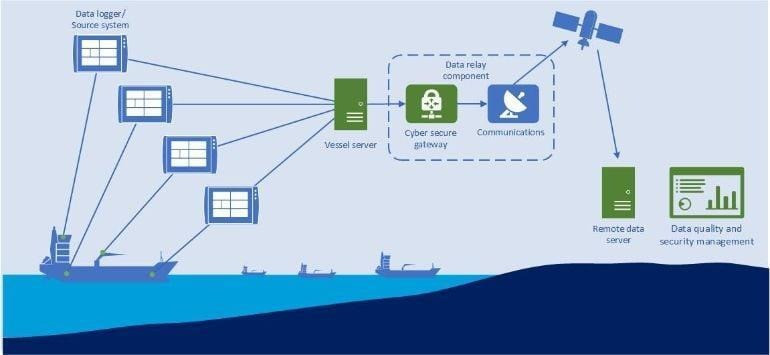
Figur 31: Exempel på datainsamling inom sjöfarten .
Dataförberedelse: Rengöring och formatering av data för analys
Rådata är ofta ostrukturerade, inkonsekventa eller innehåller fel som kan påverka modellens prestanda negativt. För att säkerställa att informationen är användbar måste den genomgå en förberedelsefas. Denna process involverar flera viktiga steg, inklusive hantering av saknade värden, borttagning av brus och standardisering av indata. Saknade värden kan uppstå på grund av felaktiga sensorer eller ofullständiga loggar och måste åtgärdas genom att antingen fylla i dem med uppskattade värden eller kassera ofullständiga poster. Brus, såsom korrupta datapunkter eller irrelevant information, måste tas bort för att förhindra att modellen lär sig felaktiga mönster. Standardisering är ett annat viktigt steg, eftersom data ofta finns i olika format eller enheter. Till exempel kan tidsstämplar i nätverksloggar behöva konverteras till en konsekvent tidszon, eller numeriska värden kan behöva normaliseras för att säkerställa att de är i en jämförbar skala. I strukturerade datamängder, såsom tabeller över nätverksaktivitet, kan denna fas också innefatta att ta bort dubbla poster. För ostrukturerad data som bilder eller text kan förbehandling innebära att ändra storlek på bilder, minska bakgrundsbrus eller konvertera ord till numeriska representationer som modellen kan bearbeta.
Funktionsteknik: Identifiera eller skapa meningsfulla mönster
I traditionell maskininlärning förstår modeller inte i sig vilka aspekter av data som är relevanta. Istället måste experter manuellt definiera de funktioner som är mest användbara för att lösa problemet. Denna process, känd som funktionsutveckling, innebär att man väljer, transformerar eller skapar nya variabler från rådata för att förbättra modellens prestanda. Effektiv funktionsutveckling kan avsevärt förbättra en modells noggrannhet genom att förse den med meningsfull information. Till exempel, i ett intrångsdetekteringssystem kan råa nätverkstrafikloggar innehålla detaljer som IP-adresser, tidsstämplar, paketstorlekar och anslutningsstatus. Dessa råvärden ensamma kanske dock inte är tillräckligt informativa för modellen. För att förbättra detekteringen kan en expert skapa nya funktioner baserat på statistiska mönster eller beteendetrender. En sådan funktion kan vara anslutningsförsöksfrekvensen, där antalet anslutningsförfrågningar från en specifik IP-adress mäts inom ett givet tidsfönster, till exempel 10 sekunder. En plötslig topp i anslutningsförsök kan indikera en brute-force-attack.
Djupinlärning eliminerar dock mycket av behovet av funktionsutveckling. Istället för att förlita sig på mänsklig intuition för att definiera viktiga funktioner lär sig djupa neurala nätverk automatiskt mönster direkt från rådata. Detta är en av DL:s största fördelar jämfört med traditionell maskininlärning. Det kan bearbeta ostrukturerad data, såsom bilder, ljud och text, utan att kräva explicita regler för funktionsextraktion. Till exempel, inom bildigenkänning, kan ett faltningsneuralt nätverk lära sig att upptäcka kanter, texturer och komplexa objekt utan mänsklig inblandning, vilket gör det mycket effektivt för tillämpningar som att analysera övervakningsfilmer i realtid på fartyg.
Modellval: Att välja rätt algoritm
När data har förberetts är nästa steg att välja den bästa modellen för problemet. Valet av algoritm beror på faktorer som datatyp, uppgiftens komplexitet och tillgängliga beräkningsresurser. I traditionell maskininlärning används ofta modeller som beslutsträd, stödvektormaskiner (SVM) eller slumpmässiga skogar, särskilt när man arbetar med strukturerade datamängder. Dessa modeller kräver manuellt definierade funktioner men kan fungera bra med relativt små datamängder.
Djupinlärningsmodeller är å andra sidan kraftfullare men kräver stora mängder data och beräkningsresurser. CNN:er är särskilt effektiva för bildrelaterade uppgifter, som att upptäcka objekt i maritima övervakningsbilder. Återkommande neurala nätverk eller transformatorer är bättre lämpade för sekventiell data, som att analysera kommunikationsloggar över tid för att upptäcka mönster av cyberhot. Att välja rätt modell är ett avgörande steg, eftersom fel val kan leda till dålig prestanda eller ineffektiv beräkning.
Modellträning: Lärande från data
Efter att ha valt en modell är nästa steg att träna den för att göra förutsägelser. Träning innebär att mata in data i modellen, låta den lära sig mönster och justera dess interna parametrar för att förbättra noggrannheten. Modellen gör initiala förutsägelser, och en förlustfunktion mäter hur långt dessa förutsägelser är från de korrekta svaren. Om förlusten är hög betyder det att modellen gör dåliga förutsägelser. För att förbättra uppdateras modellens parametrar (så kallade vikter) genom en optimeringsprocess, såsom gradient descent, för att gradvis minska förlusten. Denna iterativa process fortsätter tills modellen når en acceptabel noggrannhetsnivå.
Vid övervakad inlärning tränas modellen på märkta data, vilket innebär att varje inmatning har en känd korrekt utmatning (t.ex. klassetiketter i klassificering eller målvärden i regression). Målet är att minimera skillnaden mellan förutsägelser och sanna etiketter, vanligtvis med hjälp av förlustfunktioner som korsentropi (för klassificering) eller medelkvadratfel (för regression).
Vid djupinlärning är denna process beräkningsintensiv och kräver stora datamängder. Till skillnad från traditionell maskininlärning, där träning kan slutföras på minuter eller timmar, kan träning av djupa neurala nätverk ta dagar eller till och med veckor, beroende på arkitekturens komplexitet och datamängden. För att hantera denna komplexitet tillhandahåller ramverk för djupinlärning som TensorFlow och PyTorch effektiva verktyg för modellbyggande, automatisk differentiering och hårdvaruacceleration. Dessa bibliotek stöder dynamiska beräkningsgrafer och erbjuder ett brett utbud av förbyggda funktioner för att optimera modeller. Hyperparameterjustering, justering av parametrar som inlärningshastighet, batchstorlek och antal träningsepoker är avgörande för att säkerställa att modellen konvergerar effektivt.
Vid oövervakad inlärning tränas modellen på omärkt data, vilket innebär att den inte har fördefinierade kategorier eller korrekta svar. Istället för att förutsäga specifika resultat identifierar modellen mönster, strukturer eller kluster i data.
- Klusteralgoritmer grupperar liknande datapunkter baserat på avståndsmått.
- Tekniker för dimensionalitetsreduktion kan komprimera högdimensionell data till en lägre dimensionell form samtidigt som viktig information bevaras.
- Generativa modeller lär sig att generera nya dataprover som liknar träningsfördelningen.
Eftersom ingen explicit förlustfunktion jämför förutsägelser med marksanning, involverar träning ofta oövervakade mål, såsom att minimera rekonstruktionsfel eller maximera variansen mellan kluster.
Modellvalidering och testning: Utvärdering av prestanda
När träningen är klar är det viktigt att testa hur väl modellen generaliserar till nya, osynliga data. Detta görs genom validering och testning, med hjälp av separata datamängder som inte ingick i träningsprocessen. Om en modell presterar bra under träning men misslyckas med att göra korrekta förutsägelser på nya data, är den sannolikt överanpassad, vilket innebär att den har inlärt mönster som är för specifika för träningsmängden och inte generaliserar väl till osynliga data. Prestandamätningar som noggrannhet, precision, återkallelse och F1-poäng används för att utvärdera modellens effektivitet. Noggrannhet mäter andelen korrekta förutsägelser, medan precision och återkallelse ger insikter i modellens tillförlitlighet när det gäller att upptäcka specifika kategorier, såsom cyberhot. F1-poängen balanserar precision och återkallelse, vilket erbjuder en mer omfattande bedömning. Om modellens prestanda är otillfredsställande kan justeringar göras genom att samla in mer data, förfina funktionsvalet (i ML) eller finjustera hyperparametrar.
Implementering och kontinuerlig övervakning: Användning av modellen i den verkliga världen
När modellen uppnår tillfredsställande noggrannhet och robusthet driftsätts den i en verklig miljö där den börjar göra förutsägelser baserat på realtidsdata. Driftsättningen är dock inte det sista steget, kontinuerlig övervakning och underhåll är nödvändigt för att säkerställa fortsatt prestanda. Inom maritim cybersäkerhet, till exempel, dyker nya cyberhot upp ständigt, och en modell som tränats på tidigare attackmönster kan bli föråldrad med tiden. För att förhindra prestandaförsämring behöver modeller regelbunden omskolning på uppdaterade data, kontinuerlig övervakning av fel och förbättringar för att anpassa sig till föränderliga förhållanden. Underlåtenhet att göra detta kan leda till föråldrade förutsägelser, säkerhetsbrister eller minskad noggrannhet.
En översikt över träningsprocessen för en övervakad maskininlärningsmodell visas i figur 32.
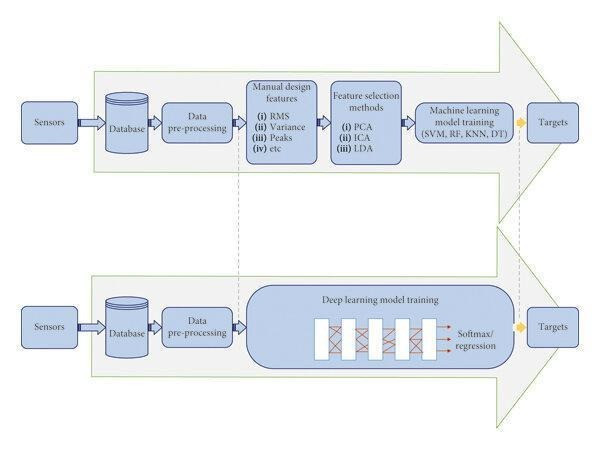
Figur 32: Översikt över träningspipelines för ML/DL-modeller .
Tillämpningar av AI inom maritim cybersäkerhet
Intrångsdetekteringssystem (IDS)
Ett intrångsdetekteringssystem (IDS) är en säkerhetslösning utformad för att upptäcka obehörig åtkomst, skadlig aktivitet och potentiella hot genom att kontinuerligt övervaka nätverkstrafik, användarbeteende och systemloggar. Placeringen av ett IDS beror på dess typ. Ett nätverksbaserat IDS (NIDS) placeras vanligtvis mellan brandväggen och det interna nätverket, som visas i figur 33, där det inspekterar all inkommande och utgående trafik för misstänkta mönster innan de når kritiska system. Om en angripare kringgår brandväggen upptäcker IDS avvikelser och genererar en varning för vidare utredning. Å andra sidan installeras ett värdbaserat IDS (HIDS) direkt på enskilda enheter, såsom ett fartygs navigationssystem, servrar eller arbetsstationer, där det övervakar systemloggar, filintegritet och användaraktivitet för att upptäcka skadliga förändringar. I maritima sammanhang spelar IDS en avgörande roll för att skydda kritiska operationer såsom lasthantering, navigation och kommunikationsnätverk (MarPoint, 2025).
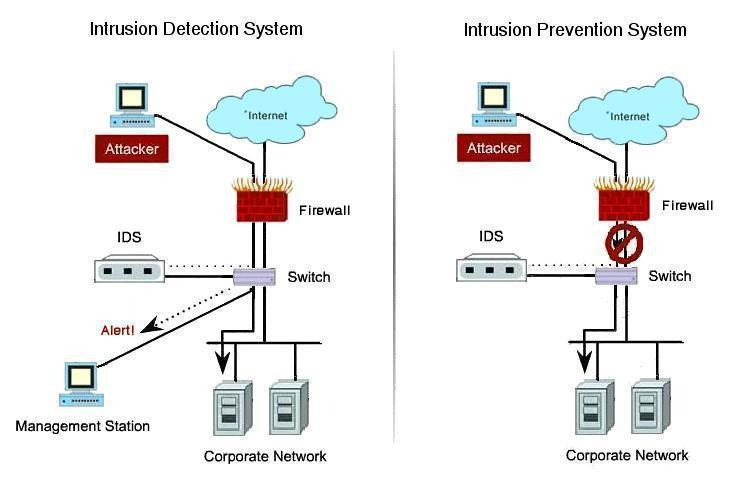
Figur 33: Intrångsdetekteringssystem
DS använder två huvudsakliga metoder för att upptäcka skadligt beteende:
- Signaturbaserad detektion: Jämför observerade aktiviteter mot en databas med kända attacksignaturer med hjälp av strängmatchningstekniker. Denna metod är mycket effektiv för att identifiera tidigare kända hot men misslyckas med att upptäcka nya eller utvecklande attacker.
- Beteendebaserad detektion: Övervakar avvikelser från normala aktivitetsmönster, vilket gör att den kan identifiera nya eller okända hot. Även om den är mer anpassningsbar kan denna metod generera fler falska positiva resultat.
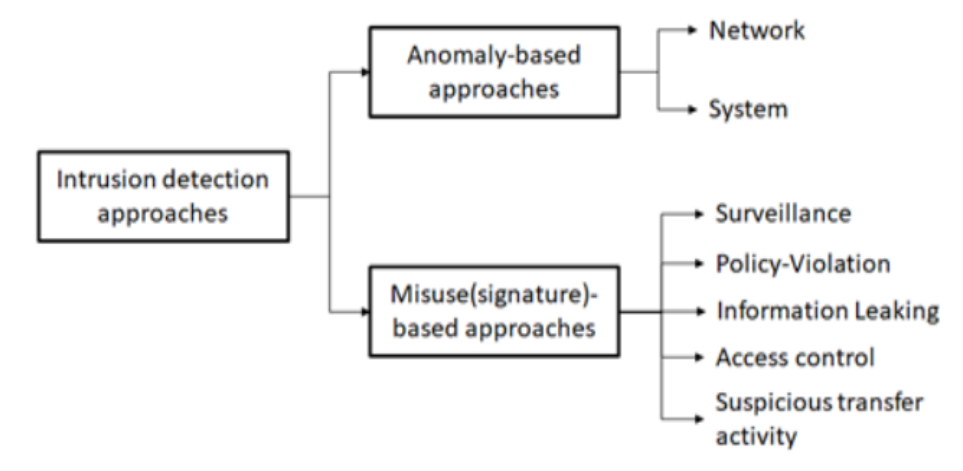
Figur 34: Klassificering av metoder för intrångsdetektering .
AI-drivna IDS förbättrar säkerheten genom att analysera data i realtid, identifiera avvikelser och skilja typiska nätverksmönster från skadliga intrång. Genom att integrera både övervakade metoder, som förlitar sig på kända attacksignaturer, och oövervakade metoder, som upptäcker ovanliga avvikelser från normal aktivitet, minskar AI-baserade IDS falsklarm och förbättrar detekteringsnoggrannheten.
AI-drivna IDS använder maskininlärningsalgoritmer för att upptäcka hot mer exakt. Dessa algoritmer hjälper IDS att känna igen både kända och okända cyberattacker.
Övervakad inlärning: Denna metod tränar en AI-modell med hjälp av tidigare attackdata märkta som "säkra" eller "farliga". AI:n lär sig av dessa data och tillämpar sedan sin kunskap för att upptäcka nya hot.
Oövervakad inlärning: Till skillnad från övervakad inlärning kräver den här metoden inte märkta data. Istället identifierar AI ovanlig aktivitet genom att upptäcka mönster som inte matchar normalt beteende.
Ett vanligt problem med traditionella IDS är falska positiva resultat, där ofarlig nätverksaktivitet felaktigt flaggas som ett hot. AI minskar falsklarm genom att lära av tidigare misstag och förbättra deras noggrannhet över tid. AI kan också kombinera flera detekteringsmetoder för att förbättra resultaten. Genom att blanda signaturbaserad och beteendebaserad detektering minimerar AI-drivna IDS fel samtidigt som de bibehåller en stark säkerhet. Vissa AI-modeller använder till och med förstärkningsinlärning, en teknik där AI kontinuerligt justerar sina detekteringsregler baserat på feedback.
Eftersom ett IDS är ett passivt system vidtar det inte direkta åtgärder mot upptäckta hot. Istället genererar det varningar för mänskliga operatörer eller integrerar det med säkerhetsinformations- och händelsehanteringssystem (SIEM) för vidare analys och respons. Intrång kan komma från både externa och interna källor, vilket gör IDS till en viktig del av cybersäkerhetsstrategier inom olika branscher.
Intrångsskyddssystem (IPS)
Ett intrångsskyddssystem (IPS) är en säkerhetsteknik som är utformad för att upptäcka och proaktivt förhindra skadlig aktivitet inom ett nätverk eller system. Till skillnad från ett IDS, som passivt övervakar och varnar för misstänkt aktivitet, vidtar ett IPS direkta åtgärder för att blockera, mildra eller stoppa attacker i realtid. I huvudsak, medan IDS är ett övervakningsverktyg, fungerar IPS som ett kontrollsystem som aktivt förhindrar hot innan de orsakar skada i operationer som navigering, lasthantering eller kommunikationslänkar (Sowmya och Anita, 2023).
IPS distribueras vanligtvis bakom en brandvägg men före interna system, vilket gör att den kan inspektera både inkommande och utgående trafik som visas i figur 35. Till skillnad från en brandvägg, som främst filtrerar baserat på fördefinierade regler, använder en IPS avancerad analys för att upptäcka och blockera dynamiska hot i realtid. I vissa nätverksarkitekturer fungerar IPS tillsammans med IDS, där IDS upptäcker och varnar administratörer, medan IPS vidtar aktiva åtgärder för att neutralisera hot.
Figur 35: System för intrångsskydd
Viktiga åtgärder som utförs av en IPS:
- Skickar aviseringar till administratörer.
- Att släppa potentiellt skadliga paket.
- Blockera anslutningar från skadliga källor.
- Starta om komprometterade anslutningar för att förhindra ytterligare utnyttjande.
- AI-driven IPS för förbättrad säkerhet
Moderna IPS-lösningar utnyttjar AI-driven analys och realtidsdataflöden för att upptäcka och blockera hot mer effektivt. Genom att kontinuerligt lära sig av historiska och nya attackmönster förbättrar dessa system sin noggrannhet och minskar falska positiva resultat. Genom att integrera AI-driven analys med realtidsdataflöden förbättrar moderna IPS säkerheten genom att isolera infekterade slutpunkter, blockera skadliga IP-adresser och dynamiskt modifiera brandväggsregler för att förhindra lateral spridning av hot över nätverk ombord och i hamnar (Maritime Intelligence, 2025). Ett anmärkningsvärt exempel på detta är Ciscos implementering av en nätverksbaserad IPS, som effektivt upptäckte och mildrade interna nätverkshot innan de kunde orsaka dataförlust eller serviceavbrott. Genom att analysera både inkommande och utgående trafik inom företaget tillhandahöll Ciscos IPS ett kritiskt försvarslager, vilket demonstrerade effektiviteten hos AI-förstärkta IPS i att proaktivt neutralisera cyberhot innan de eskalerar (Contentree, 2025).
System för intrångsdetektering och -förebyggande med öppen källkod
I takt med att cyberhoten fortsätter att utvecklas har öppen källkods-IDS och IPS blivit viktiga verktyg för att övervaka och säkra nätverk. Två av de mest använda öppen källkods-IDS/IPS-lösningarna är Snort och Suricata, som båda tillhandahåller hotdetektering och -förebyggande i realtid samtidigt som de erbjuder flexibilitet och anpassningsmöjligheter.
Snort: En regelbaserad IDS/IPS
Snort, ursprungligen utvecklat av Martin Roesch 1998, är ett signaturbaserat IDS/IPS som kan utföra trafikanalys och paketloggning i realtid på IP-nätverk. Det använder ett regelbaserat språk som gör det möjligt att integrera signaturer, protokoll och anomalibaserade detekteringstekniker för att identifiera ett brett spektrum av cyberhot, inklusive denial-of-service (DoS)-attacker, buffertöverflöden, stealth-portskanningar och CGI-attacker.
Snort fungerar genom att sniffa nätverkspaket med hjälp av bibliotek som libpcap och WinPcap och kan fungera i tre primära lägen:
- Paketsniffningsläge – Samlar in och övervakar rå nätverkstrafik.
- Paketloggningsläge – Registrerar nätverkspaket för analys och felsökning.
- Intrångsdetekteringsläge – Jämför nätverksaktivitet med fördefinierade regler och skickar varningar när hot upptäcks.
En viktig fördel med Snort är dess anpassningsbara regelspråk, vilket gör det möjligt för användare att definiera anpassade säkerhetspolicyer. Det integreras väl med brandväggar för att ge ett extra försvarslager, vilket gör det till ett värdefullt verktyg för intern nätverksövervakning.
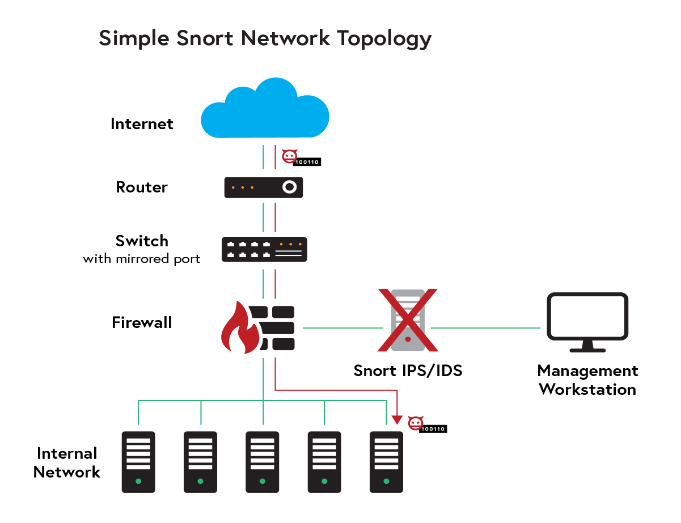
Figur 36: Enkel Snort-nätverkstopologi .
Suricata: Högpresterande IDS/IPS och nätverkssäkerhetsövervakning (NSM)
Suricata, utvecklat av Open Information Security Foundation (OISF), är nästa generations IDS/IPS som bygger vidare på traditionell nätverkssäkerhetsövervakning med djup paketinspektion (DPI) och inbyggd multitrådning. Till skillnad från Snort, som främst fokuserar på signaturbaserad detektion, kan Suricata analysera flera protokolllager (inklusive HTTP, TLS, DNS och SMB) för att upptäcka mer sofistikerade och undvikande hot.
En av dess viktigaste fördelar är dess förmåga att bearbeta nätverkstrafik med höga hastigheter tack vare sin flertrådade arkitektur, vilket gör den väl lämpad för distributioner på företagsnivå och molnbaserade säkerhetsmiljöer. Dessutom integreras den sömlöst med olika säkerhetsinformations- och händelsehanteringsverktyg och dataanalysplattformar, vilket möjliggör visualisering och analys av potentiella hot i realtid.
En annan unik funktion hos Suricata är dess funktion för nätverkssäkerhetsövervakning (NSM), som gör det möjligt att extrahera metadata från nätverkstrafik utöver att upptäcka intrång. Denna funktion hjälper cybersäkerhetsteam att utreda säkerhetsincidenter mer effektivt och ger djupare insikter i nätverksbeteende.
Djup paketinspektion för avancerad hotdetektering
Djup paketinspektion (DPI) går utöver att undersöka paketrubriker genom att analysera nyttolasten och metadata för överförda data, vilket ger detaljerad insyn i protokoll, innehåll på applikationslagret och användardefinierat beteende. Till skillnad från traditionell paketfiltrering, som bara inspekterar IP- och TCP/UDP-rubriker, undersöker DPI hela paketet, vilket gör att det kan identifiera skadliga nyttolaster, policyöverträdelser eller krypterade hot som enklare, endast-rubrikbaserade filtreringssystem ofta förbiser (Leslie, 2020).
En DPI-motor fungerar genom att inspektera paketinnehåll i realtid med hjälp av signaturbaserad matchning, heuristik och avvikelsedetektering för att filtrera trafik. Den kan klassificera paket baserat på protokoll, applikationstyp och innehåll, vilket är avgörande för att identifiera hot som är dolda i nätverkstrafik som ser legitim ut. Till exempel kan DPI skilja mellan normal HTTP-trafik och en HTTP-baserad attack, såsom SQL-injektion eller kommando-och-kontrollkommunikation med skadlig kod. DPI kan också dekryptera SSL/TLS-trafik för säkerhetsanalys, vilket säkerställer att krypterade paket inte kringgår säkerhetskontroller. Många moderna cyberattacker utnyttjar krypterade nyttolaster för att dölja skadlig aktivitet, men AI-driven DPI kan identifiera beteendeavvikelser även i krypterade sessioner, såsom ovanliga dataöverföringsmönster eller trafik till kända skadliga domäner.
I kombination med AI eller maskininlärningsalgoritmer förbättrar DPI hotdetektering genom att lära sig av tidigare nätverksmönster och upptäcka nolldagsattacker eller avancerade ihållande hot som kringgår traditionella säkerhetsåtgärder.
Om en avvikelse upptäcks kan DPI-system vidta automatiserade åtgärder, såsom att isolera en komprometterad slutpunkt, avsluta misstänkta anslutningar eller dynamiskt omkonfigurera brandväggsregler för att förhindra spridning av skadlig kod över maritima IT- och OT-nätverk (Ipoque, 2025).
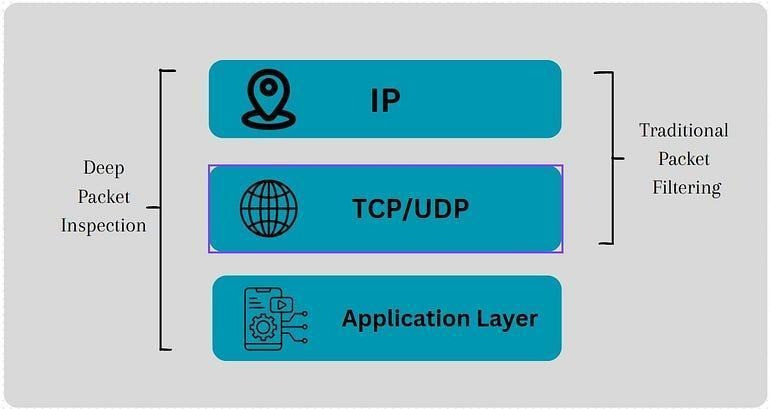
Figur 37: Jämförelse av traditionell paketfiltrering kontra djup paketinspektion
(Nethmal, 2025).
Generativa adversariella nätverk för dataökning och försvar
Generativa adversarialnätverk (GAN) består av två konkurrerande neurala nätverk: en generator som skapar syntetiska data och en diskriminator som utvärderar dess äkthet, vilket visas i figur 38. GAN, som ursprungligen utvecklades för bildsyntes och generering av djupförfalskningar, har visat sig vara mycket effektiva inom cybersäkerhetsapplikationer, särskilt inom intrångsdetektering, adversarial träning och analys av skadlig kod. Genom att generera mycket realistiska attackprover förbättrar GAN maskininlärningsbaserade säkerhetsmodeller, vilket gör att de kan känna igen både kända och tidigare osedda hot (Zhao, 2024).
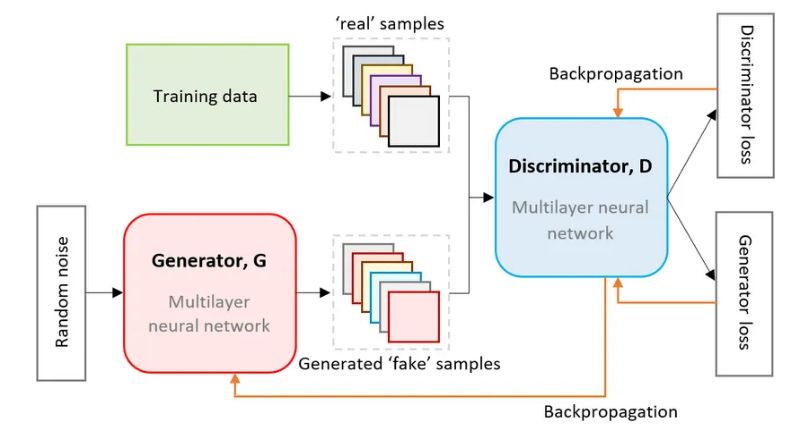
Figur 38: Arkitektur för ett GAN-nätverk
(TVS, 2025).
En av tillämpningarna av Generative Adversarial Networks (GAN) inom cybersäkerhet är deras förmåga att producera syntetiska skadliga mönster eller exploateringsförsök, vilket effektivt utökar träningsdatamängder för IDS och IPS. Traditionella IDS/IPS-lösningar förlitar sig på signaturbaserad detektering, som kämpar mot nolldagshot och polymorf skadlig kod som kontinuerligt utvecklas. Genom att träna IDS/IPS-modeller på GAN-genererade adversarialprover kan cybersäkerhetssystem förbättra sin motståndskraft mot tidigare okända attackstrategier. GAN har också använts i automatiserade penetrationstester, där de genererar variationer i nätfiske-e-postmeddelanden, brute-force-attacker eller exploateringsskript för att testa en organisations säkerhetsställning. Genom att simulera verkliga cyberhot möjliggör GAN-driven penetrationstestning kontinuerlig säkerhetsbedömning utan att utsätta system för faktiska attacker.
Utöver intrångsdetektering används GAN:er ofta för avvikelsedetektering. En GAN-baserad avvikelsedetektor lär sig först den statistiska fördelningen av normalt nätverksbeteende och upptäcker sedan subtila avvikelser som kan tyda på smygande cyberhot, obfuskerad skadlig kod eller försök till dataexfiltrering. Till skillnad från traditionell regelbaserad avvikelsedetektering anpassar sig GAN:er kontinuerligt till nya nätverksförhållanden, vilket minskar falska positiva resultat samtidigt som detekteringsnoggrannheten förbättras. Denna förmåga att känna igen avvikande beteenden är särskilt användbar för att upptäcka avancerade ihållande hot som blandas in i legitim trafik.
En annan innovativ användning av GAN:er är inom adversariell träning, där cybersäkerhetsmodeller härdas mot undvikande attacktekniker. Angripare använder ofta adversariella maskininlärningstekniker för att manipulera IDS/IPS-modeller och skapa attacknyttolaster som kringgår traditionella detekteringsmekanismer. Genom att träna GAN:er för att simulera adversariella attacker kan cybersäkerhetsförsvar stresstestas och förstärkas, vilket säkerställer robusthet mot adversariella attacker.
Avvikelsedetektering
Medan IDS ofta fokuserar på specifika typer av intrång, är avvikelsedetektering en bredare teknik som identifierar alla atypiska eller malplacerade beteenden, vilket potentiellt kan signalera ett systemfel eller cyberhot. Genom att övervaka indikatorer som systemresursanvändning, nätverkslatens och inloggningsförsök bygger algoritmer för avvikelsedetektering en baslinje för hur "normal" aktivitet ser ut. Varje större avvikelse från detta mönster kan representera ett säkerhetsproblem eller operativt problem. I många maritima tillämpningar kan AI-system initiera automatiserade motåtgärder, såsom att isolera komprometterade nätverk eller justera brandväggsregler för att snabbt begränsa potentiella hot (Ribeiro et al., 2023). Denna snabba, autonoma respons är avgörande i maritima operationer, där små incidenter snabbt kan eskalera till storskaliga logistiska eller säkerhetsutmaningar om de inte åtgärdas omedelbart.
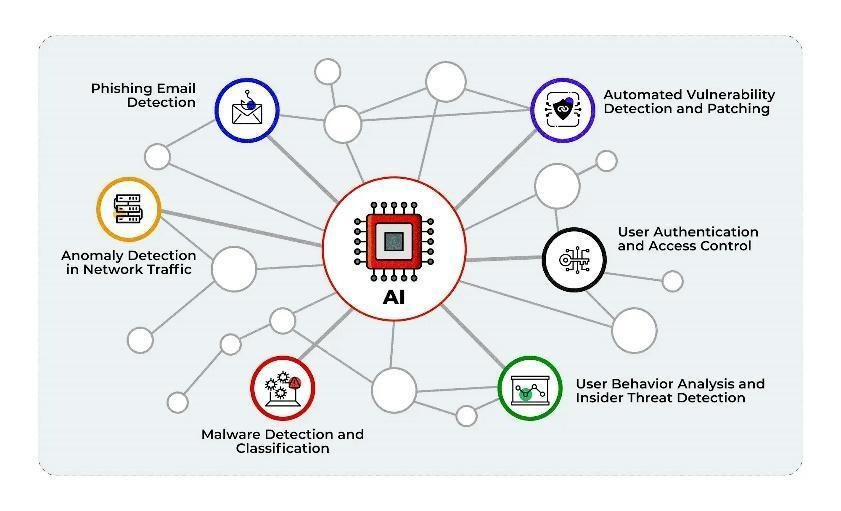
Figur 39: Tillämpningar av avvikelsedetektering inom cybersäkerhet .
Prediktiv analys för cyberhot
Prediktiv analys använder historiska data och beteendemönster för att förutse potentiella svagheter och framtida attackstrategier, och erbjuder därmed proaktivt cyberförsvar. Genom att undersöka stora volymer av tidigare incidenter kan AI-modeller isolera faktorer som ofta föregår attacker (Merrick, 2022). I praktiken simulerar dessa algoritmer olika anfallsscenarier för att identifiera svaga punkter, vilket ger säkerhetsteam en tydlig bild av var de bör allokera resurser först. Genom att tilldela riskpoäng till olika hot kan sjöfartsoperatörer prioritera och stärka sitt försvar för att hålla kritiska system säkra. Denna metod minskar inte bara omedelbara risker utan förbättrar också den långsiktiga motståndskraften mot utvecklande cyberhot (Meijer och Wessels, 2019). Prediktiv analys integreras ofta med säkerhetsinformations- och händelsehanteringssystem för att korrelera realtidsdata från flera källor, vilket förbättrar noggrannheten i hotförutseendet. I kombination med intrångsdetekterings- och förebyggande system kan dessa modeller utlösa automatiserade försvarsåtgärder för att blockera hot innan de materialiseras.
Potentiella sårbarheter och fiendtliga attacker
Även om AI avsevärt stärker den maritima cybersäkerheten, introducerar den också potentiella sårbarheter som motståndare kan försöka utnyttja. Motståndsattacker innebär att man matar AI-modeller med noggrant utformade data, lurar dem att göra felaktiga bedömningar eller ignorerar verkliga hot (Qiu et al., 2019). Till exempel kan illvilliga aktörer kamouflera skadlig programvara så att ett AI-baserat detekteringssystem felklassificerar den som godartad. En annan fara är modellförgiftning, där angripare injicerar falsk eller vilseledande information i träningsdata, vilket gradvis försämrar modellens noggrannhet.
För att skydda sig mot dessa taktiker vidtar sjöfartsorganisationer ofta en rad skyddsåtgärder. En är regelbunden omskolning med data som verifierats för integritet, vilket säkerställer att modellen förblir korrekt och uppdaterad. Konkurrerande utbildning, där modellen avsiktligt exponeras för vilseledande indata under utvecklingen, hjälper den också att lära sig att identifiera och motstå manipulativa attacker. Slutligen är robusta datapipelines och åtkomstkontroller avgörande för att skydda både utbildningsprocessen och den operativa användningen av AI, och bevara de många fördelar den medför för sjöfartssäkerhet och effektivitet.
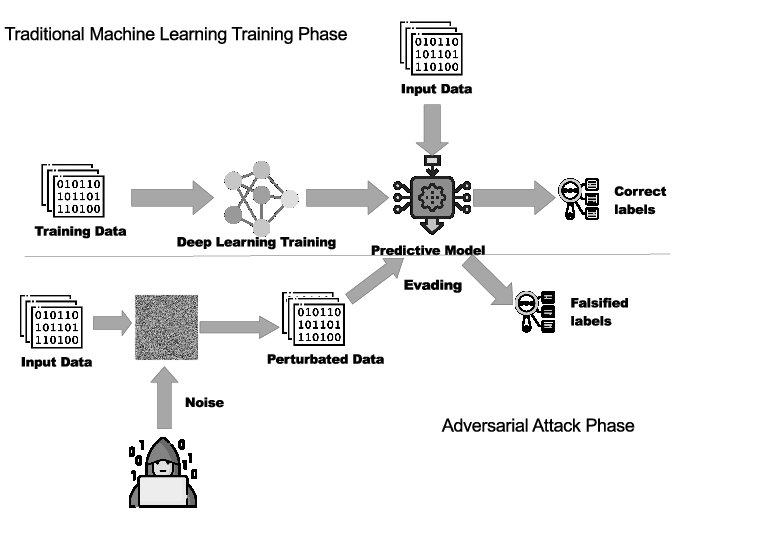
Figur 40: Exempel på en fiendtlig attack
(Catak & Sule, (2020).
AI-utmaningar och begränsningar
AI-drivna system erbjuder förbättrade möjligheter att identifiera och mildra cyberhot, men de introducerar en rad utmaningar och begränsningar som organisationer måste ta itu med för att maximera sin effektivitet.
Datakvalitet och tillgänglighet
En viktig fråga gäller datakvalitet och tillgänglighet. Eftersom dessa system i hög grad är beroende av stora volymer högkvalitativa data för att träna och förbättra sina detekteringsalgoritmer, kan eventuella felaktigheter eller luckor i dessa data leda till felaktiga förutsägelser eller missade hot. Organisationer stöter ofta på svårigheter när de försöker integrera data från flera nätverkssegment och olika källor (Palo Alto Networks, 2025). Detta kan resultera i en ofullständig bild av användaraktiviteter och systembeteende, vilket skapar luckor i hotdetekteringen.
Falskt positiva resultat och varningströtthet
En annan utmaning uppstår på grund av den höga mängden falska positiva resultat. Även om AI syftar till att minska dessa felaktiga varningar kan den fortfarande generera en flod av varningar som överväldigar säkerhetsteam. Denna situation kan orsaka larmtrötthet, där säkerhetspersonal börjar förbise potentiellt viktiga varningar på grund av det konstanta inflödet av lågriskmeddelanden (Olateju et al., 2024). Att hantera och utreda dessa många varningar kräver avsevärd tid och resurser, vilket potentiellt kan avleda uppmärksamheten från legitima hot.
Komplexitet och brist på tolkningsbarhet
Komplexitet och tolkningsbarhet utgör ytterligare hinder. Moderna AI-tekniker, särskilt djupinlärning, kan ge resultat genom ogenomskinliga beslutsprocesser. Säkerhetsanalytiker kan ha svårt att lita på eller agera på varningar när de inte kan förstå hur eller varför AI-modellen kom fram till en viss slutsats (Digital Leaders, 2025). Som ett resultat är det avgörande att säkerställa att systemet ger tydliga förklaringar och motiveringar för att bygga förtroende för AI-drivna säkerhetsverktyg.
Integration med befintliga system
I många organisationer är integrationen med befintliga system allt annat än smidig. AI-drivna system måste fungera sömlöst med en organisations befintliga säkerhetsinfrastruktur, vilket kan innebära kompatibilitetsproblem och kräva betydande teknisk expertis. Äldre system behöver ofta uppgraderas innan de kan hantera databehandlingskraven och avancerad analys från AI. Dessa krav ökar inte bara komplexiteten i implementeringen utan skapar också ytterligare kostnader och förlängda tidslinjer för implementering.
Sårbarhet för fientliga attacker
AI-modeller kan i sig vara sårbara för kontradiktoriska attacker, där illvilliga aktörer avsiktligt manipulerar indata för att lura systemet. Detta inkluderar att introducera vilseledande mönster eller signaler som gör att AI:n felklassificerar hot eller ger obehörig åtkomst. Att mildra dessa attacker kräver ständig övervakning och uppdateringar för att säkerställa att modellerna förblir robusta inför utvecklande kontradiktoriska tekniker (MetaCompliance, 2025).
Bias i AI-modeller
Bias inom AI-modeller är ytterligare ett problem. Om träningsdata är snedvriden eller återspeglar vissa fördomar kan IDS orättvist flagga specifika grupper, typer av aktiviteter eller användarbeteenden. Detta kan leda inte bara till etiska problem utan också till suboptimala säkerhetsresultat, eftersom snedvridet fokus kan göra att systemet missar bredare hot (ISC², 2024). Att identifiera och mildra bias är därför avgörande för att säkerställa rättvisa och upprätthålla integriteten i detekteringsprocessen.
Utmaningar inom regelverk och efterlevnad
Regelkrav och efterlevnadskrav medför ytterligare en komplexitet. Många branscher, inklusive sjöfartssektorn, måste följa strikta lagar om dataskydd och cybersäkerhet för att säkerställa säker hantering av användar-, kund- och operativa data. AI-drivna lösningar måste generera tydliga revisionsspår och erbjuda tillräcklig transparens för att bevisa efterlevnad under revisioner, vilket ökar administrativa och tekniska bördor i implementeringsprocessen (Ethico, 2024). Efterlevnad av ramverk som NIST Cybersecurity Framework, ISO 27001 och ENISA-riktlinjerna, bland andra, är avgörande för att säkerställa säker och laglig implementering av AI-förstärkta cybersäkerhetssystem.
Höga implementerings- och underhållskostnader
Kostnaden är också en viktig faktor. De initiala kostnaderna för specialiserad hårdvara, programvarulicenser och professionella tjänster kan vara höga, och löpande underhåll, uppdateringar och modellutbildning innebär kontinuerliga utgifter. Som ett resultat kan mindre organisationer ha svårt att rättfärdiga eller ha råd med den långsiktiga investering som krävs för att driftsätta och underhålla AI-drivna funktioner i stor skala (Modern Diplomacy, 2024).
Brist på skickliga yrkesverksamma
Dessutom finns det ofta en märkbar brist i den expertis som krävs för att hantera AI-baserade säkerhetssystem. Organisationer kan ha svårt att rekrytera eller utbilda tillräckligt många yrkesverksamma med både AI-kunskap och säkerhetserfarenhet. Att hålla personalen uppdaterad om snabbt utvecklande AI-tekniker och cybersäkerhetshot kräver ett engagemang för kontinuerliga utbildningsprogram (Technology Magazine, 2024).
Integritetsproblem
Slutligen kommer integritetsfrågor i förgrunden när man använder AI-drivna IDS för att övervaka användarbeteende. Att samla in och analysera sådan detaljerad information kan strida mot dataskyddslagar om den inte hanteras varsamt. Organisationer måste säkerställa att användardata samlas in, lagras och behandlas på ett sätt som respekterar individers integritetsrättigheter och följer regler som GDPR (Stewart, 2024). För att uppnå denna balans krävs det att man inhämtar användarnas samtycke, tydligt anger övervakningspolicyer och upprätthåller rigorösa datahanteringsrutiner.
Genom att ta itu med dessa utmaningar, från datakvalitet och falska positiva resultat till tolkningsbarhet, kostnader, partiskhet, kompetensbrister och integritetsproblem, kan organisationer utnyttja den fulla potentialen hos AI-drivna lösningar samtidigt som de upprätthåller robust säkerhet och regelefterlevnad.
Sammanfattningsvis förändrar AI den maritima cybersäkerheten genom att förbättra hotdetektering, förhindra cyberattacker och optimera fartygsoperationer. Genom maskininlärning och djupinlärning hjälper AI-drivna system som IDS, IPS och DPI till att övervaka, analysera och reagera på säkerhetsrisker i realtid. Prediktiv analys stärker ytterligare cyberförsvaret genom att identifiera sårbarheter innan attacker inträffar. Implementeringen av AI medför dock utmaningar, inklusive kontradiktoriska attacker, partiskhet och integrationskomplexitet. För att säkerställa motståndskraft är kontinuerliga framsteg inom AI-säkerhetsstrategier, såsom kontradiktorisk utbildning, förbättrad regelefterlevnad och adaptiva inlärningsmodeller, avgörande. I takt med att cyberhoten utvecklas kommer AI att spela en allt viktigare roll för att skydda maritima operationer samtidigt som den förbättrar den operativa effektiviteten och säkerheten.


